←
页码
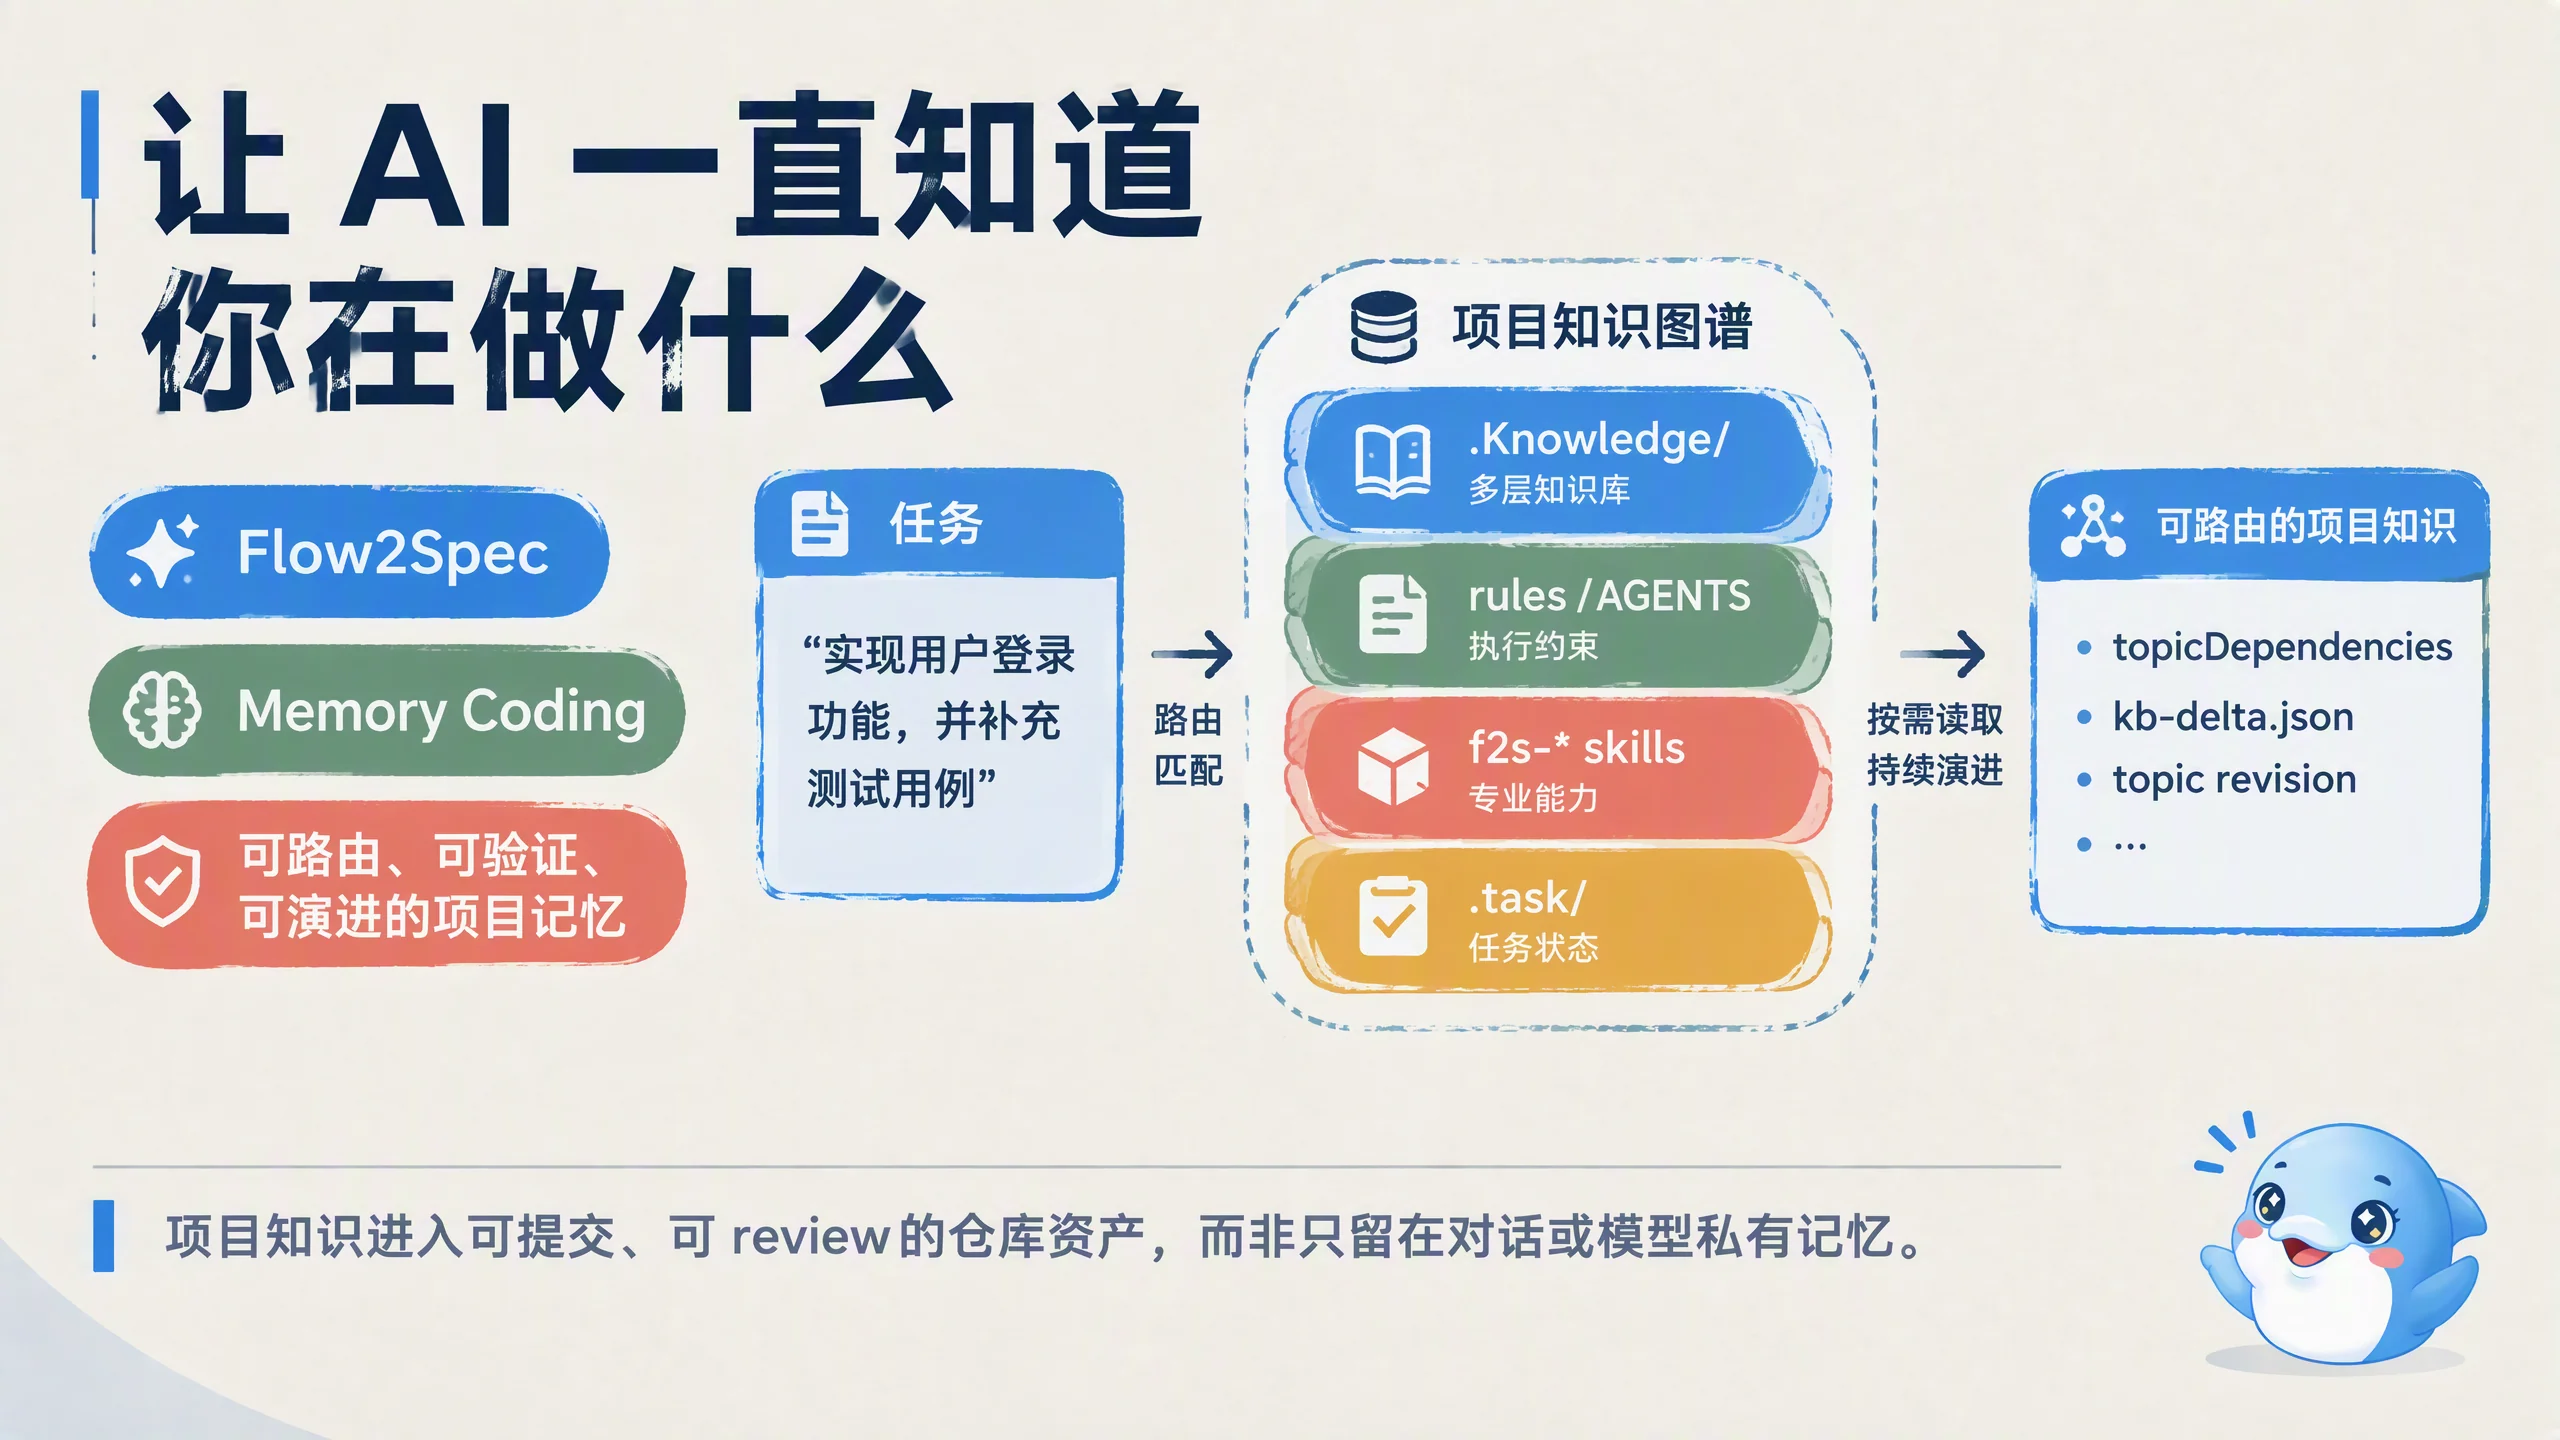
1 / 40 · 让 AI 一直知道你在做什么
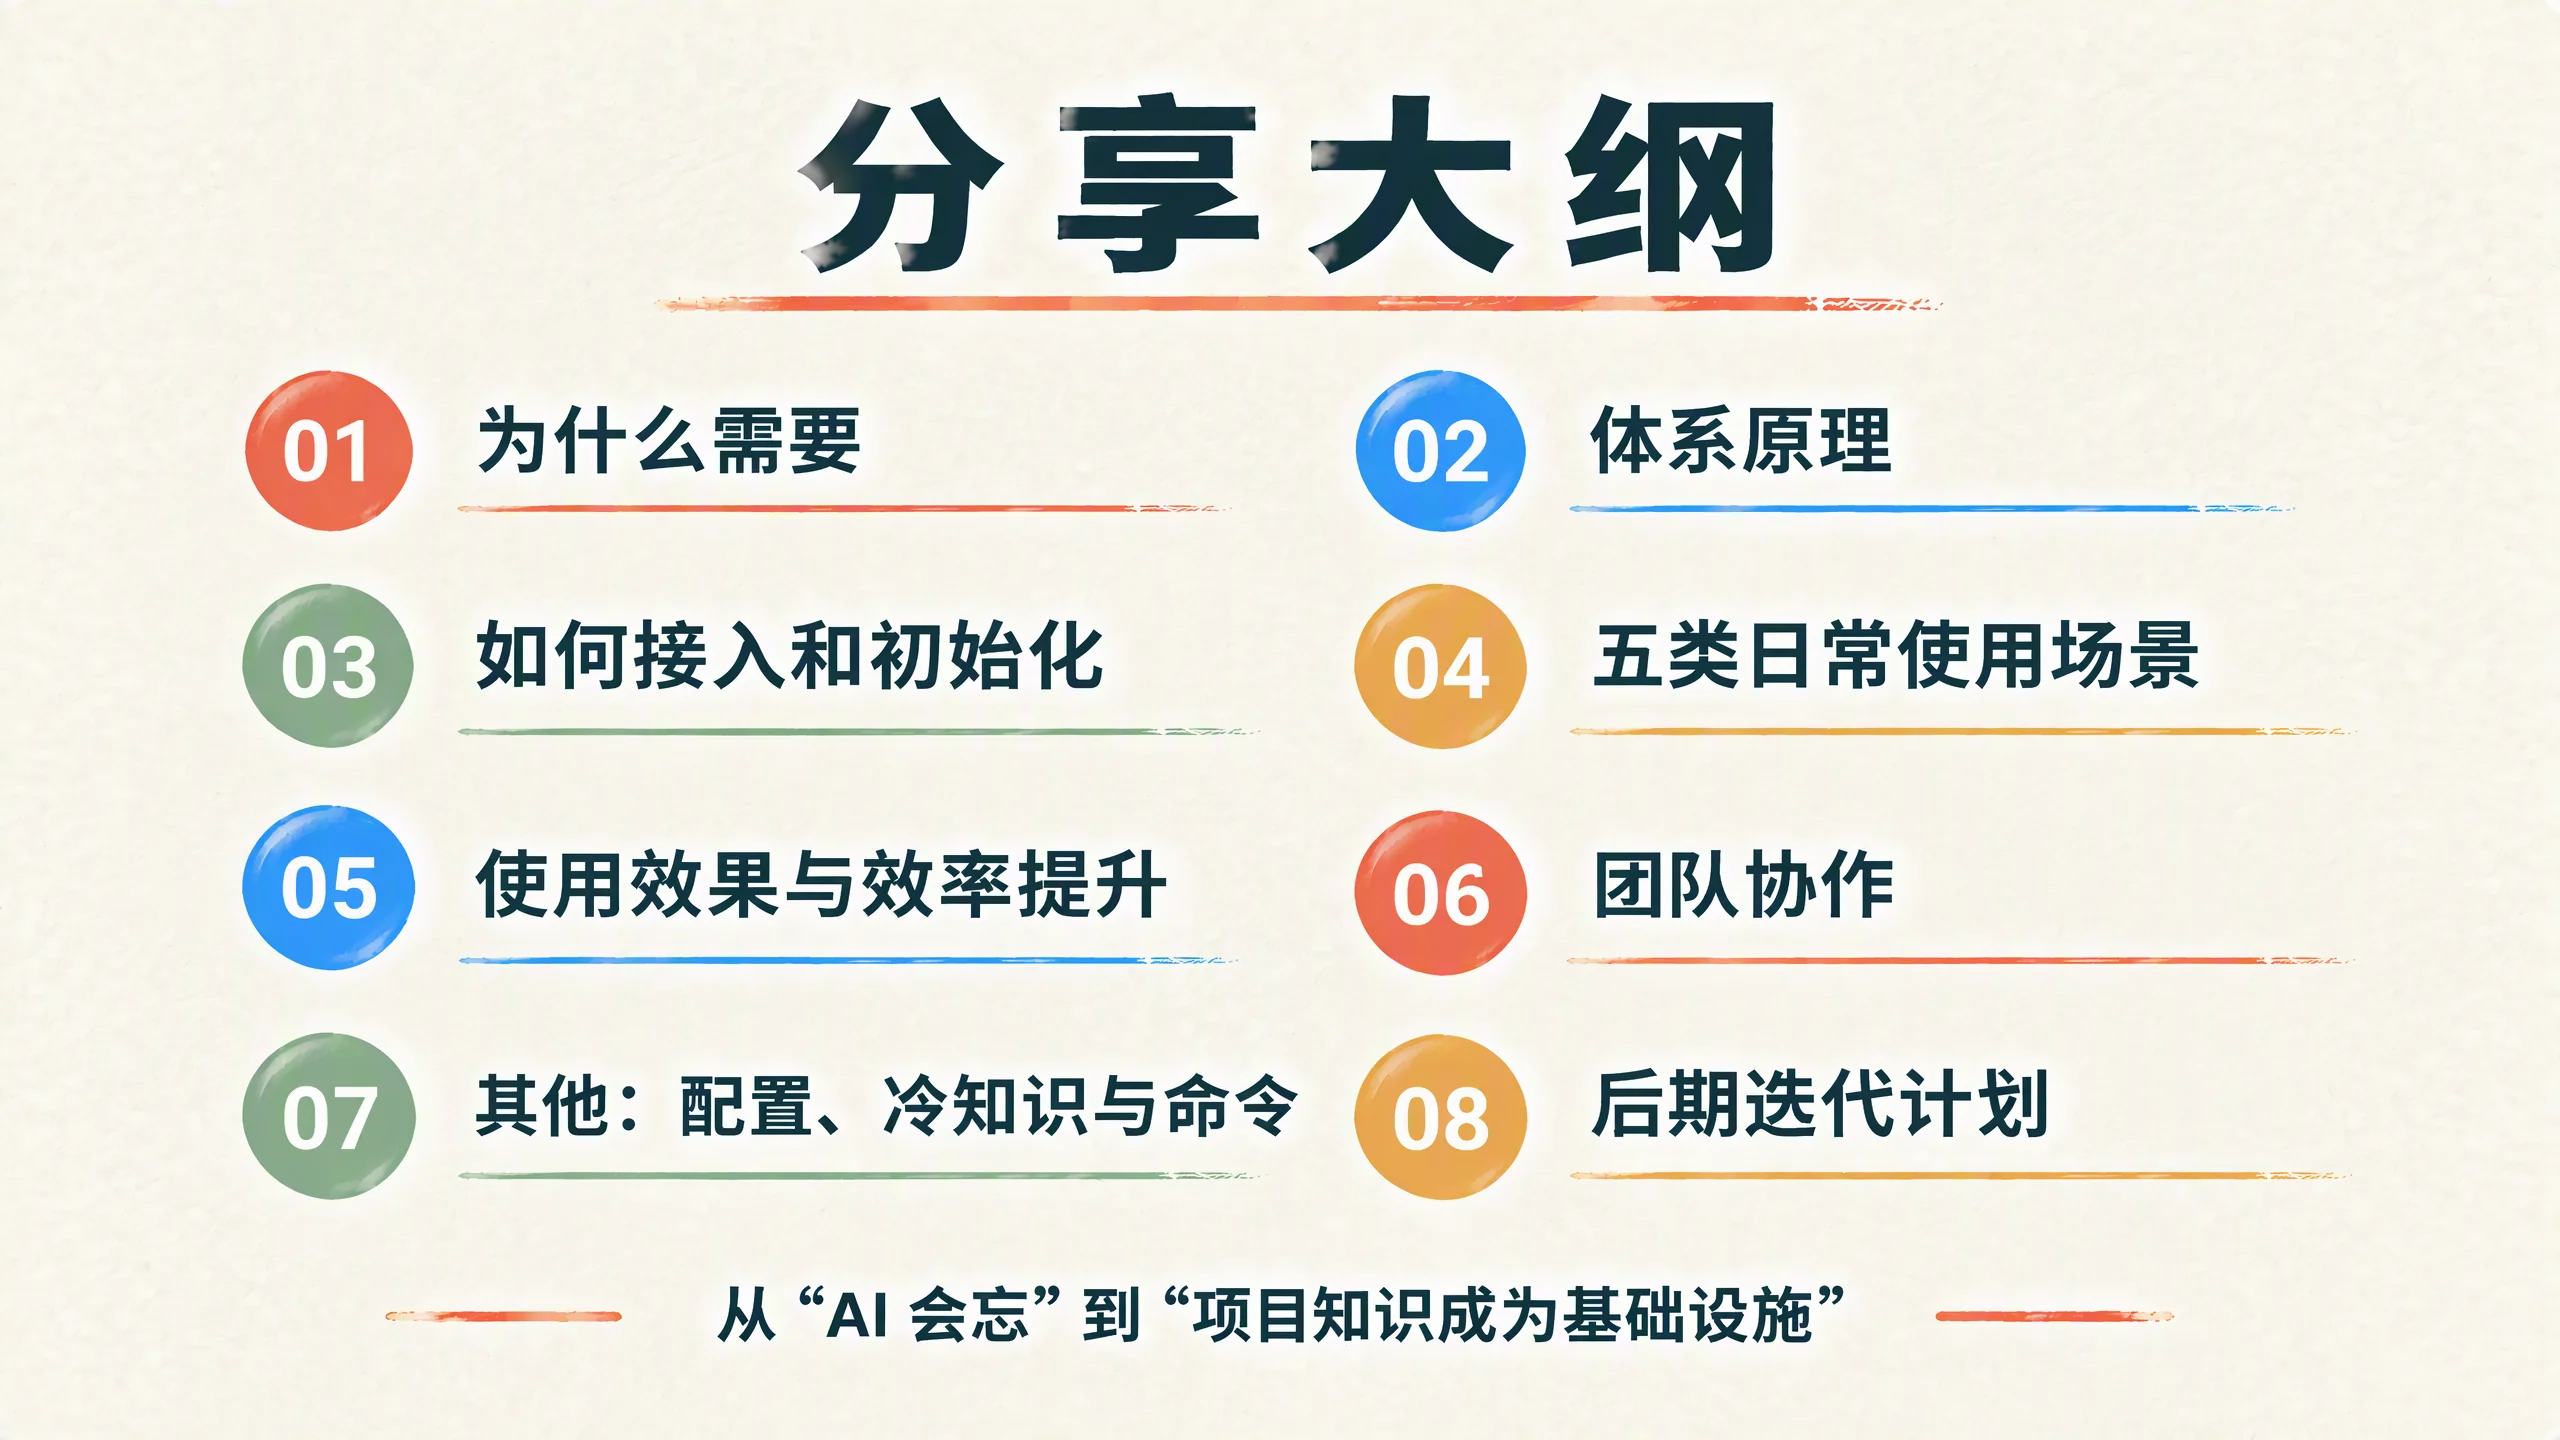
2 / 40 · 分享大纲
3 / 40 · 为什么需要
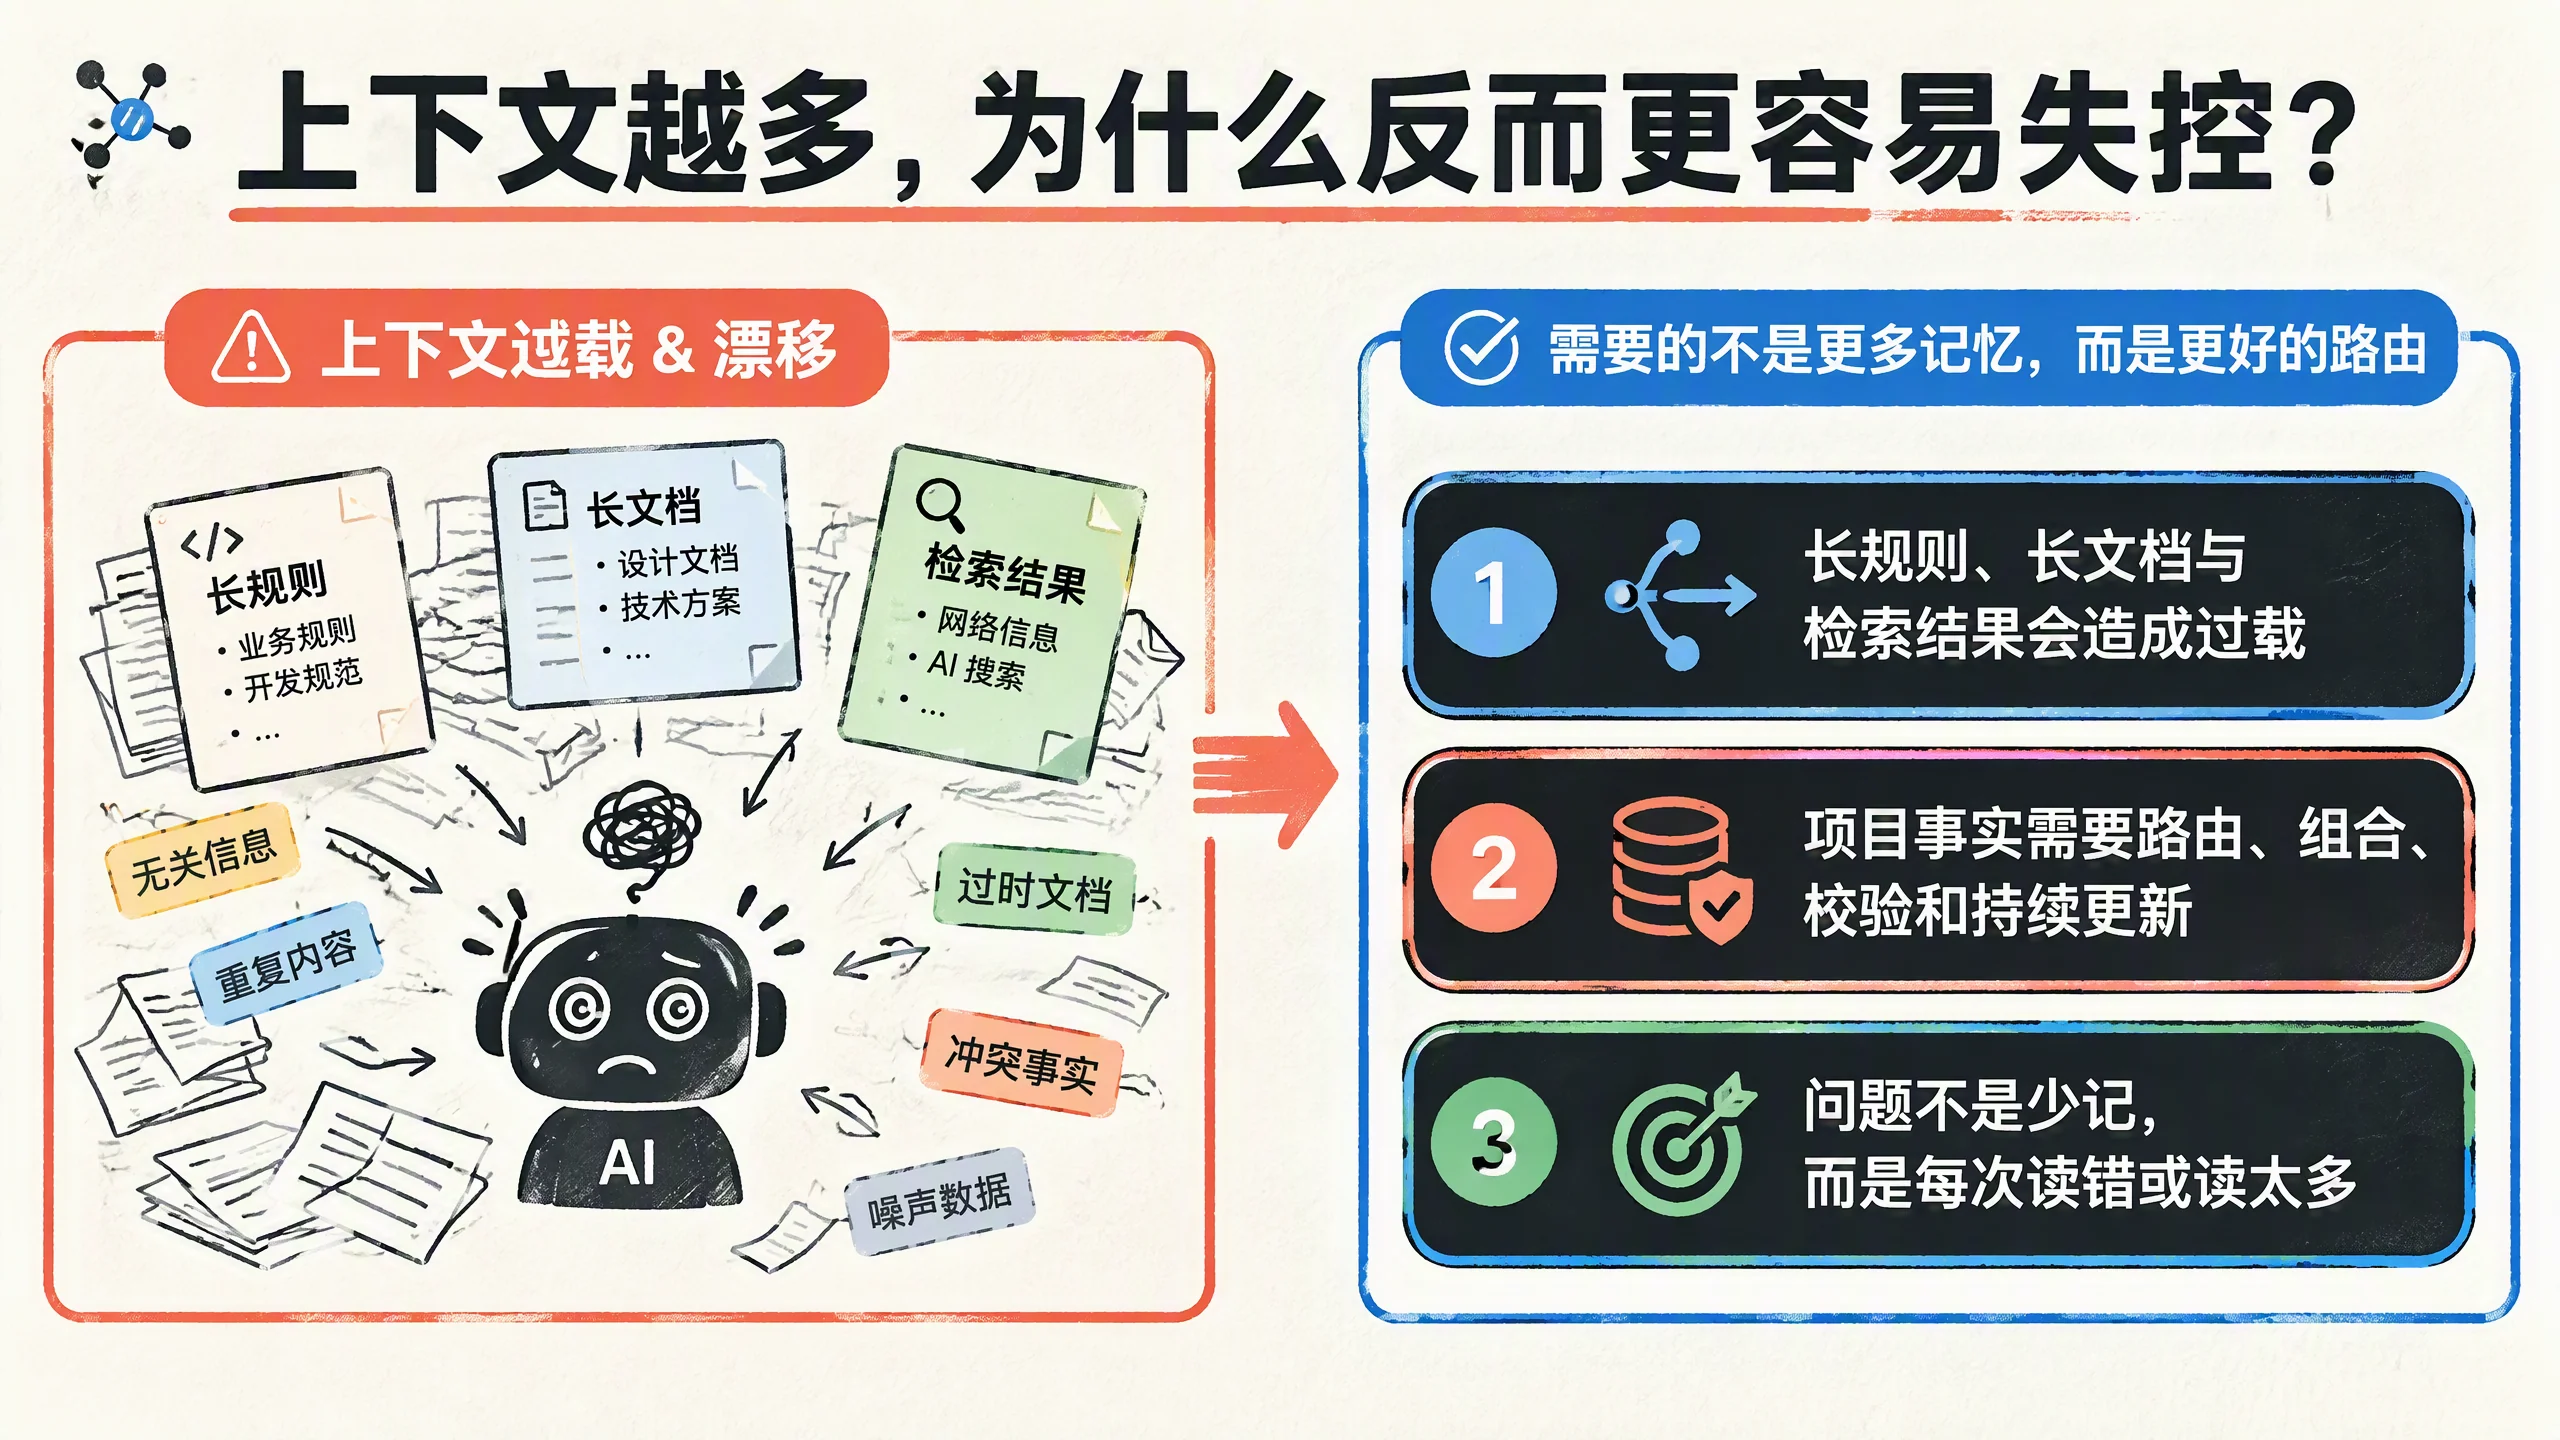
4 / 40 · 上下文越多,为什么反而更容易失控?
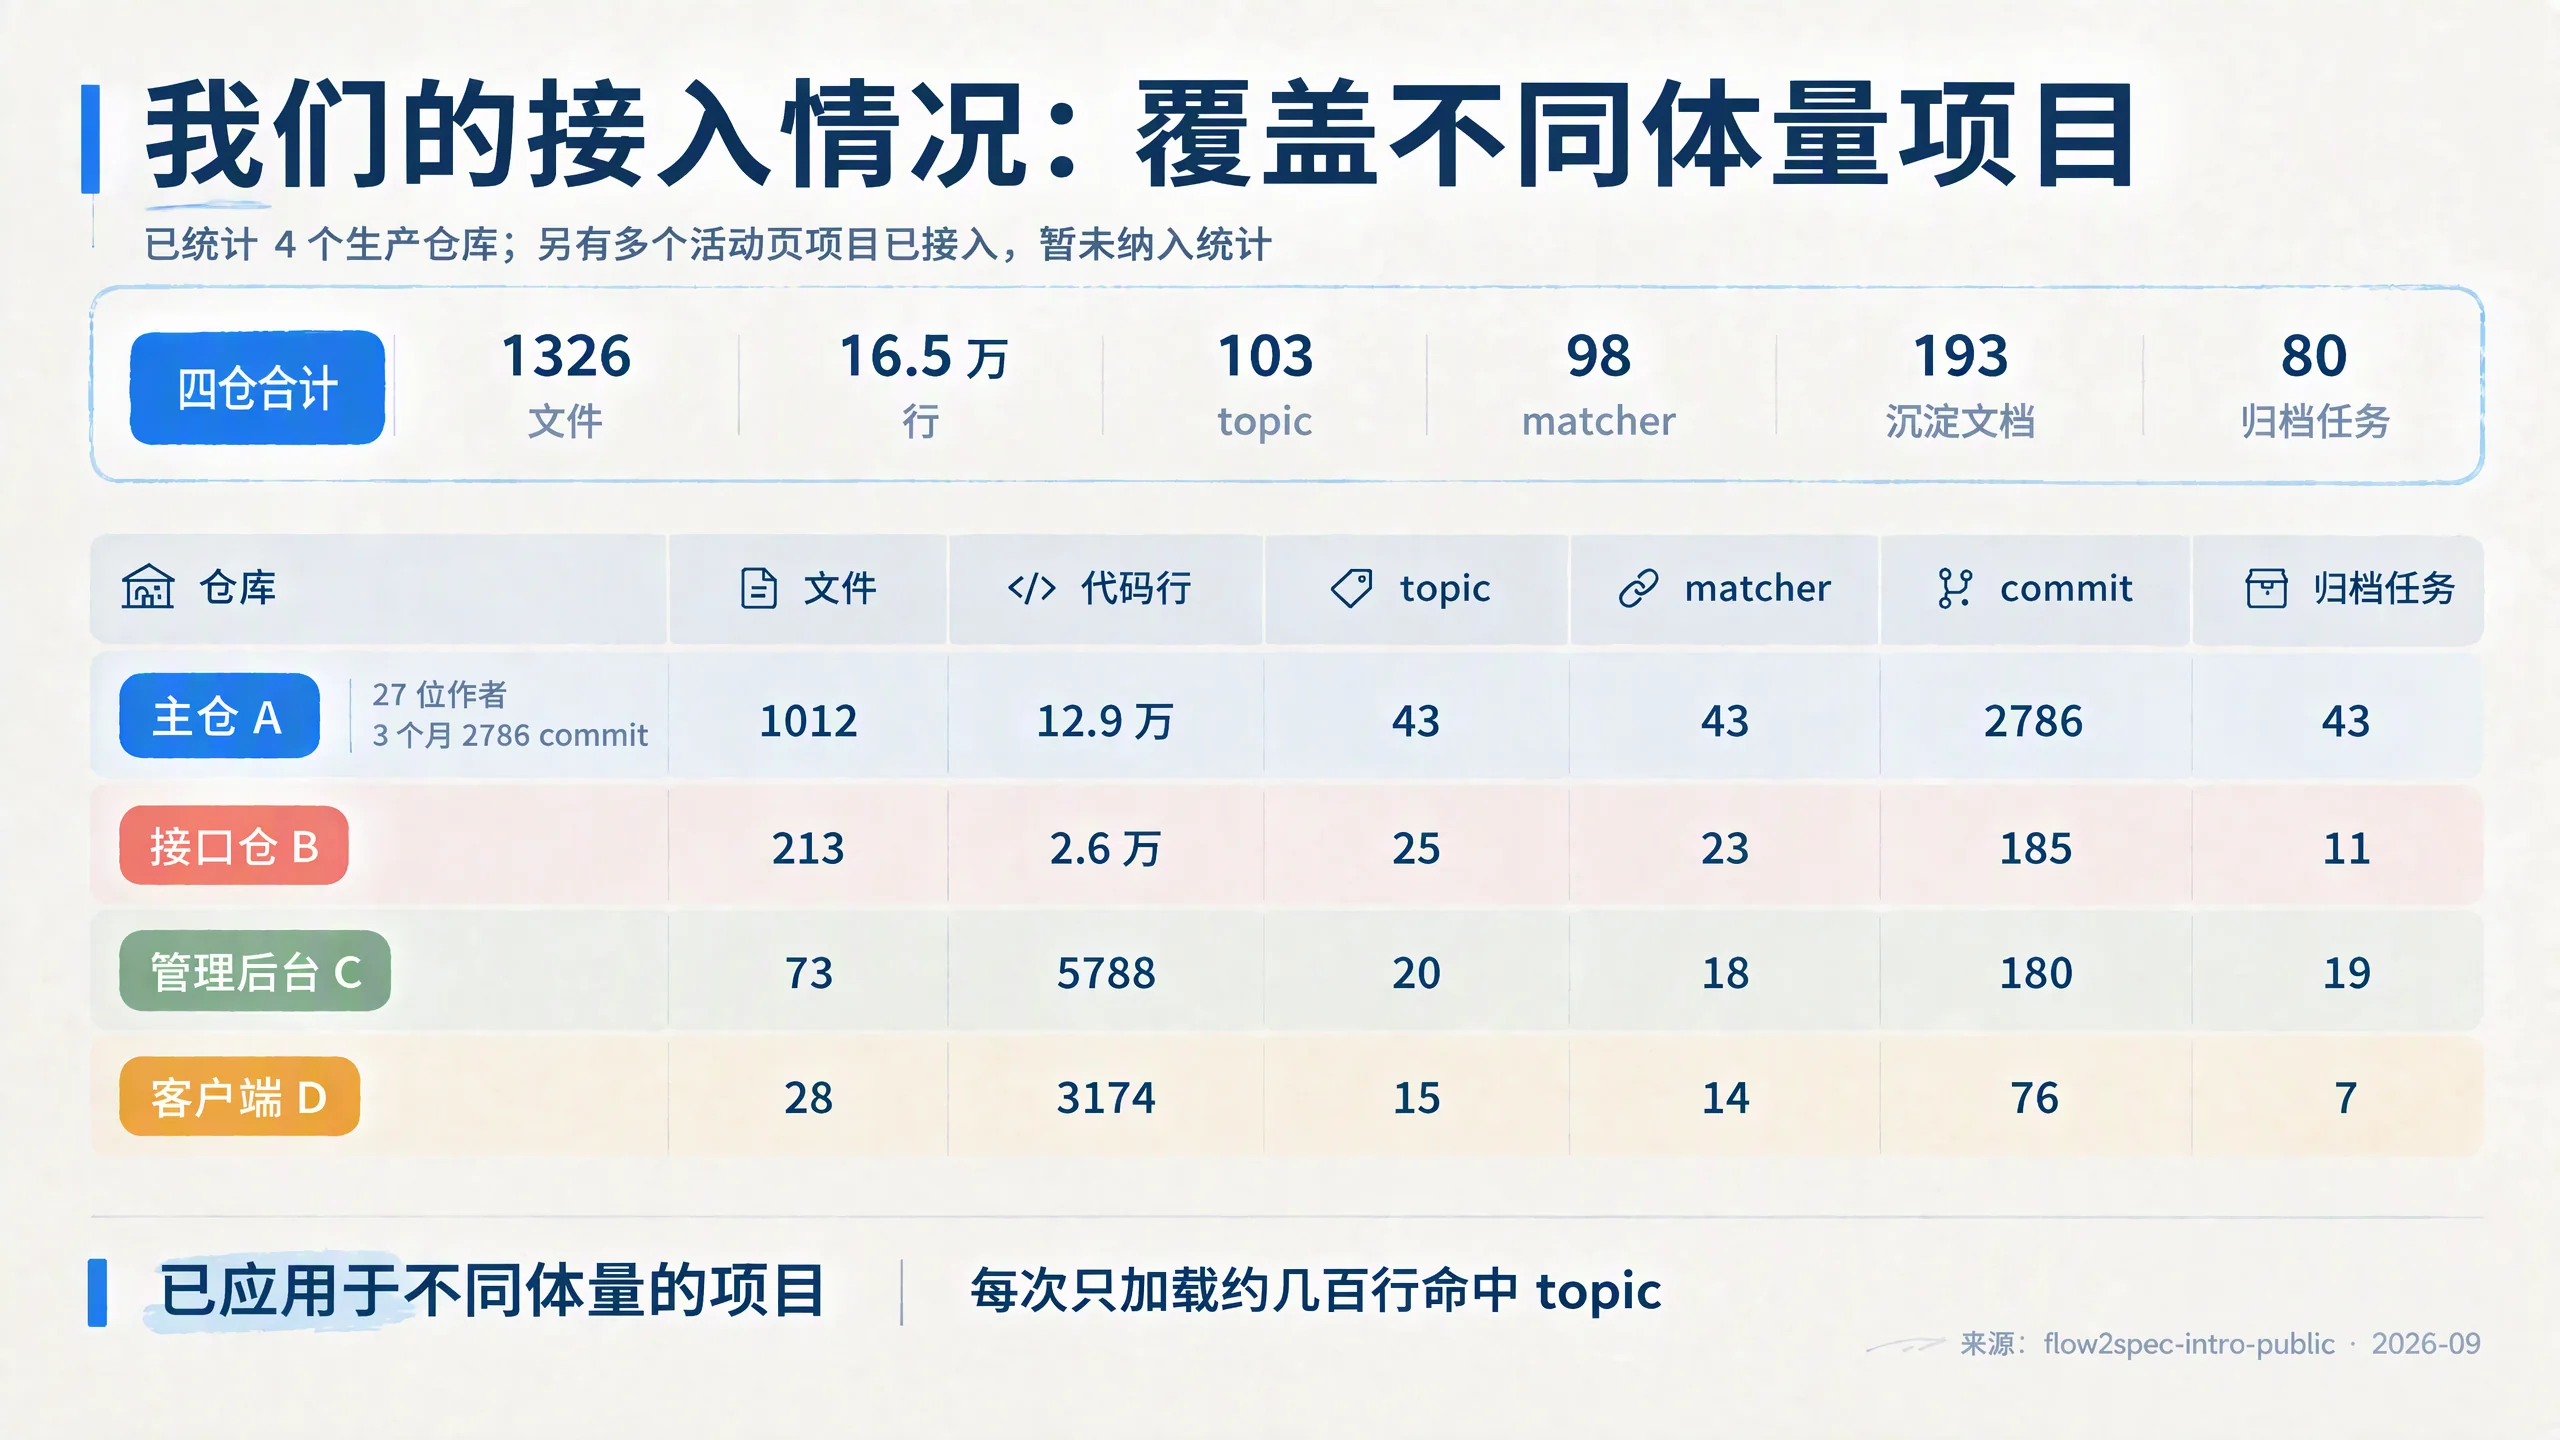
5 / 40 · 我们的接入情况:覆盖不同体量项目
6 / 40 · 体系原理
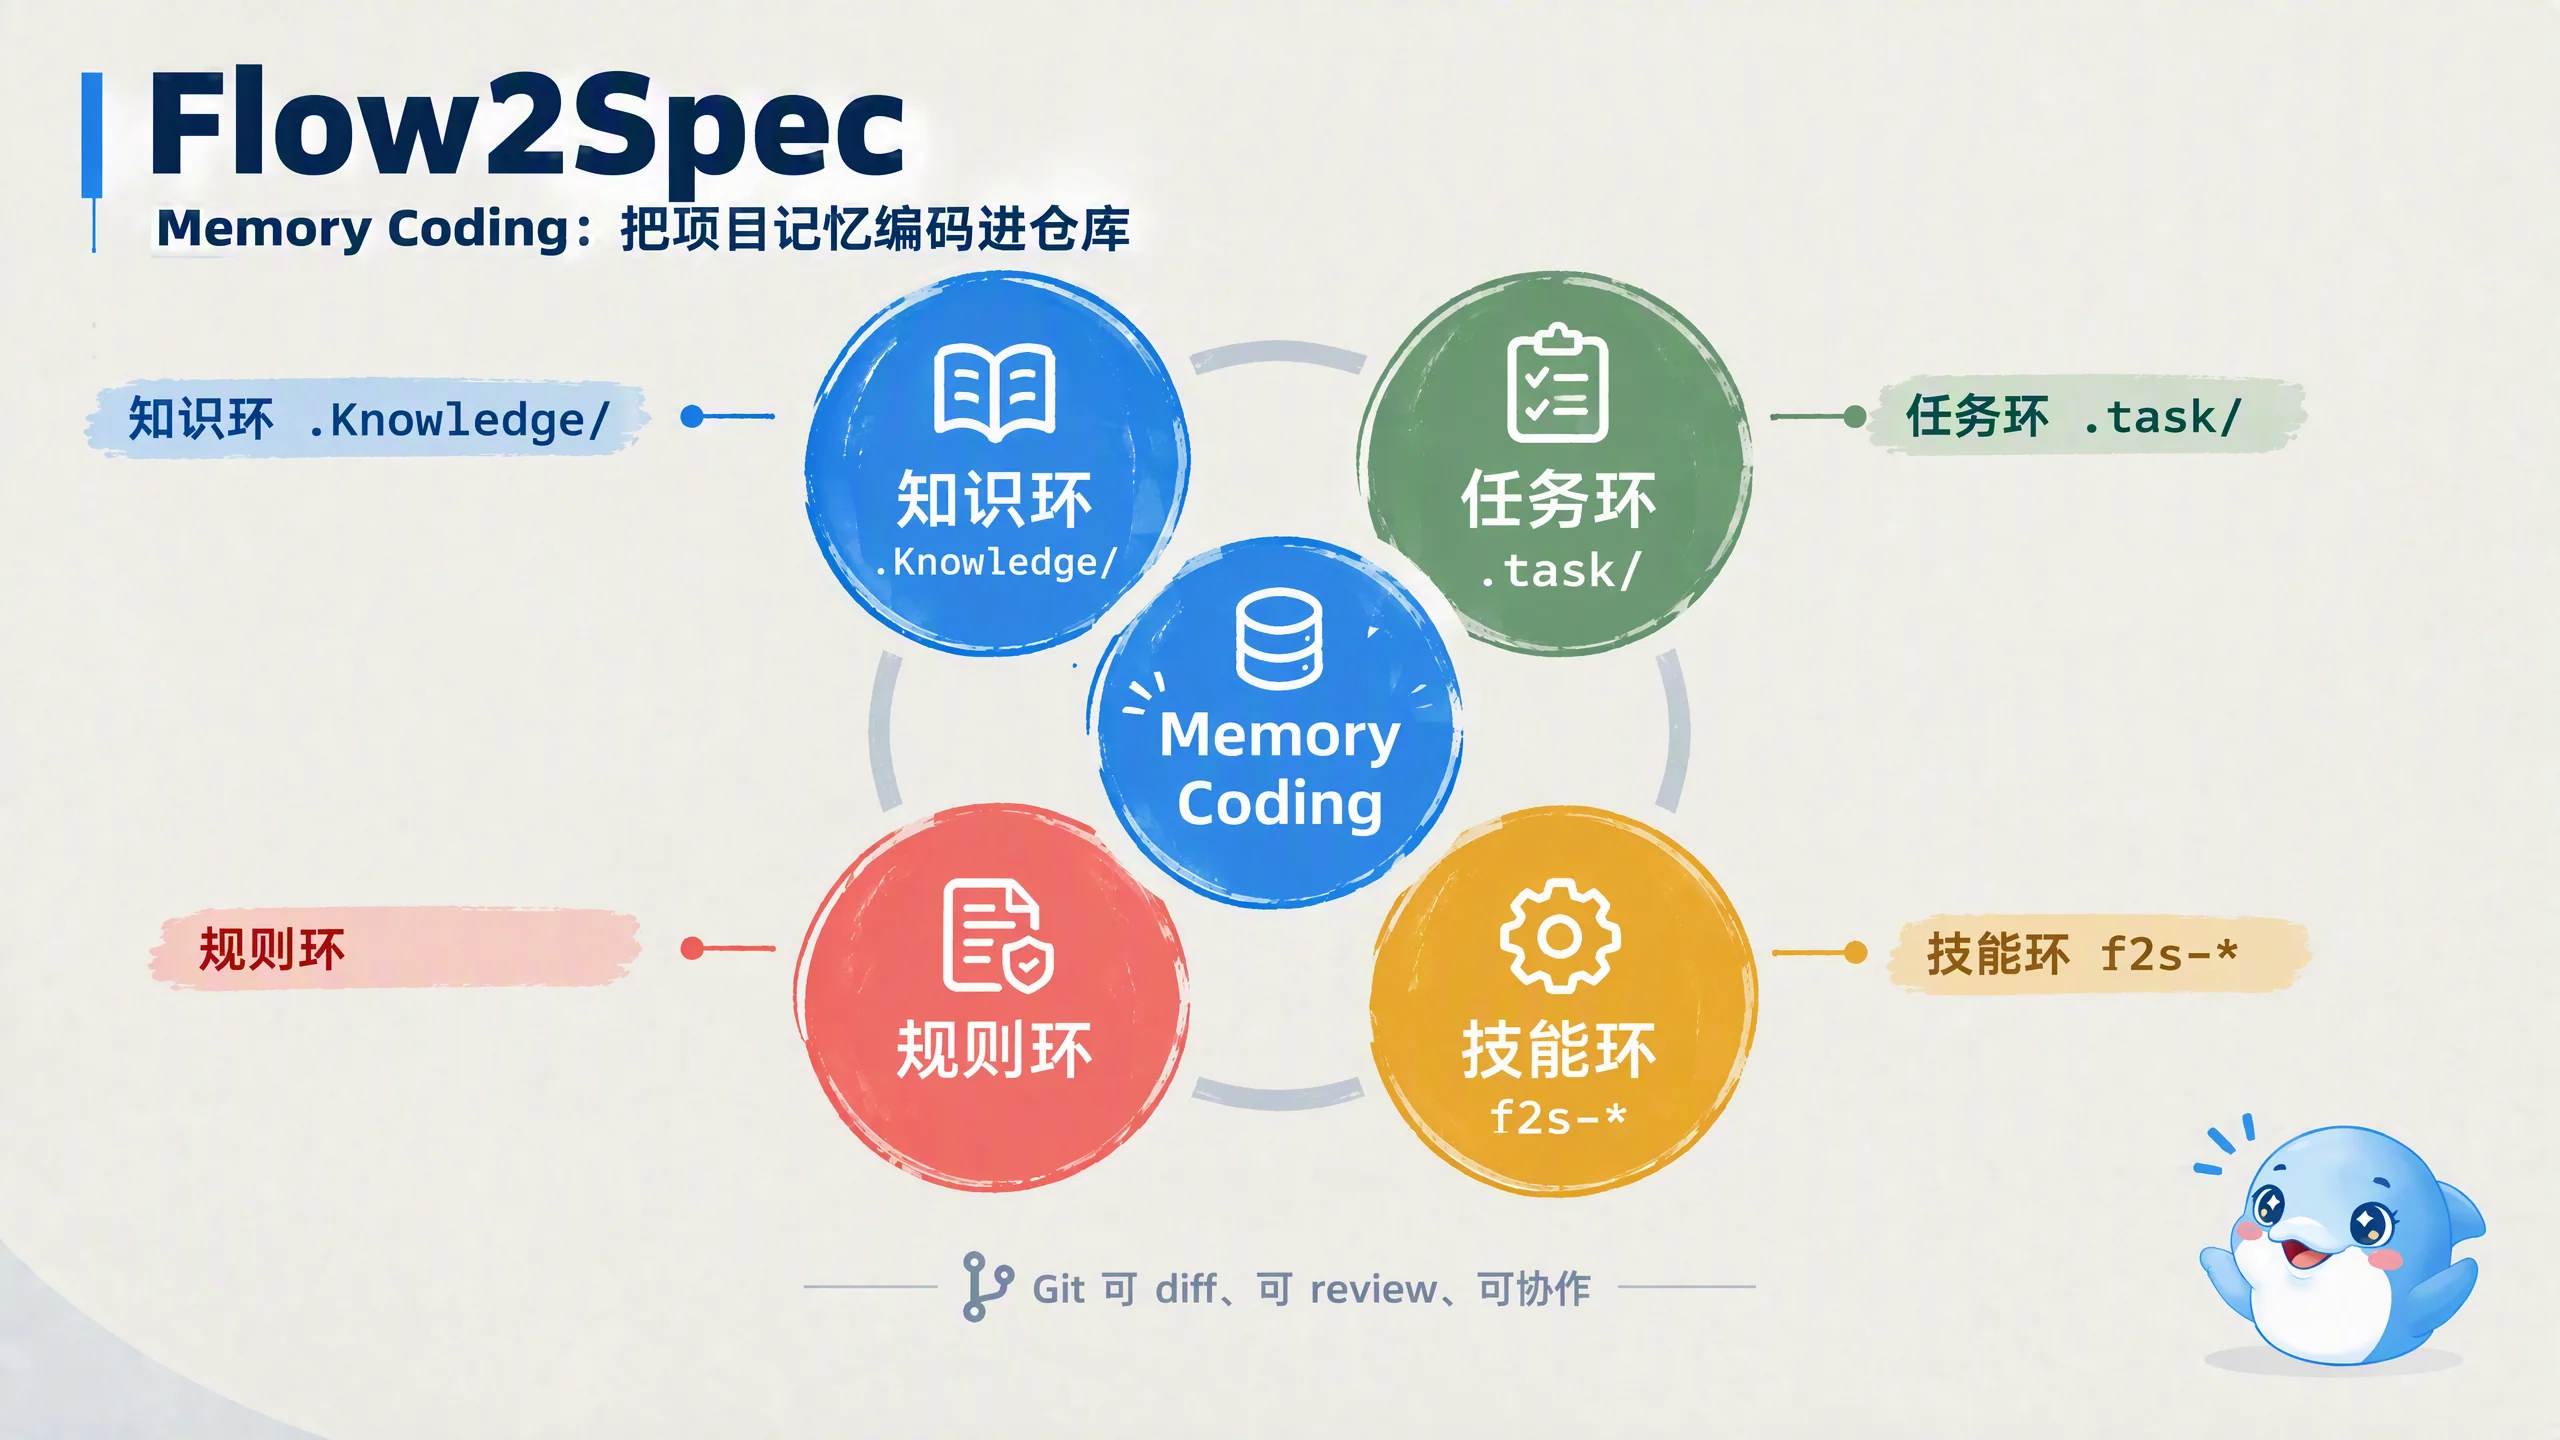
7 / 40 · Flow2Spec
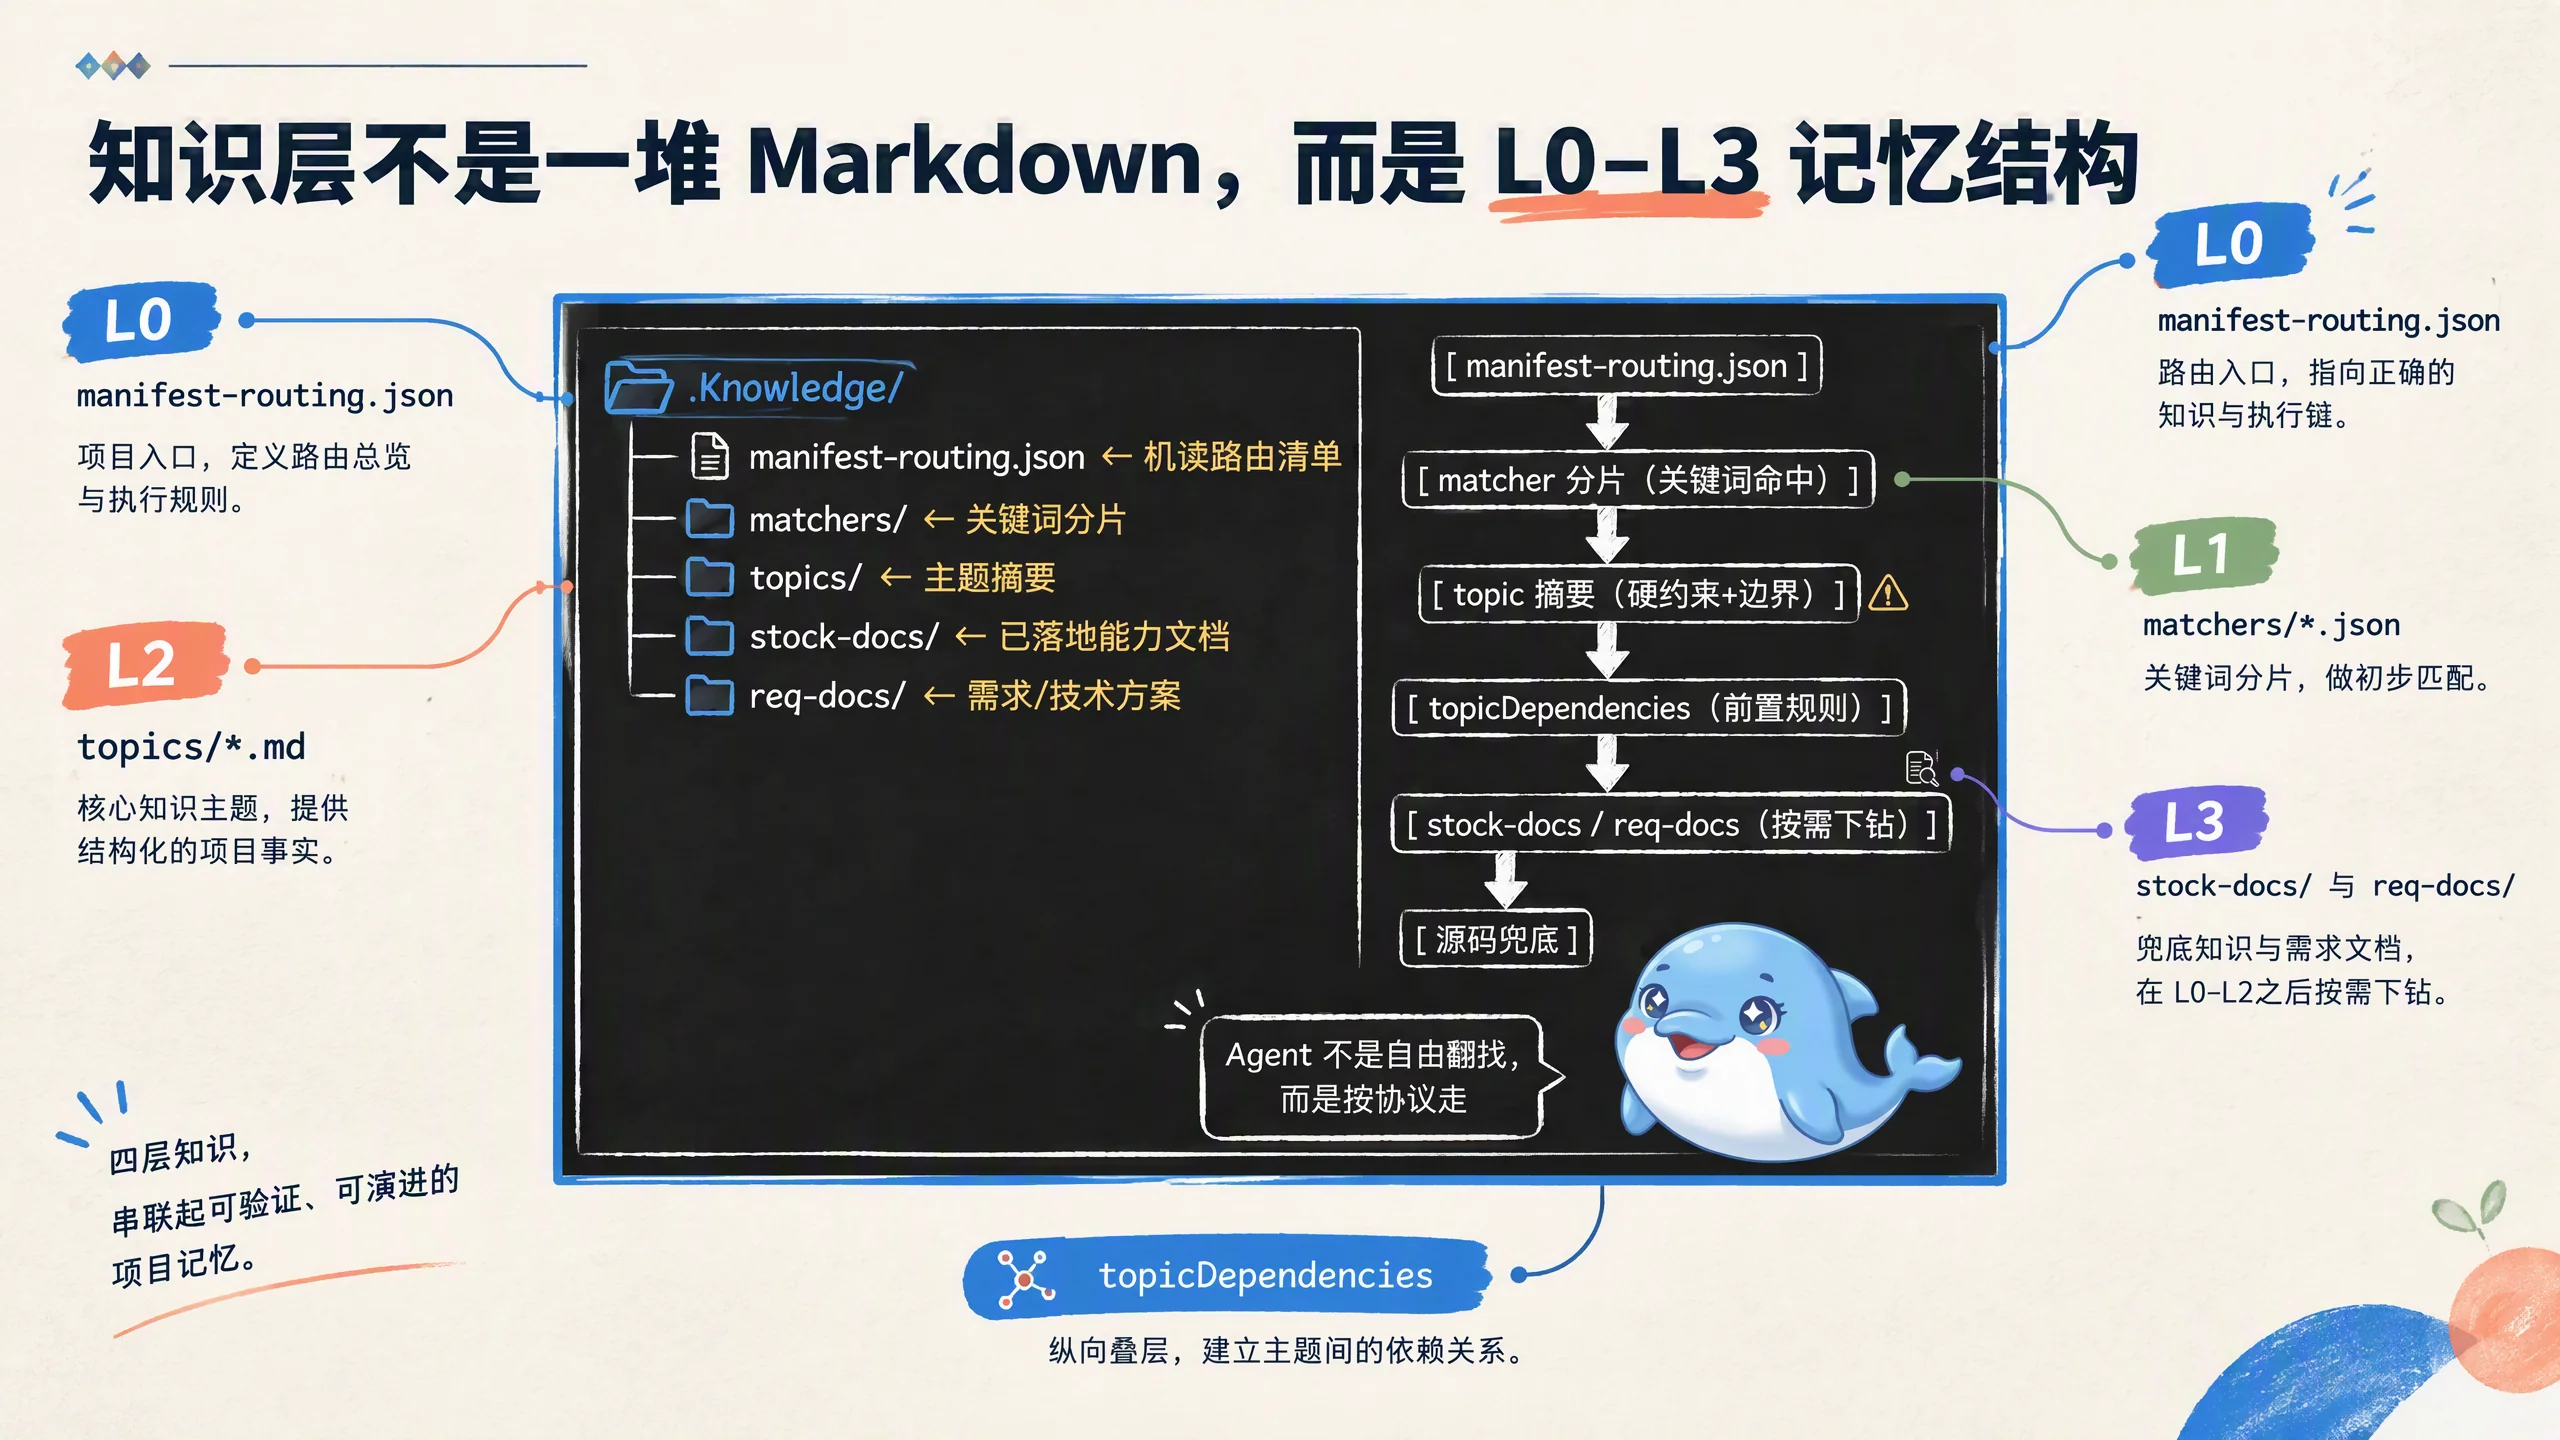
8 / 40 · 知识层不是一堆 Markdown,而是 L0–L3 记忆结构
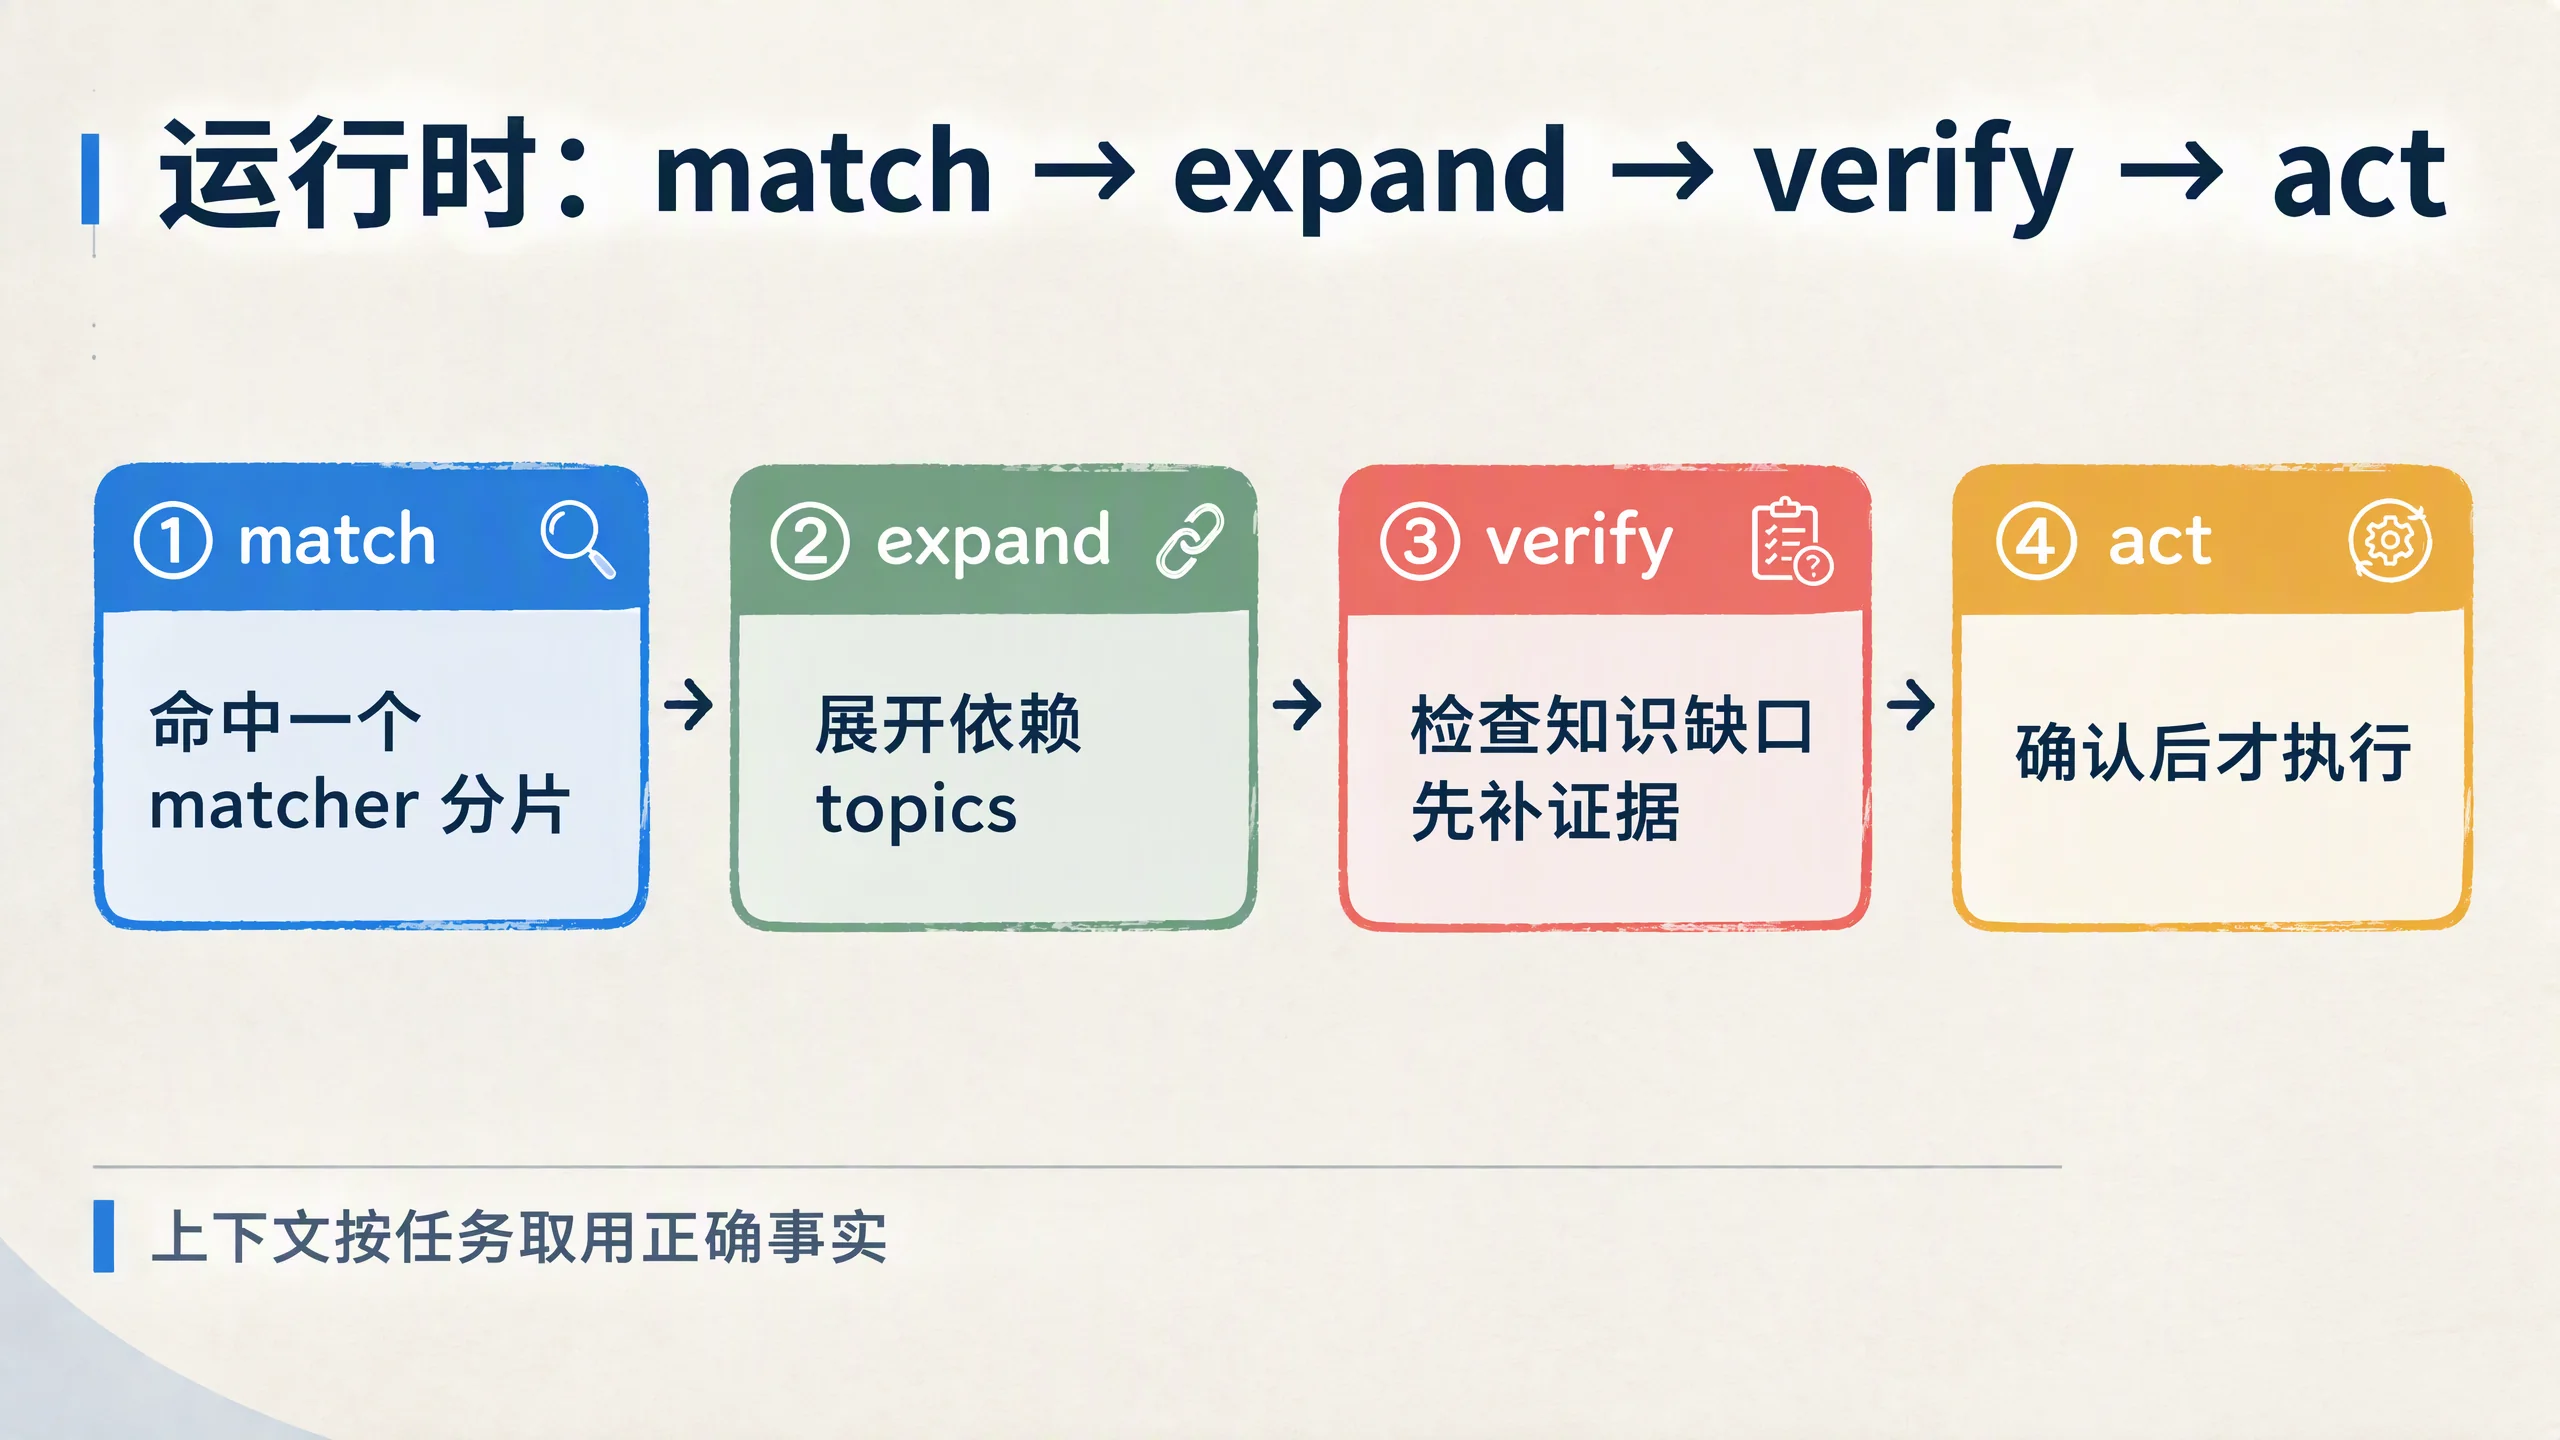
9 / 40 · 运行时:match → expand → verify → act
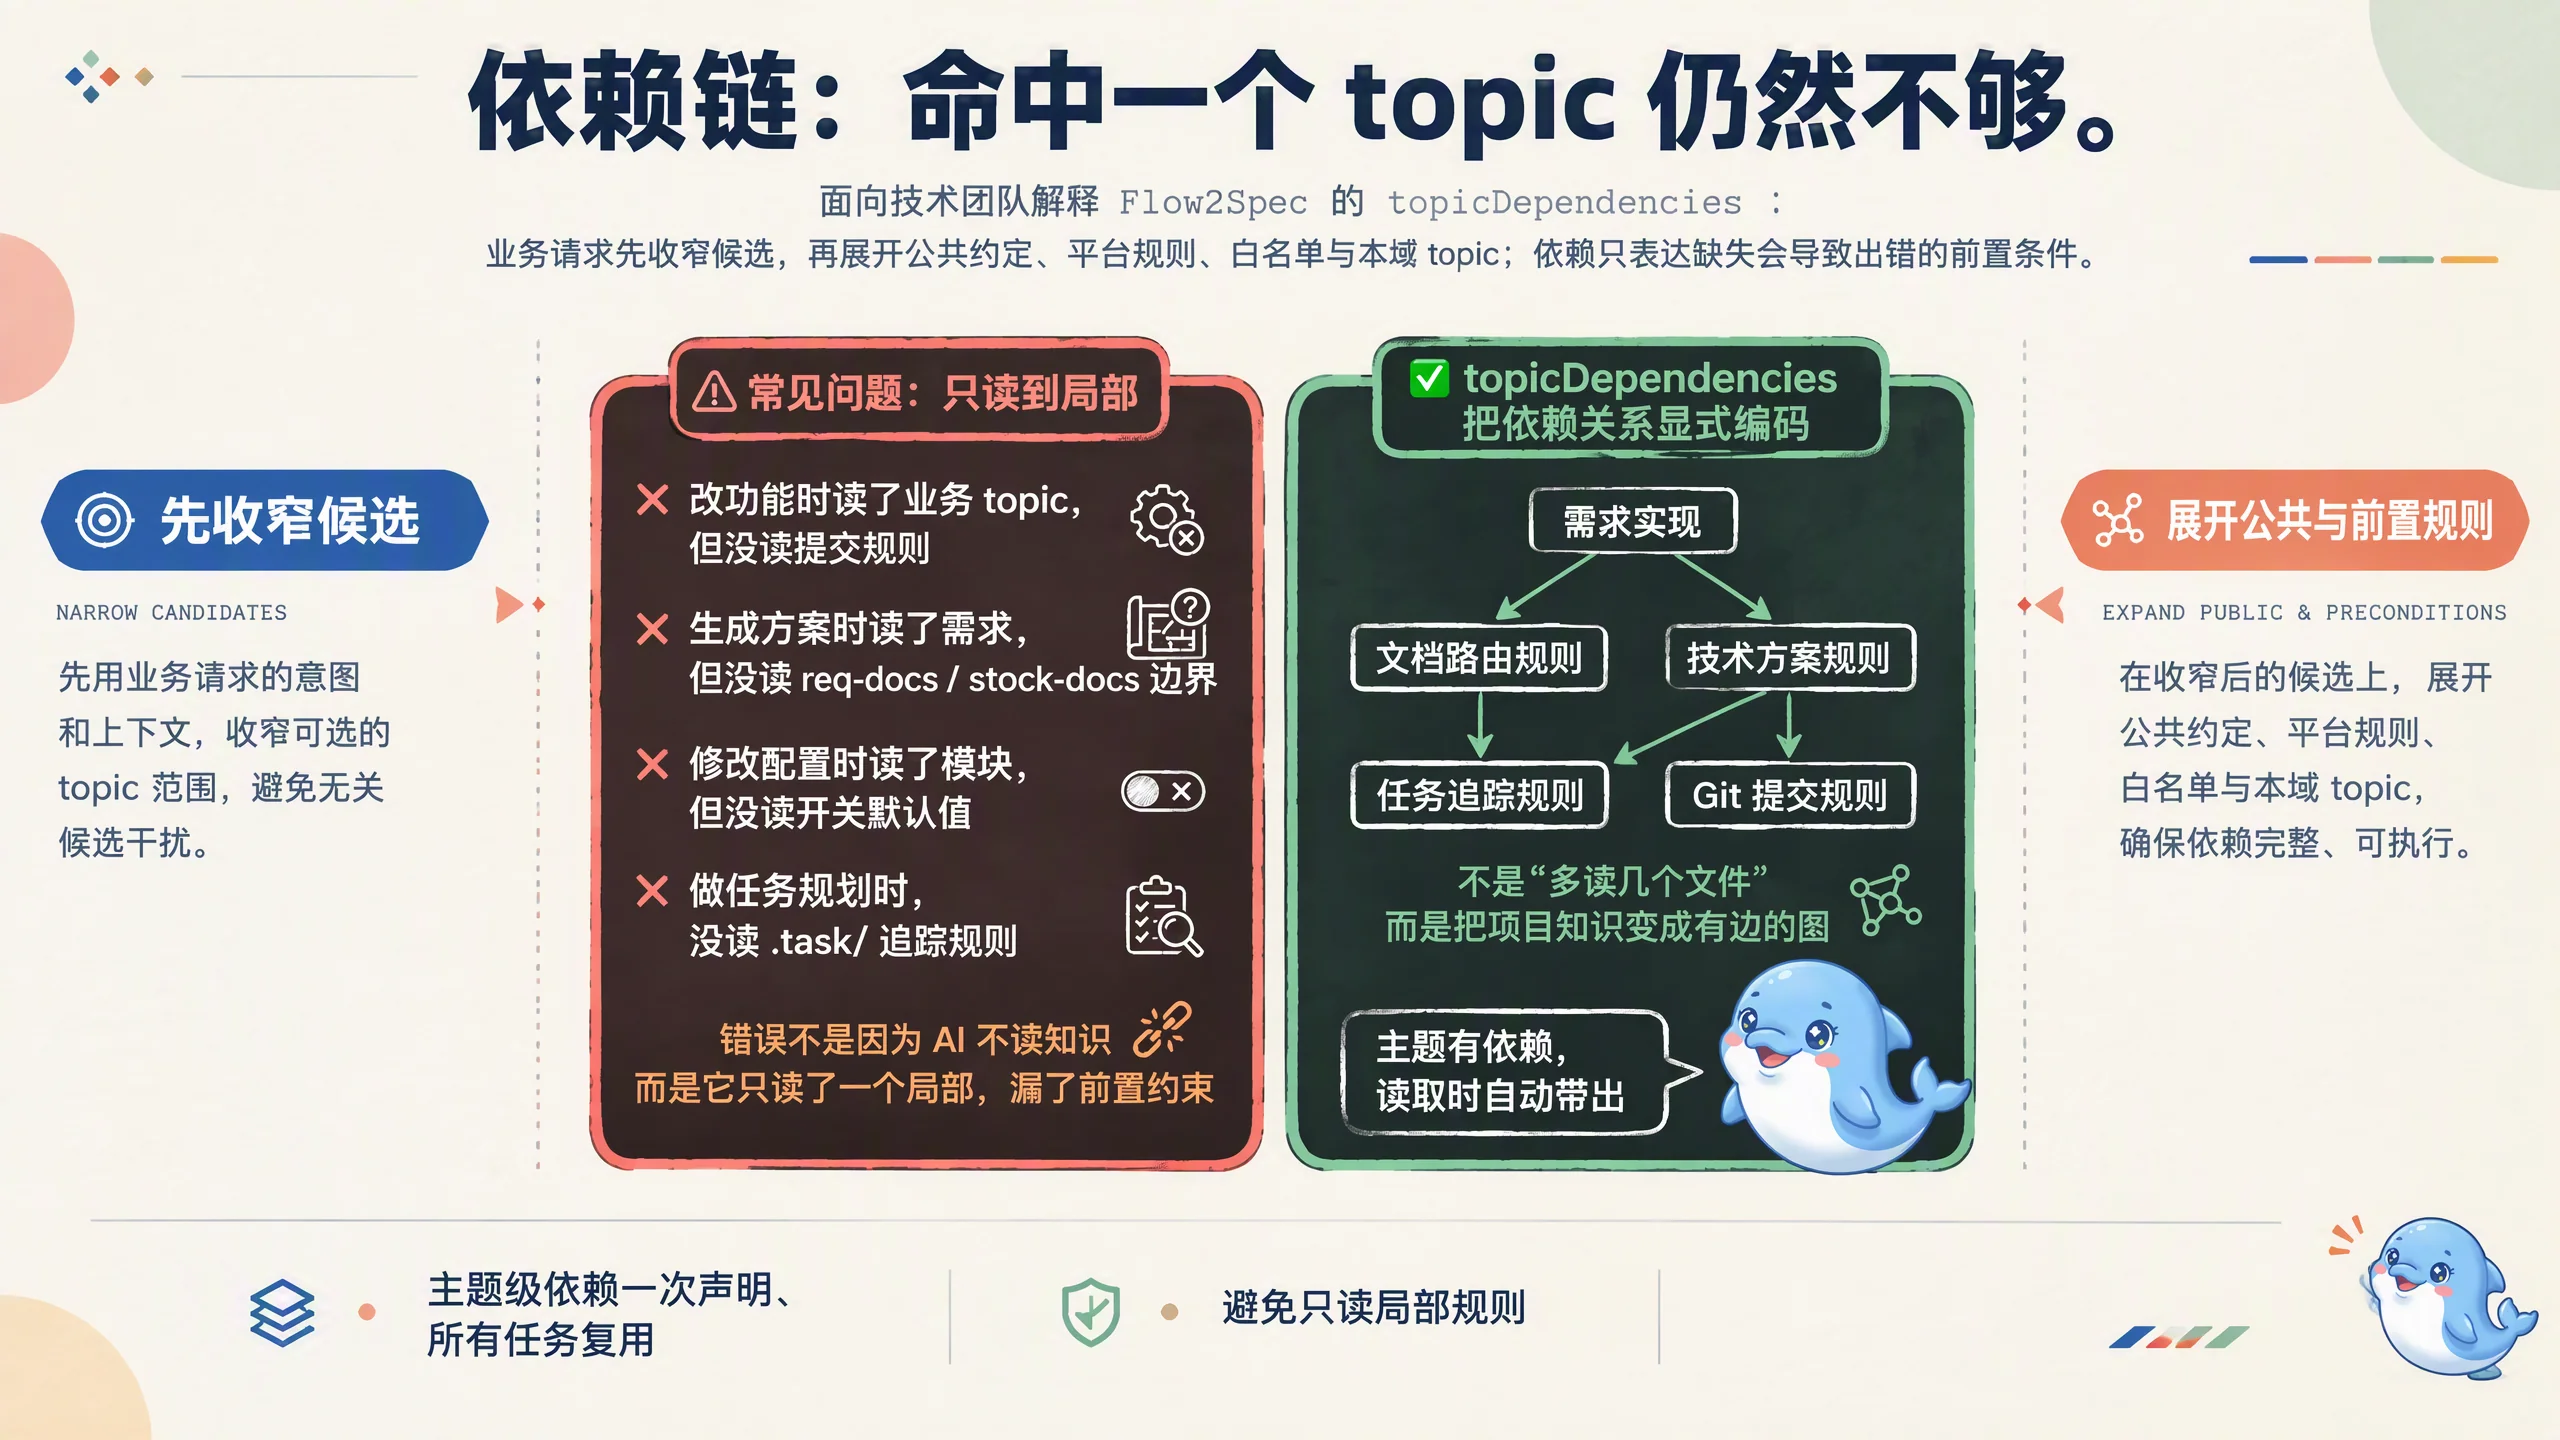
10 / 40 · 依赖链:命中一个 topic 仍然不够
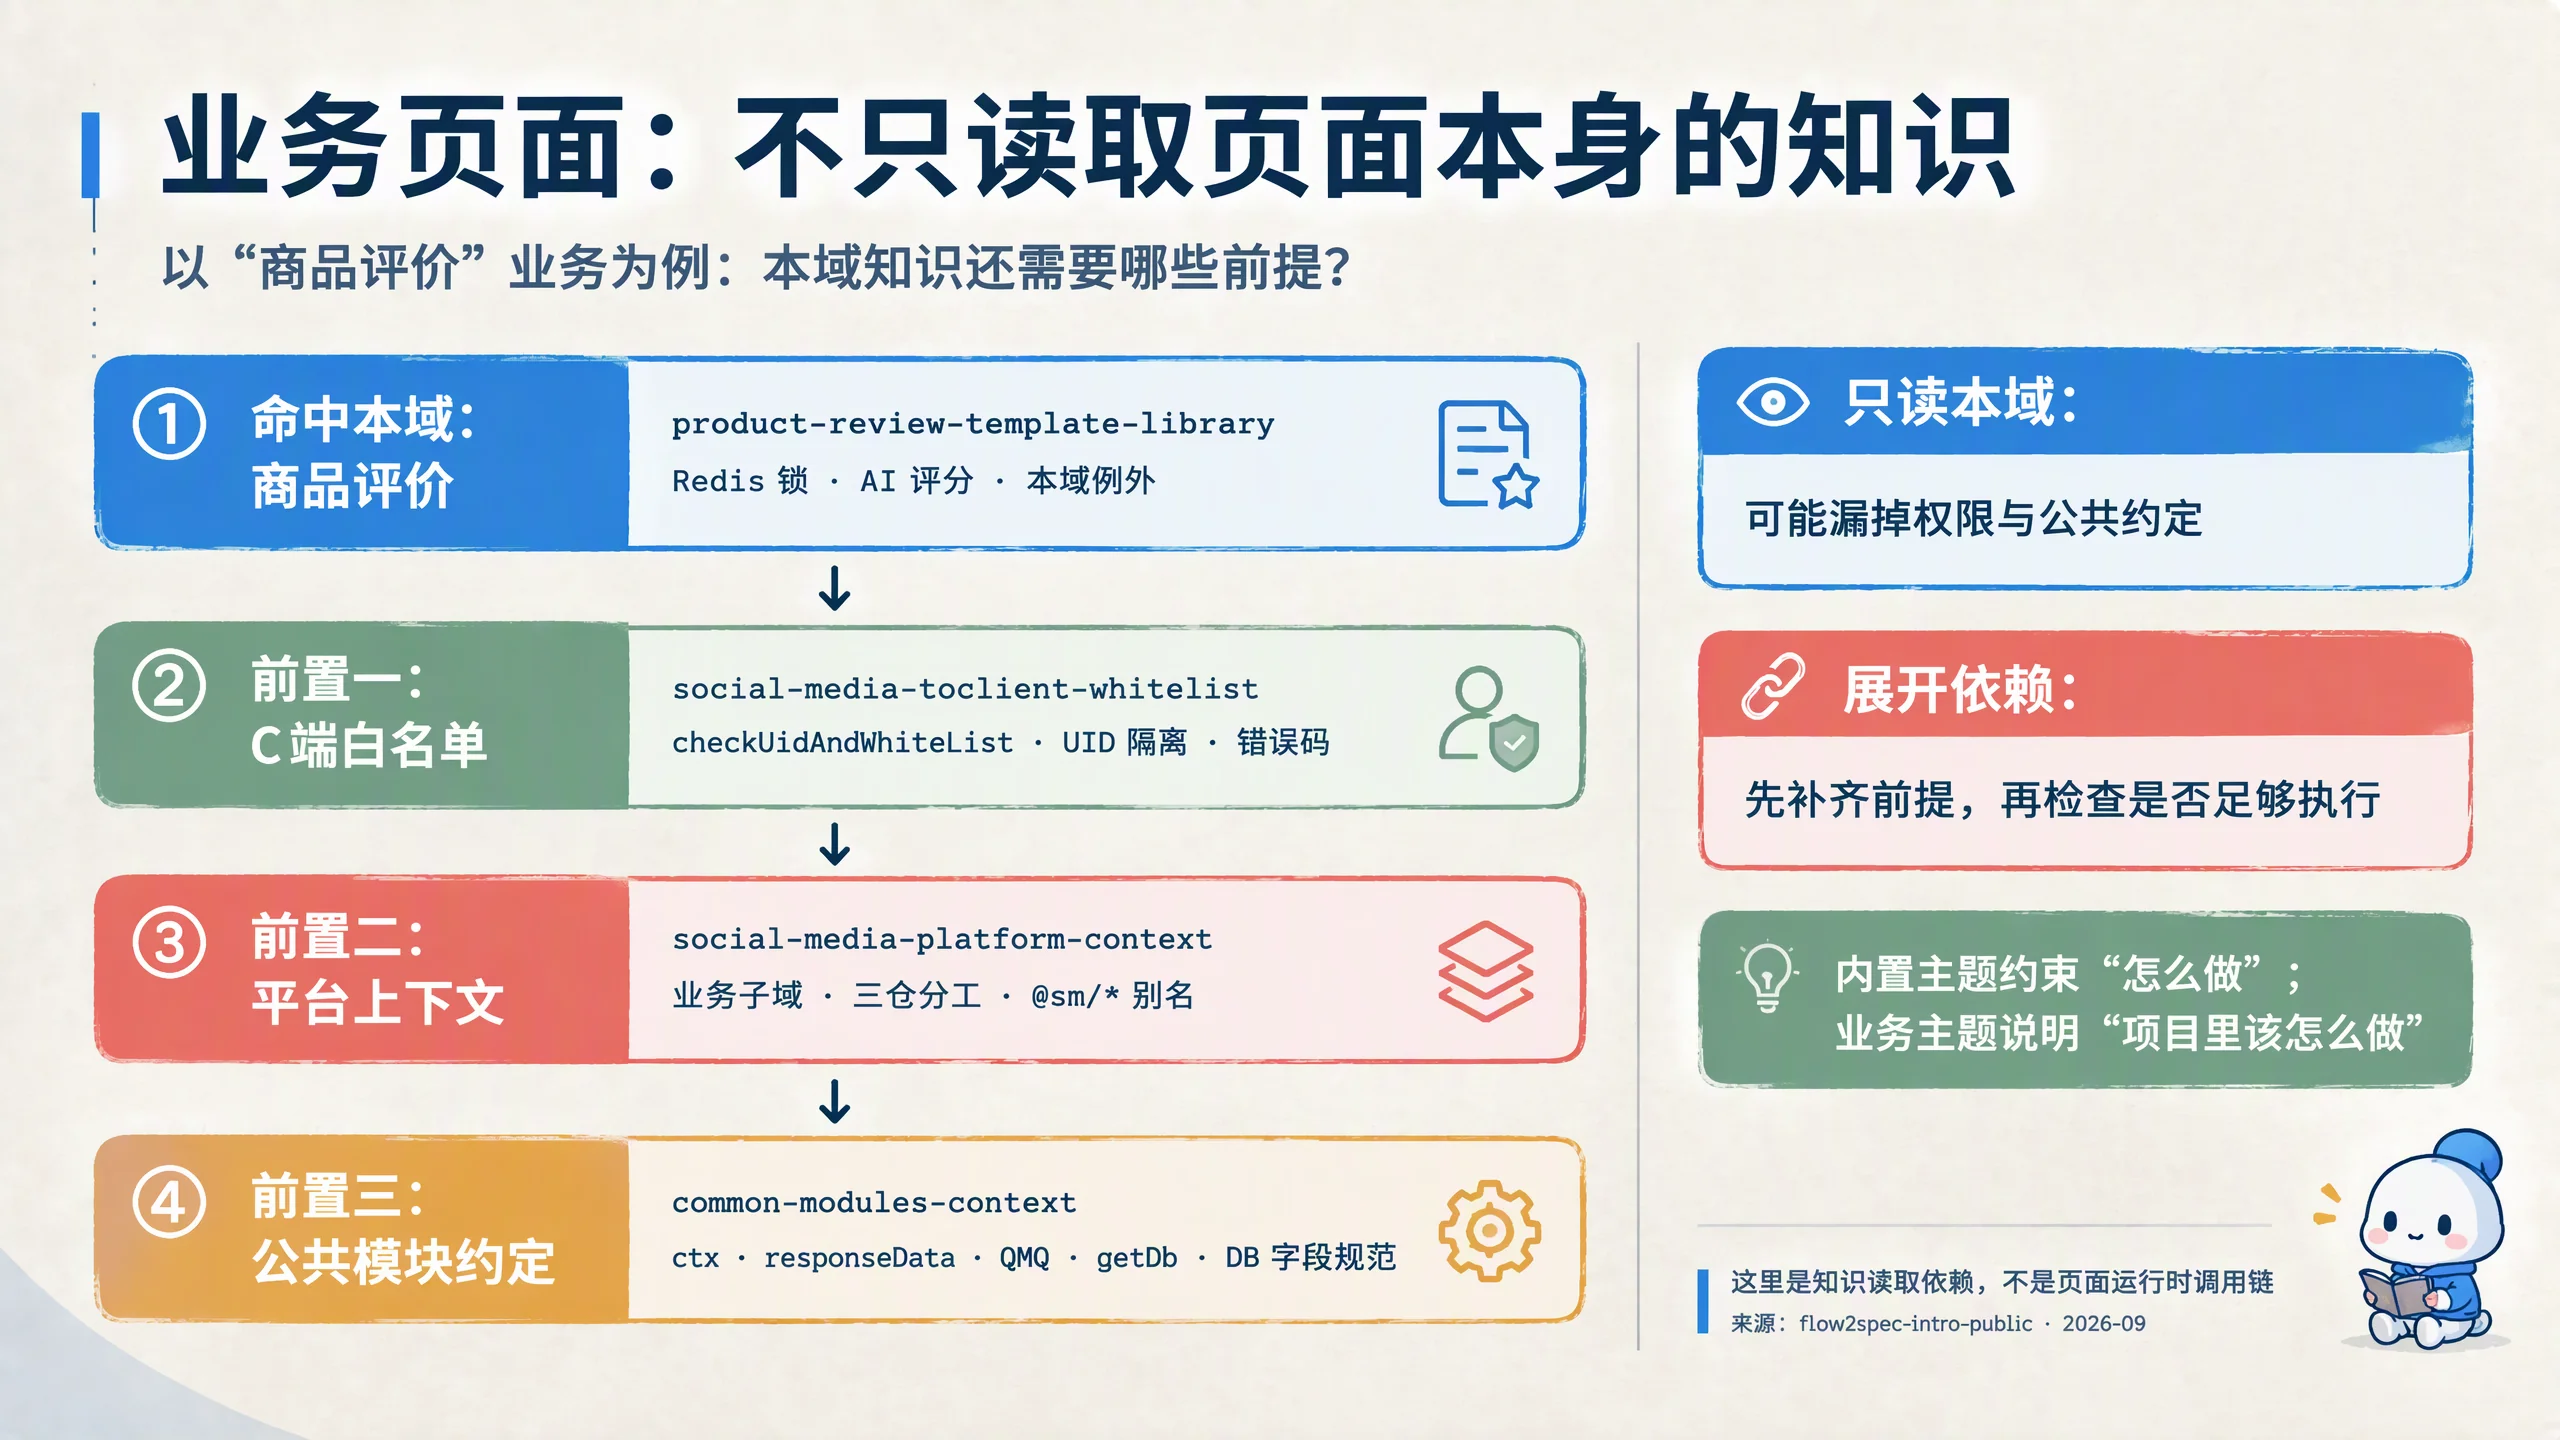
11 / 40 · 业务页面:不只读取页面本身的知识
12 / 40 · 如何接入和初始化
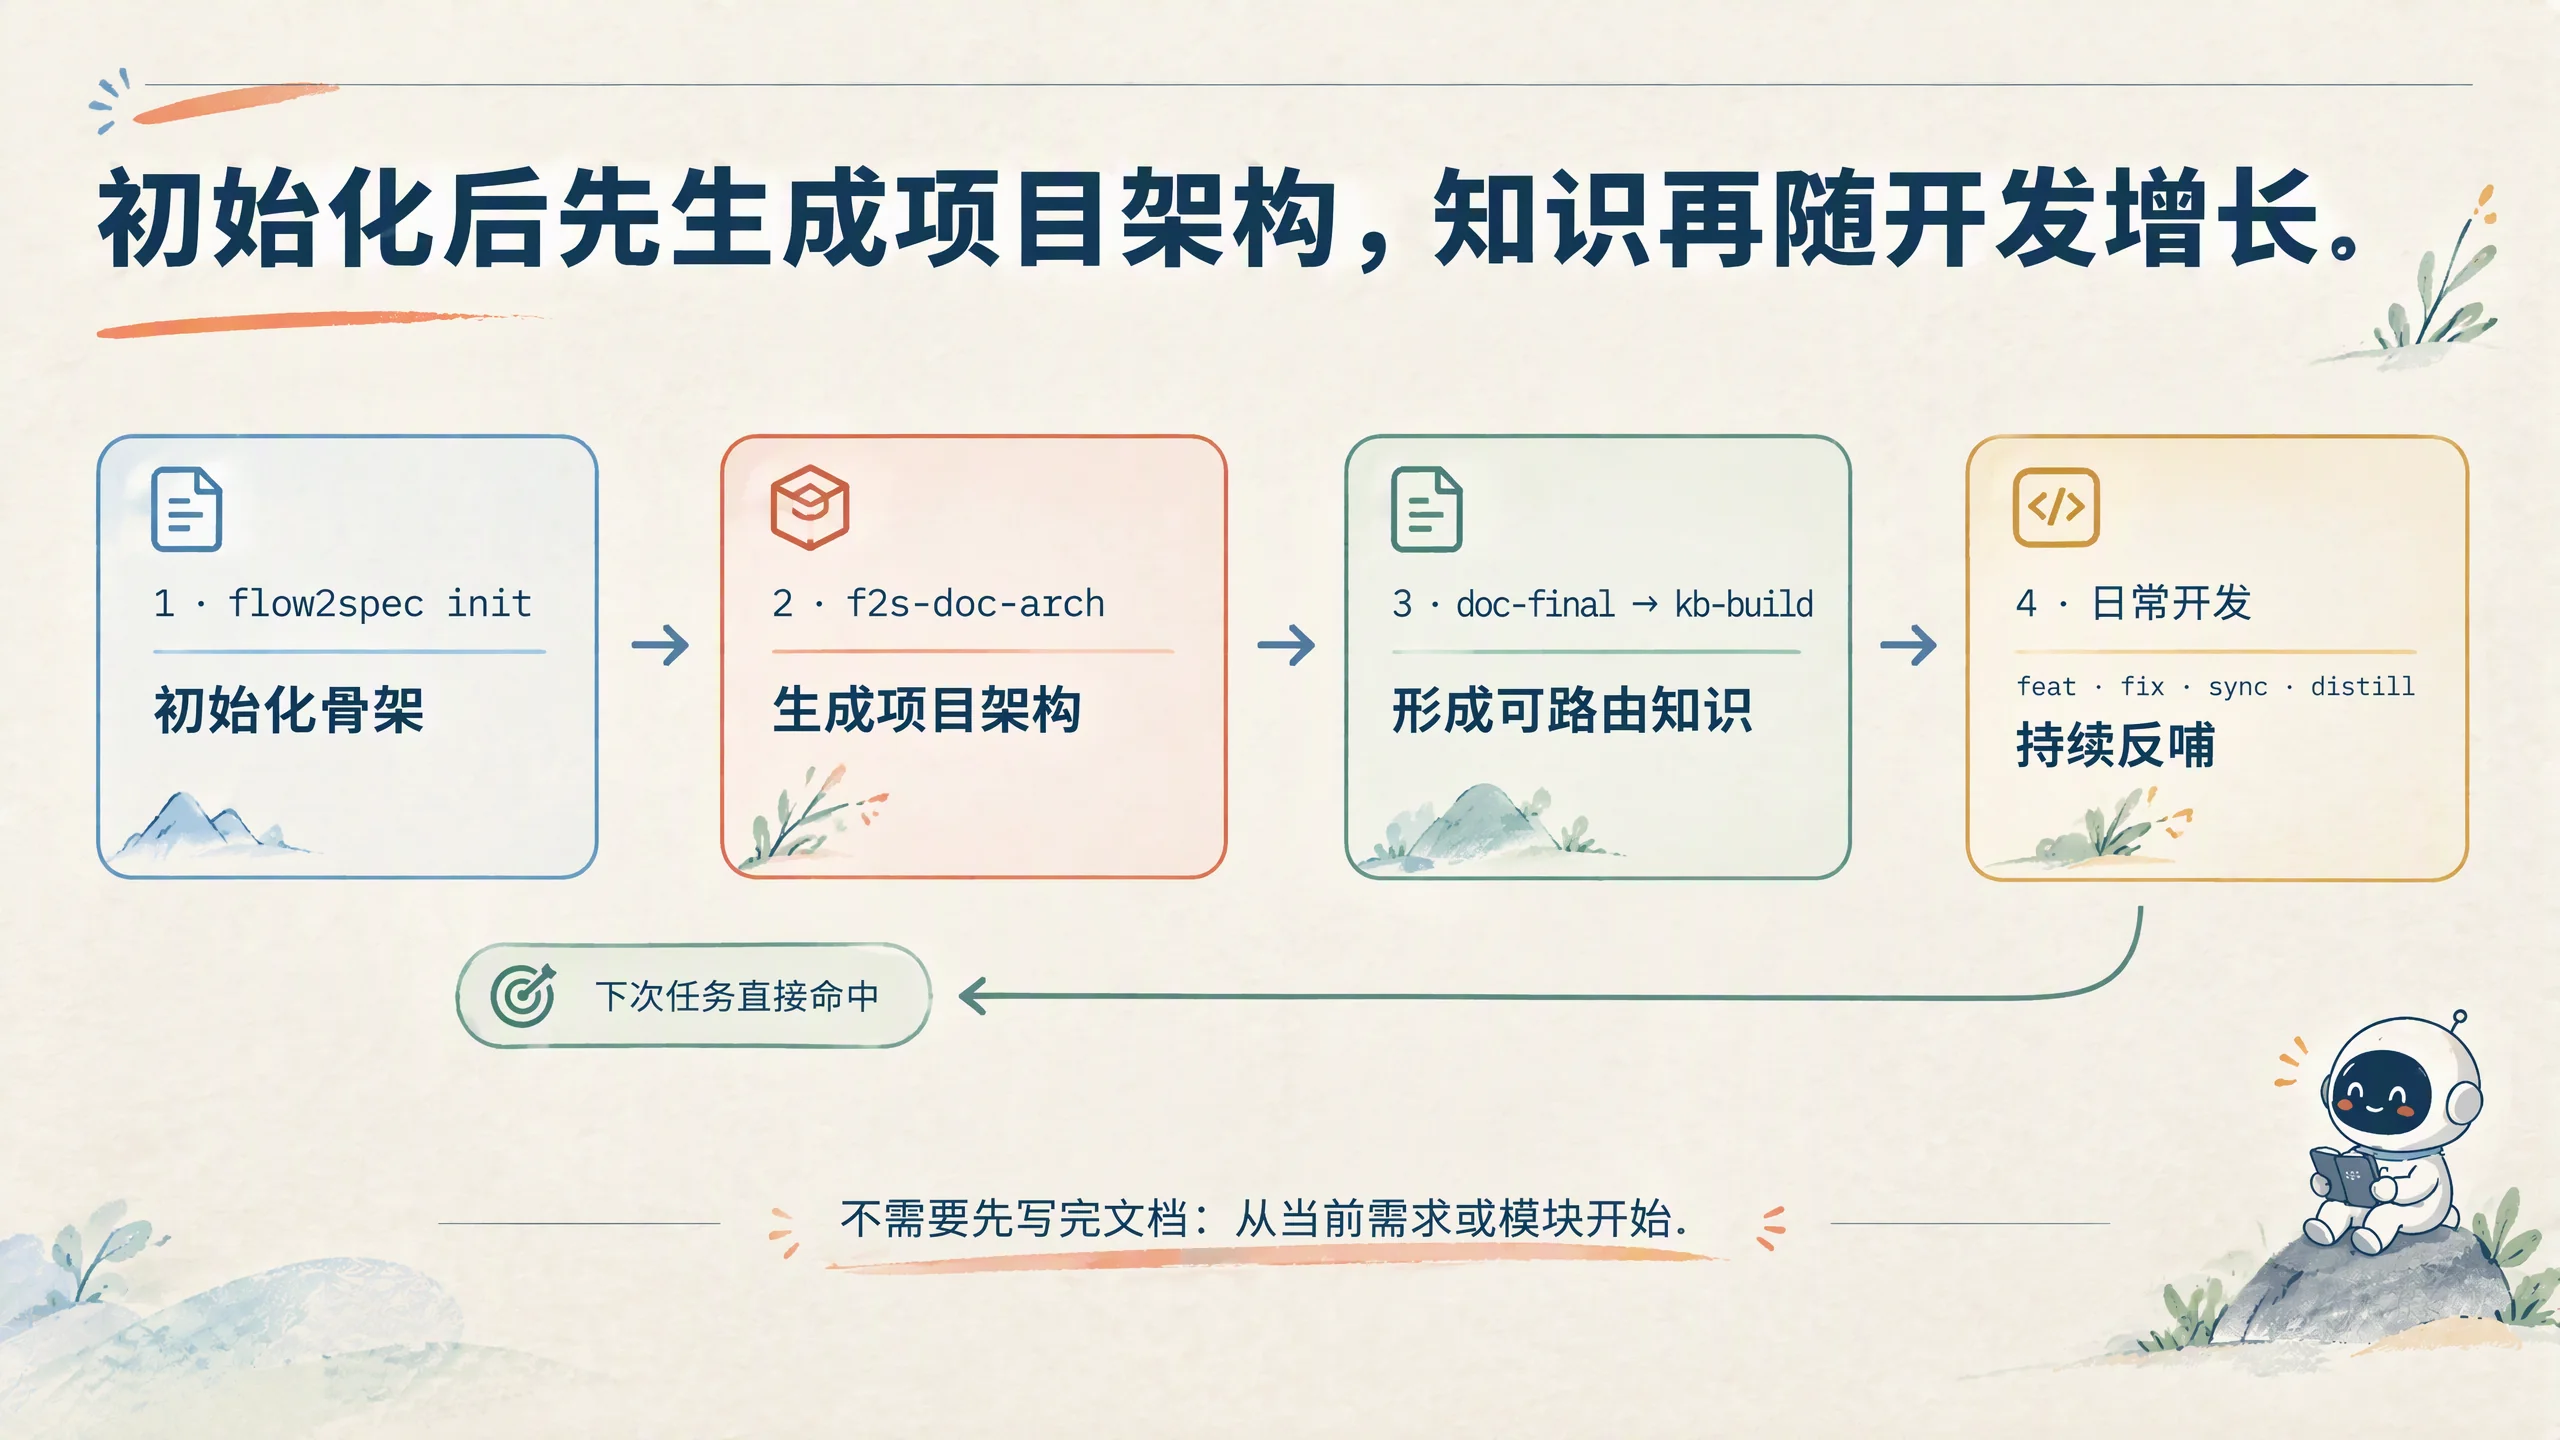
13 / 40 · 初始化后先生成项目架构,知识再随开发增长
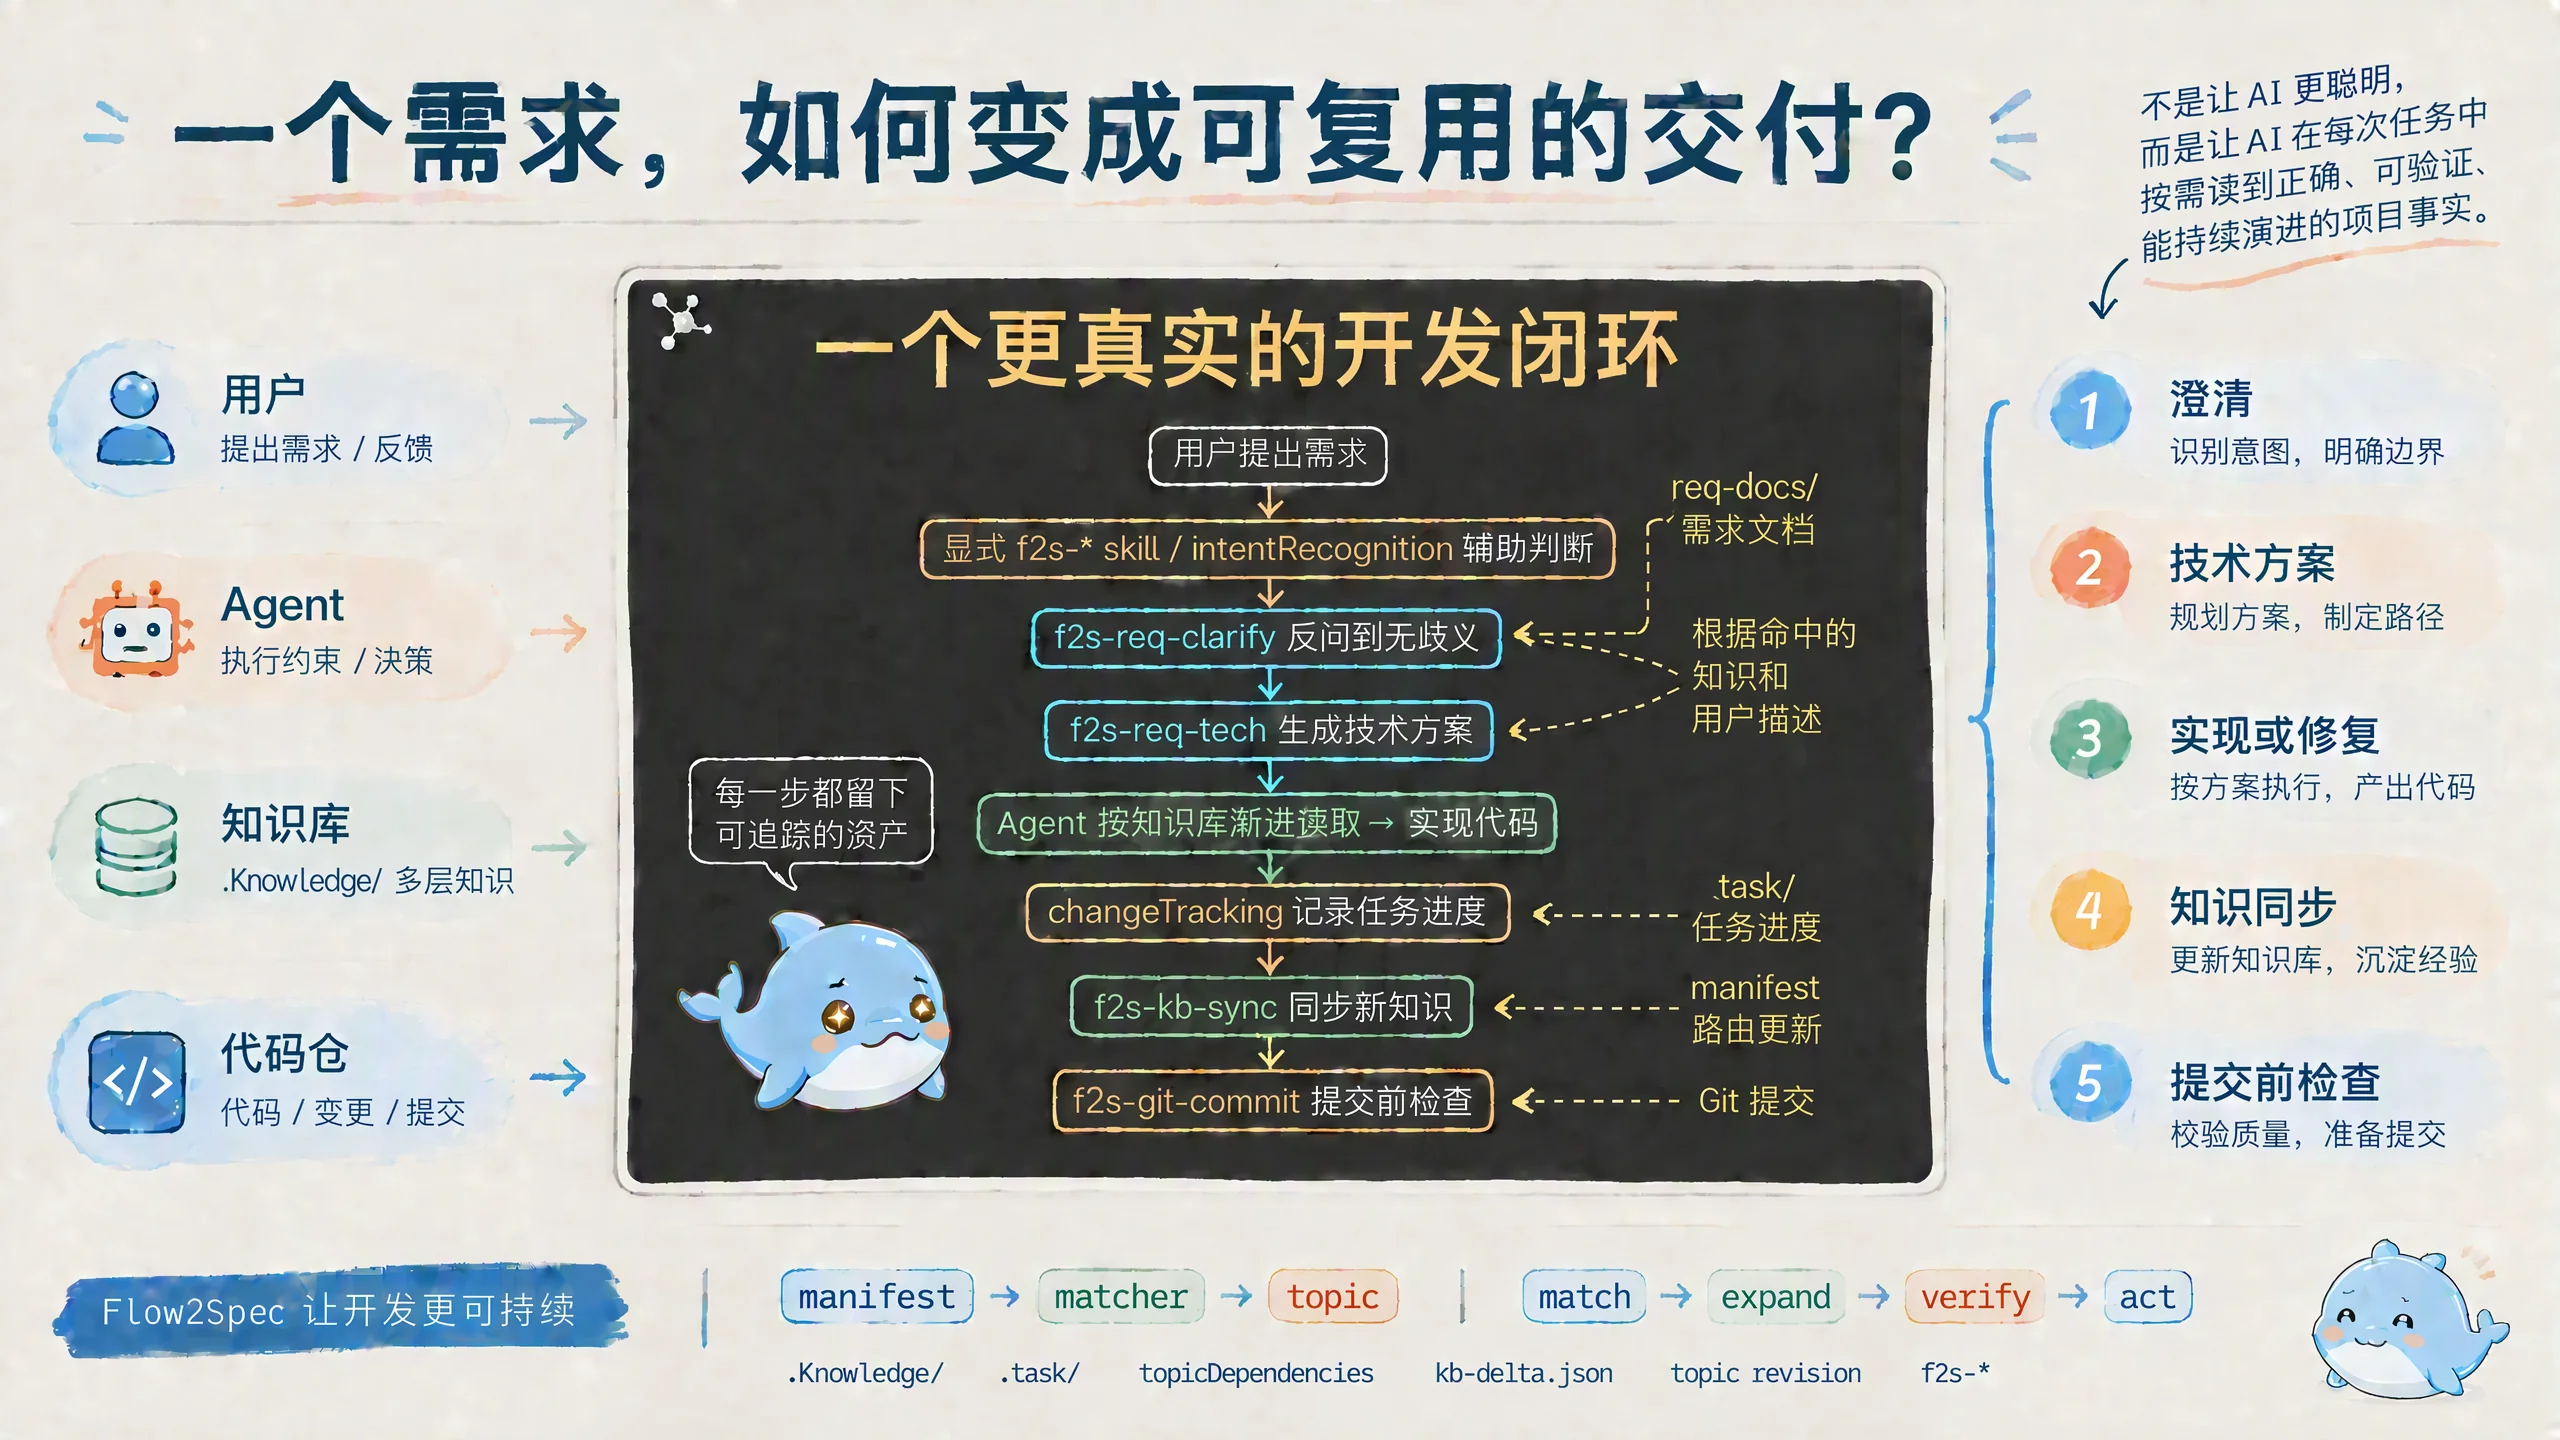
14 / 40 · 一个需求,如何变成可复用的交付?
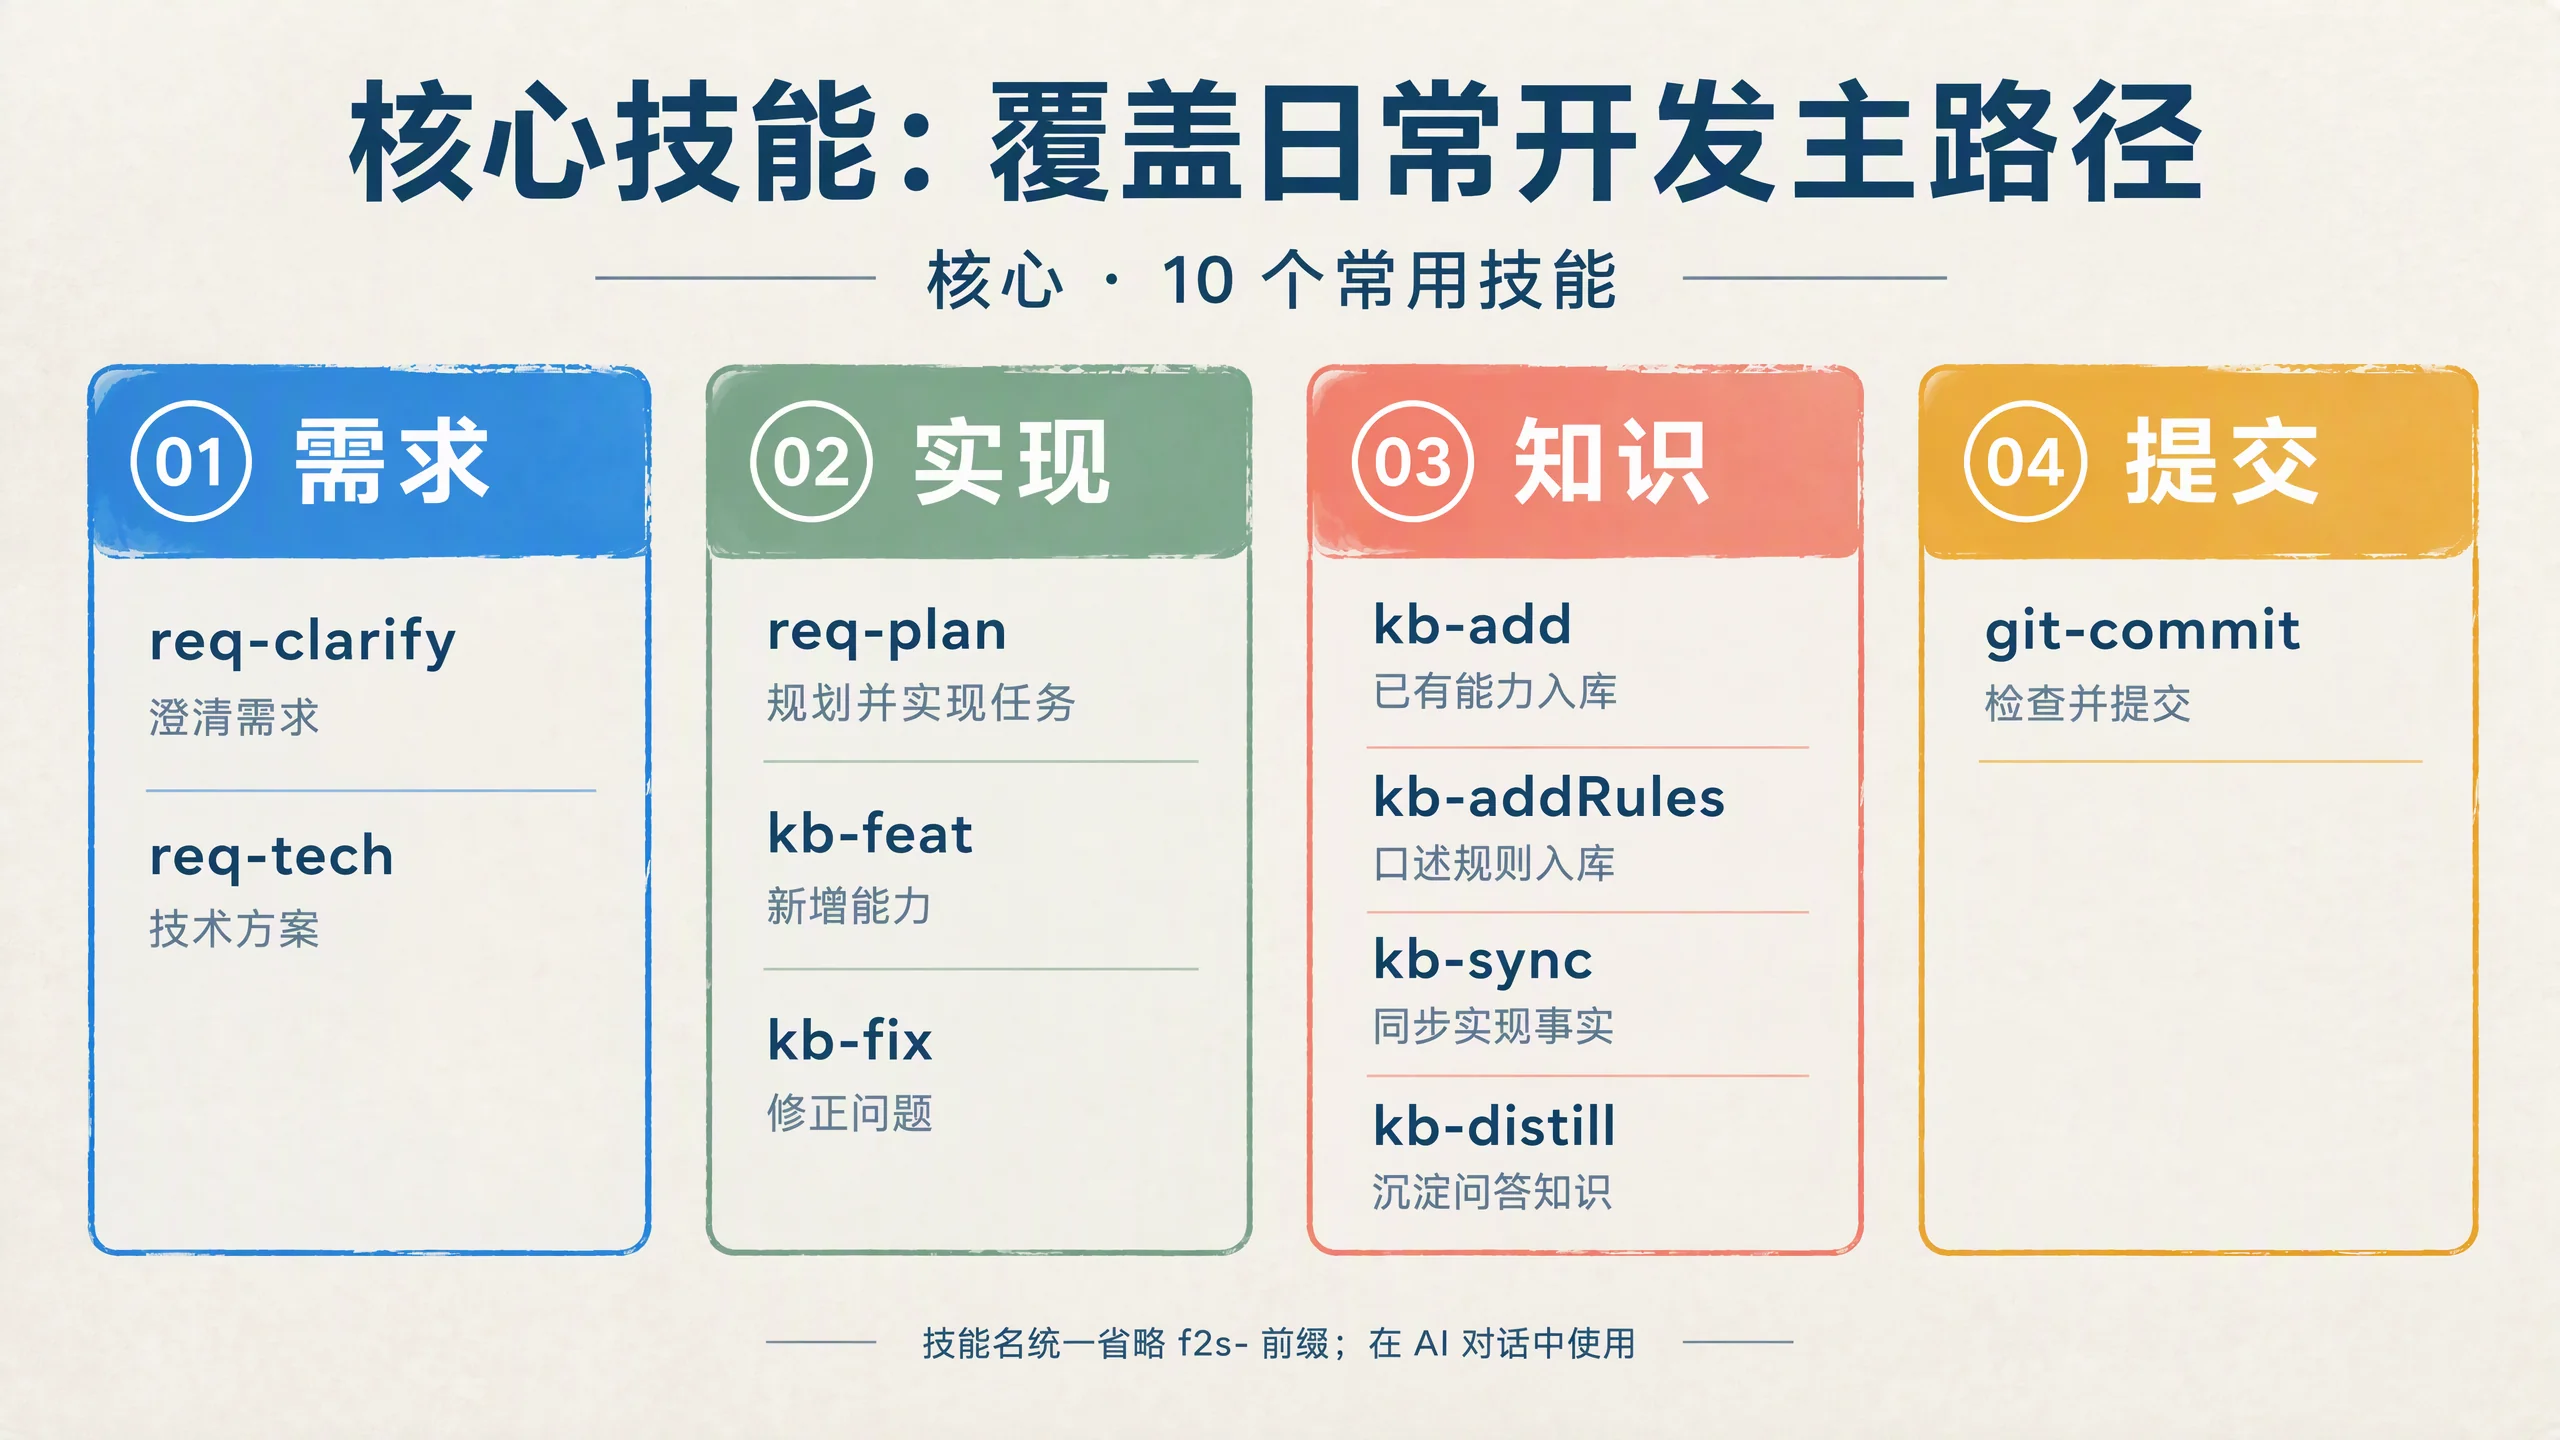
15 / 40 · 核心技能:覆盖日常开发主路径
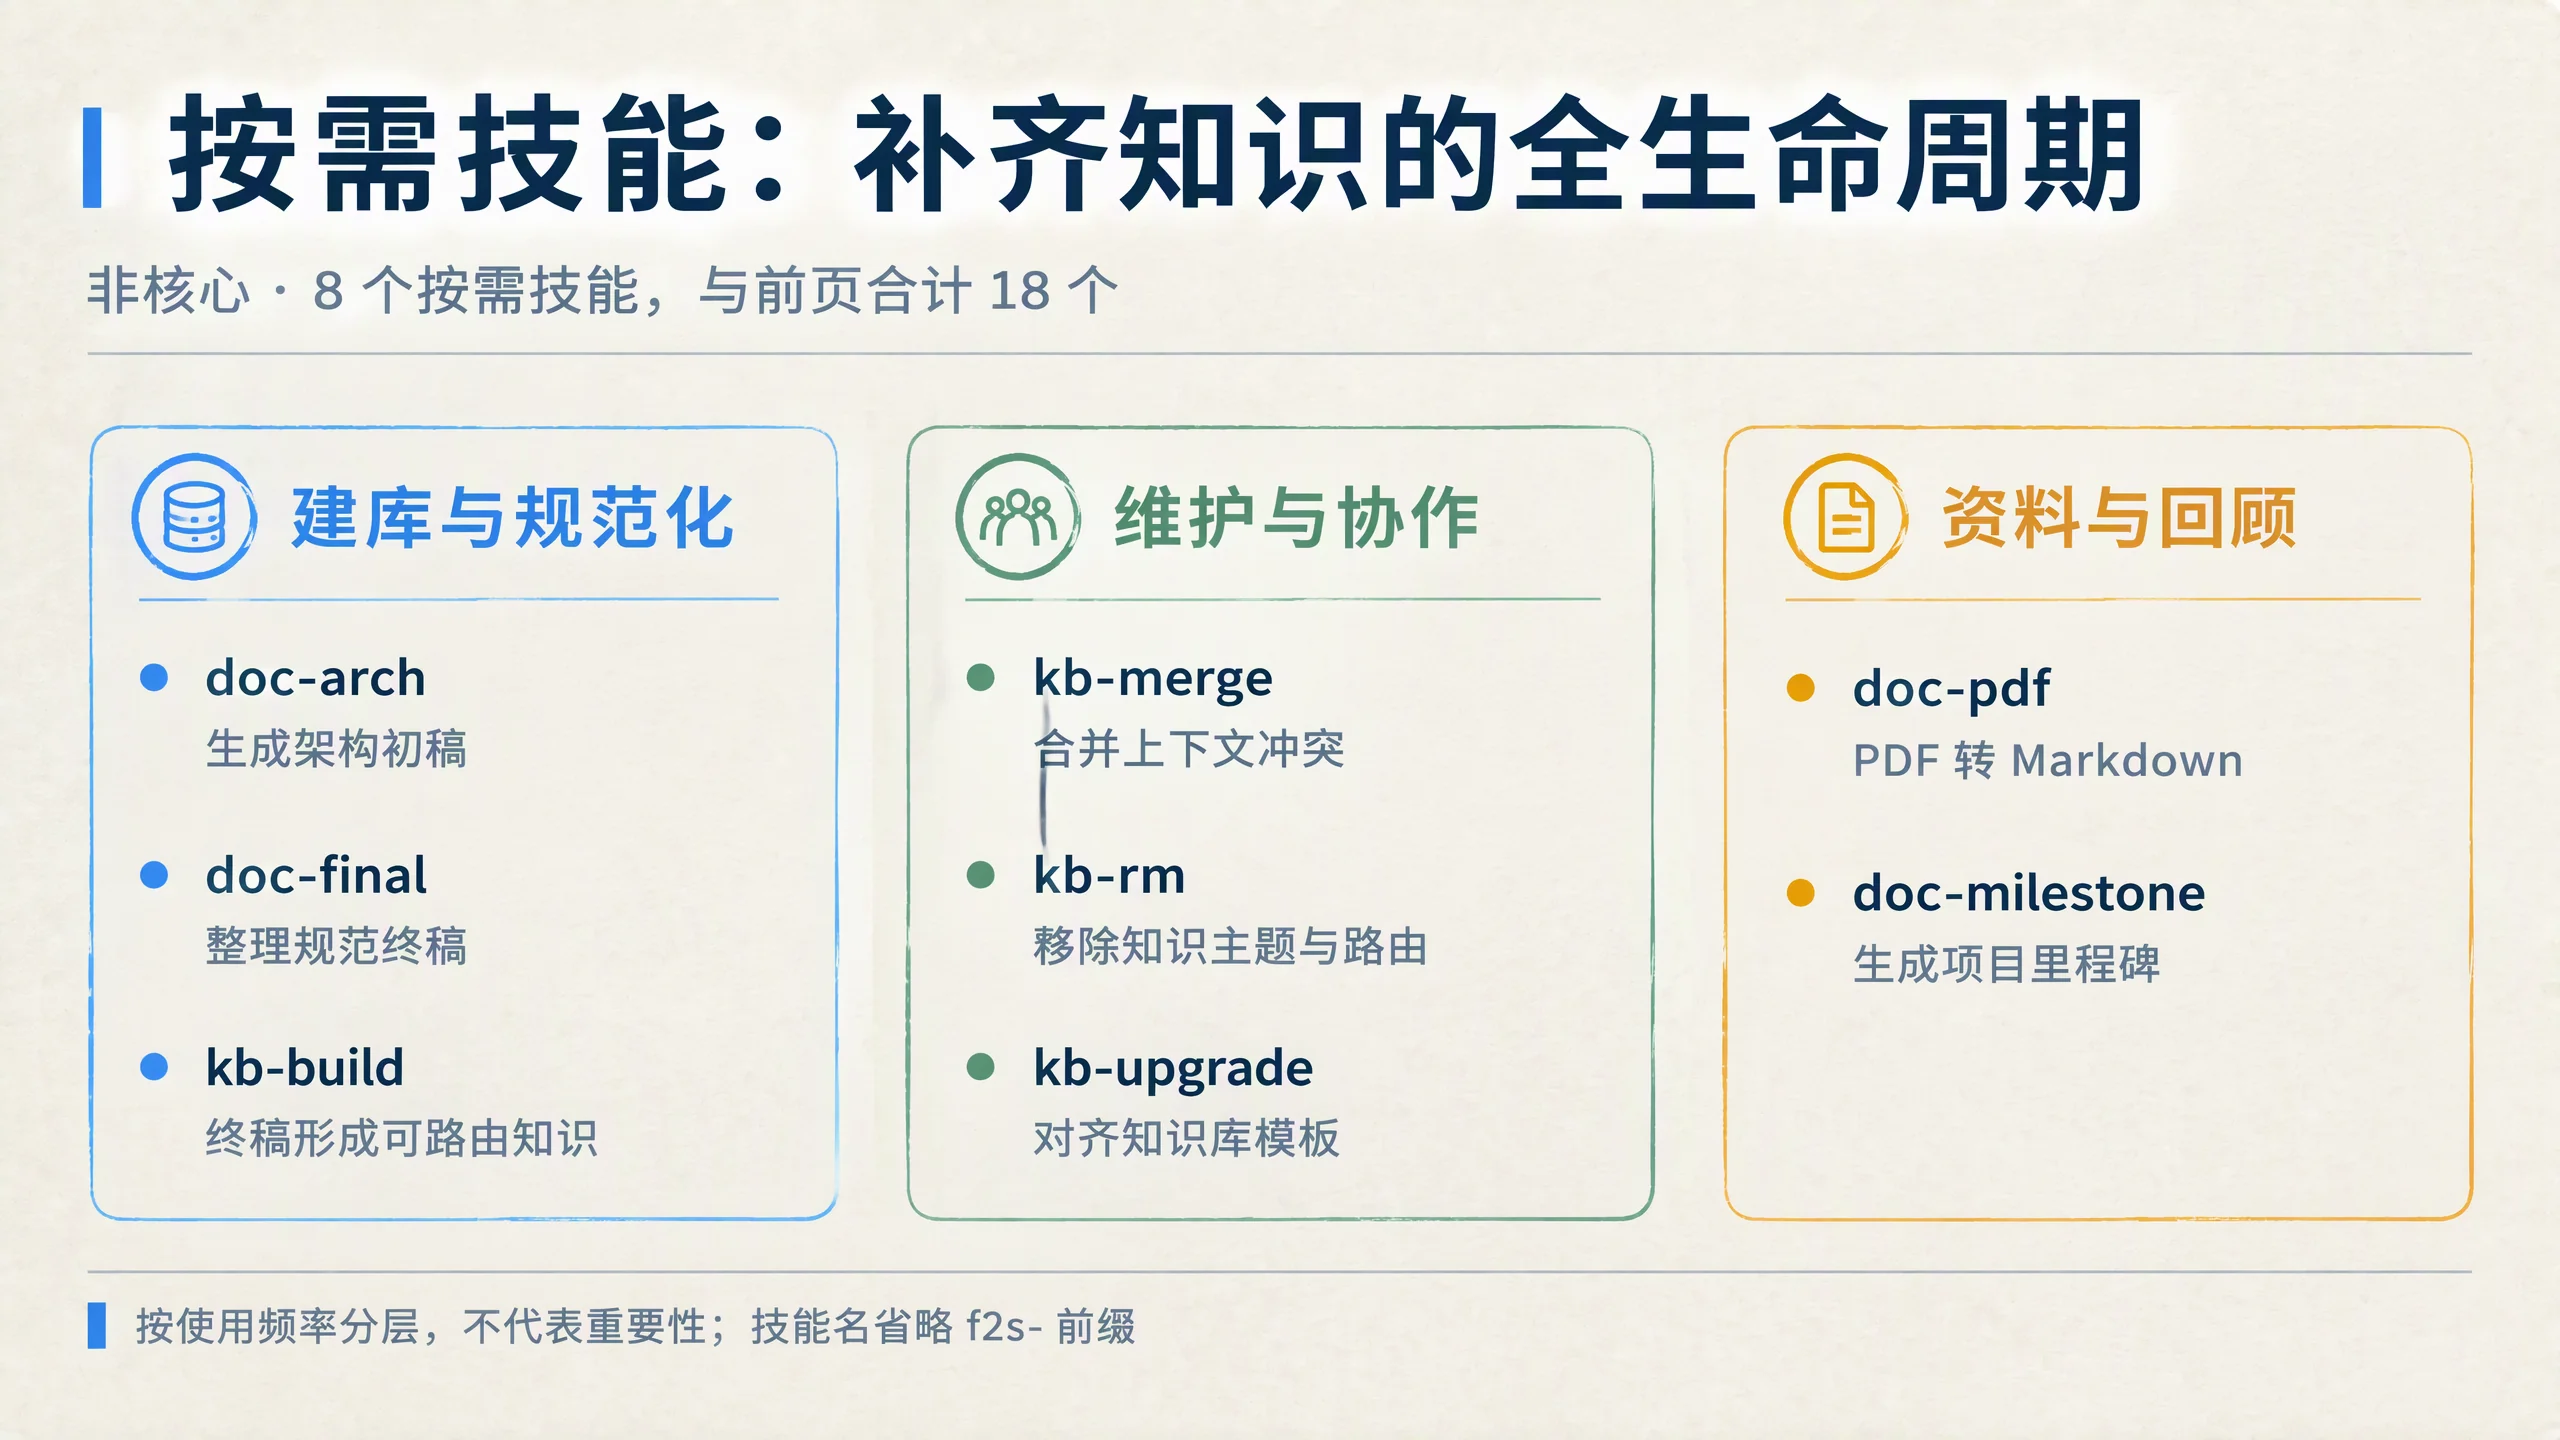
16 / 40 · 按需技能:补齐知识的全生命周期
17 / 40 · 五类日常使用场景
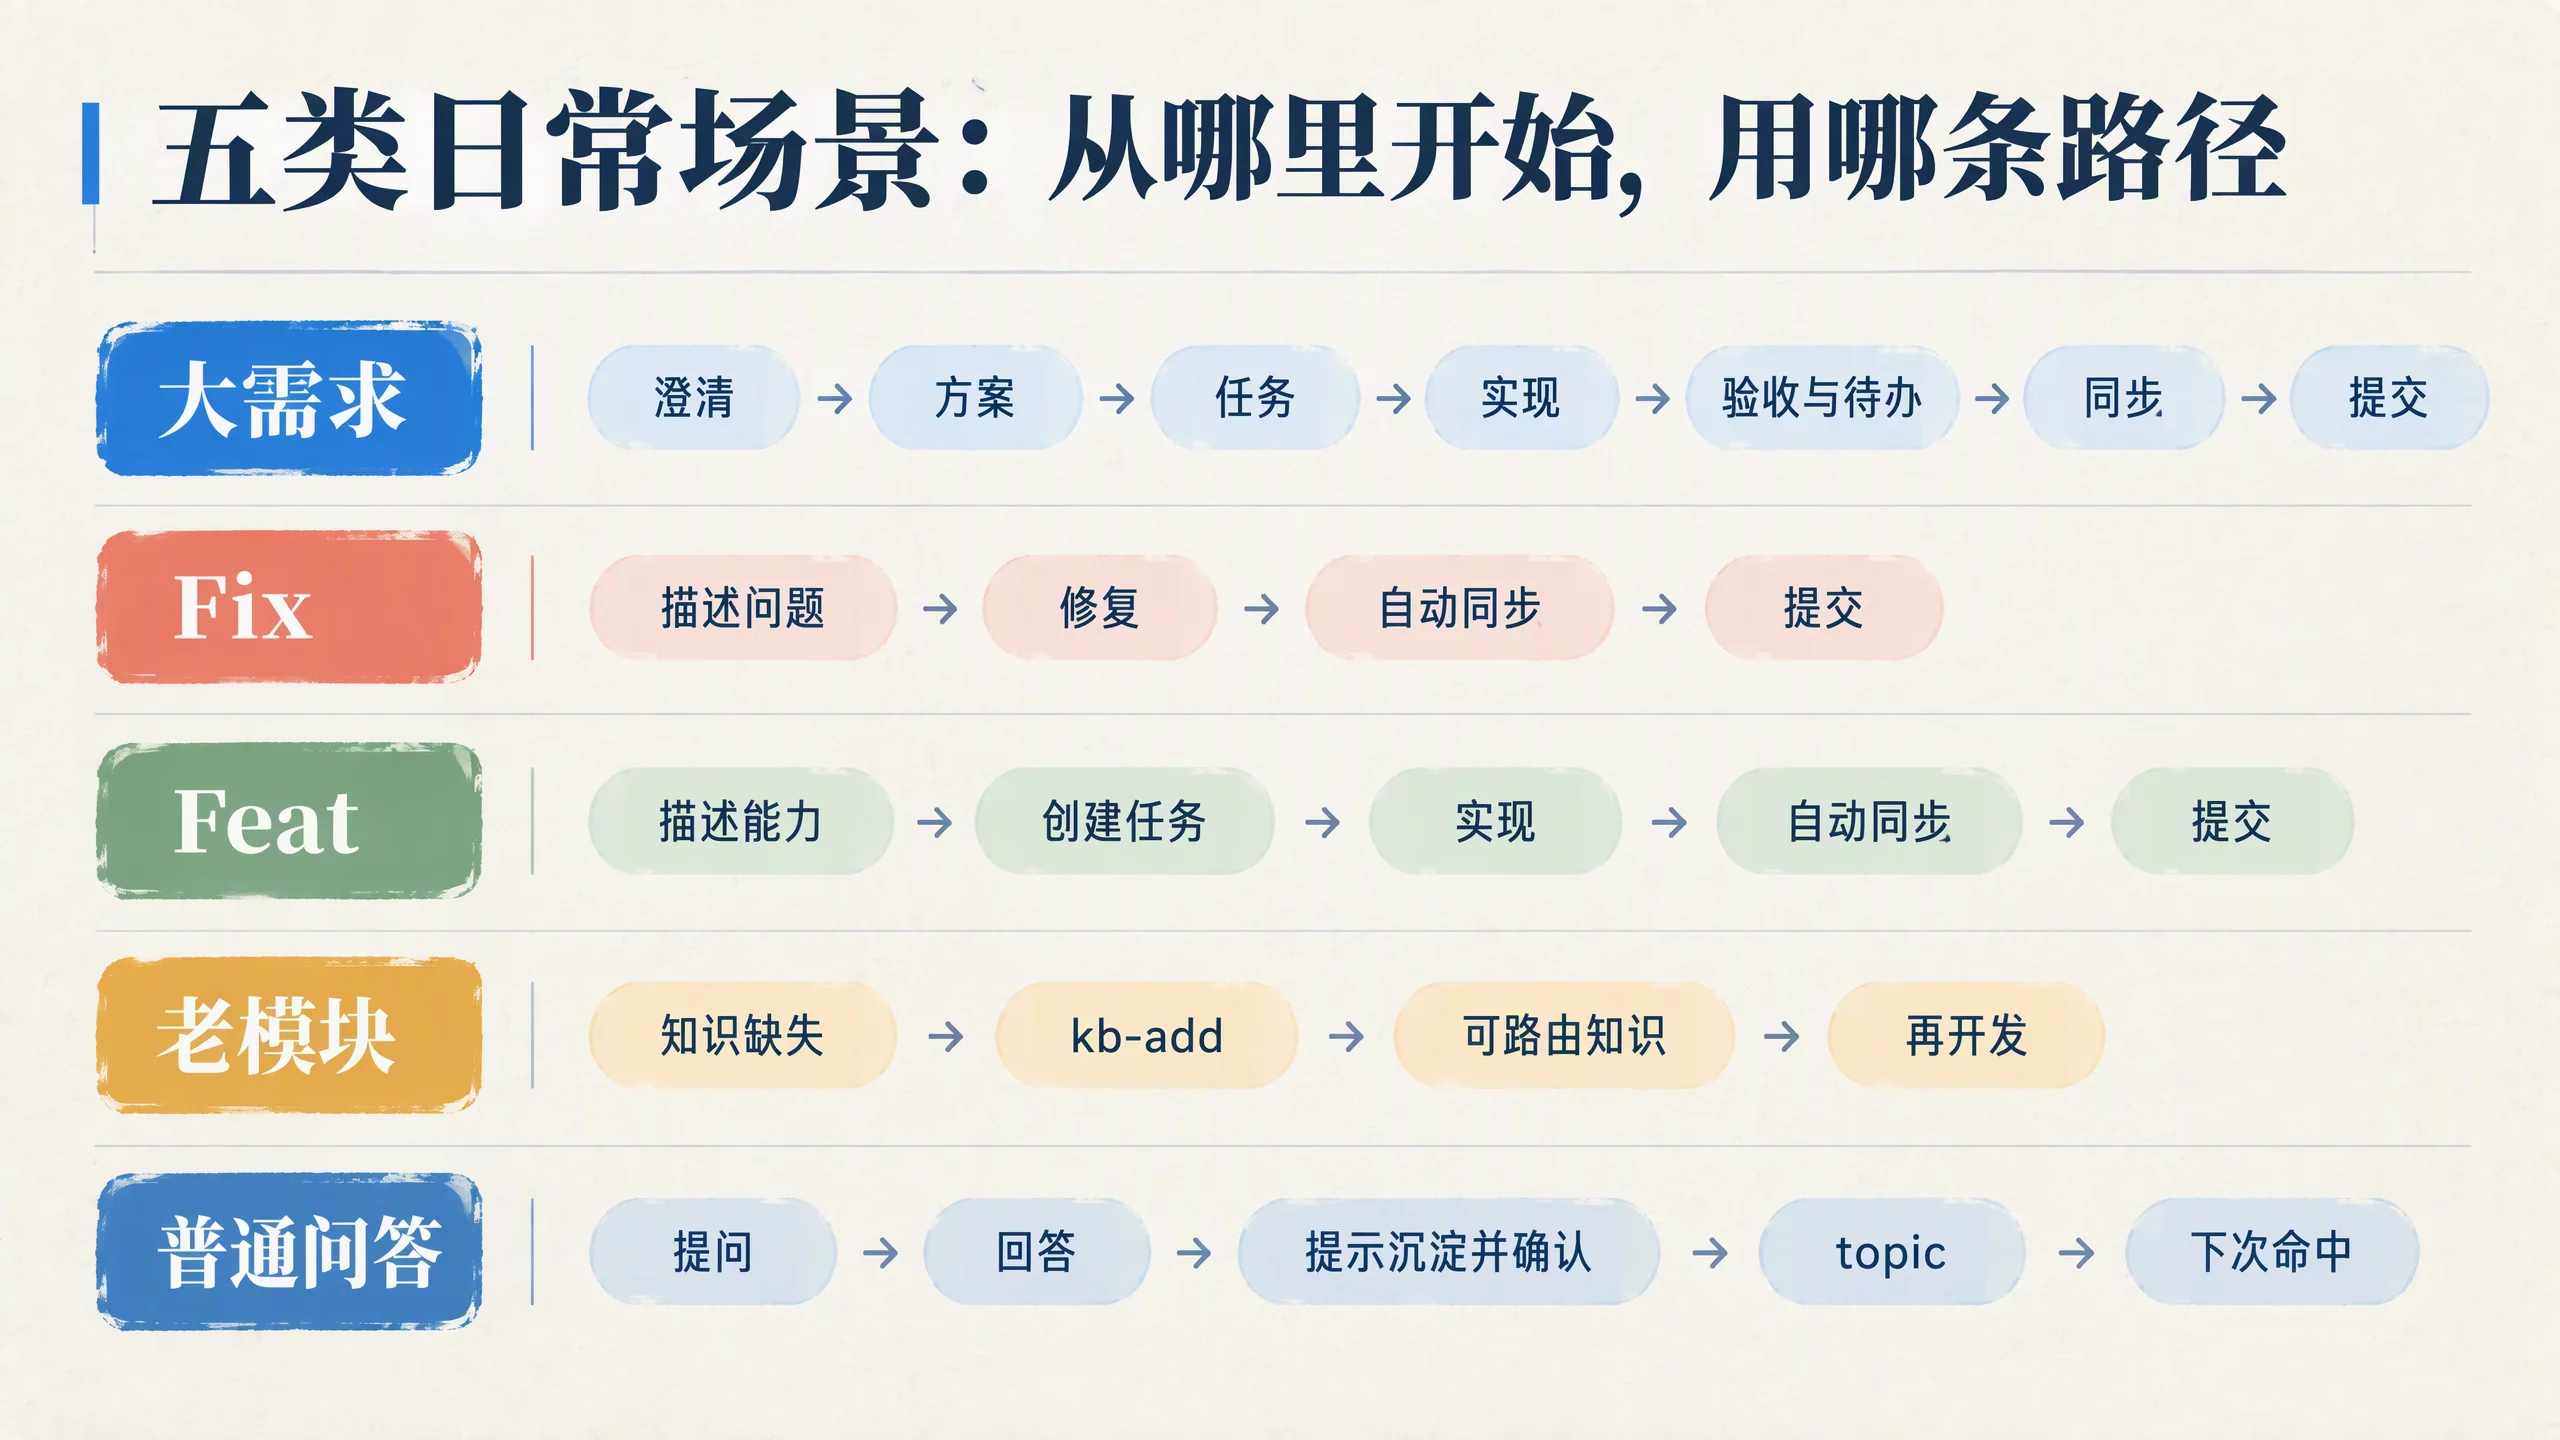
18 / 40 · 五类日常场景:从哪里开始,用哪条路径
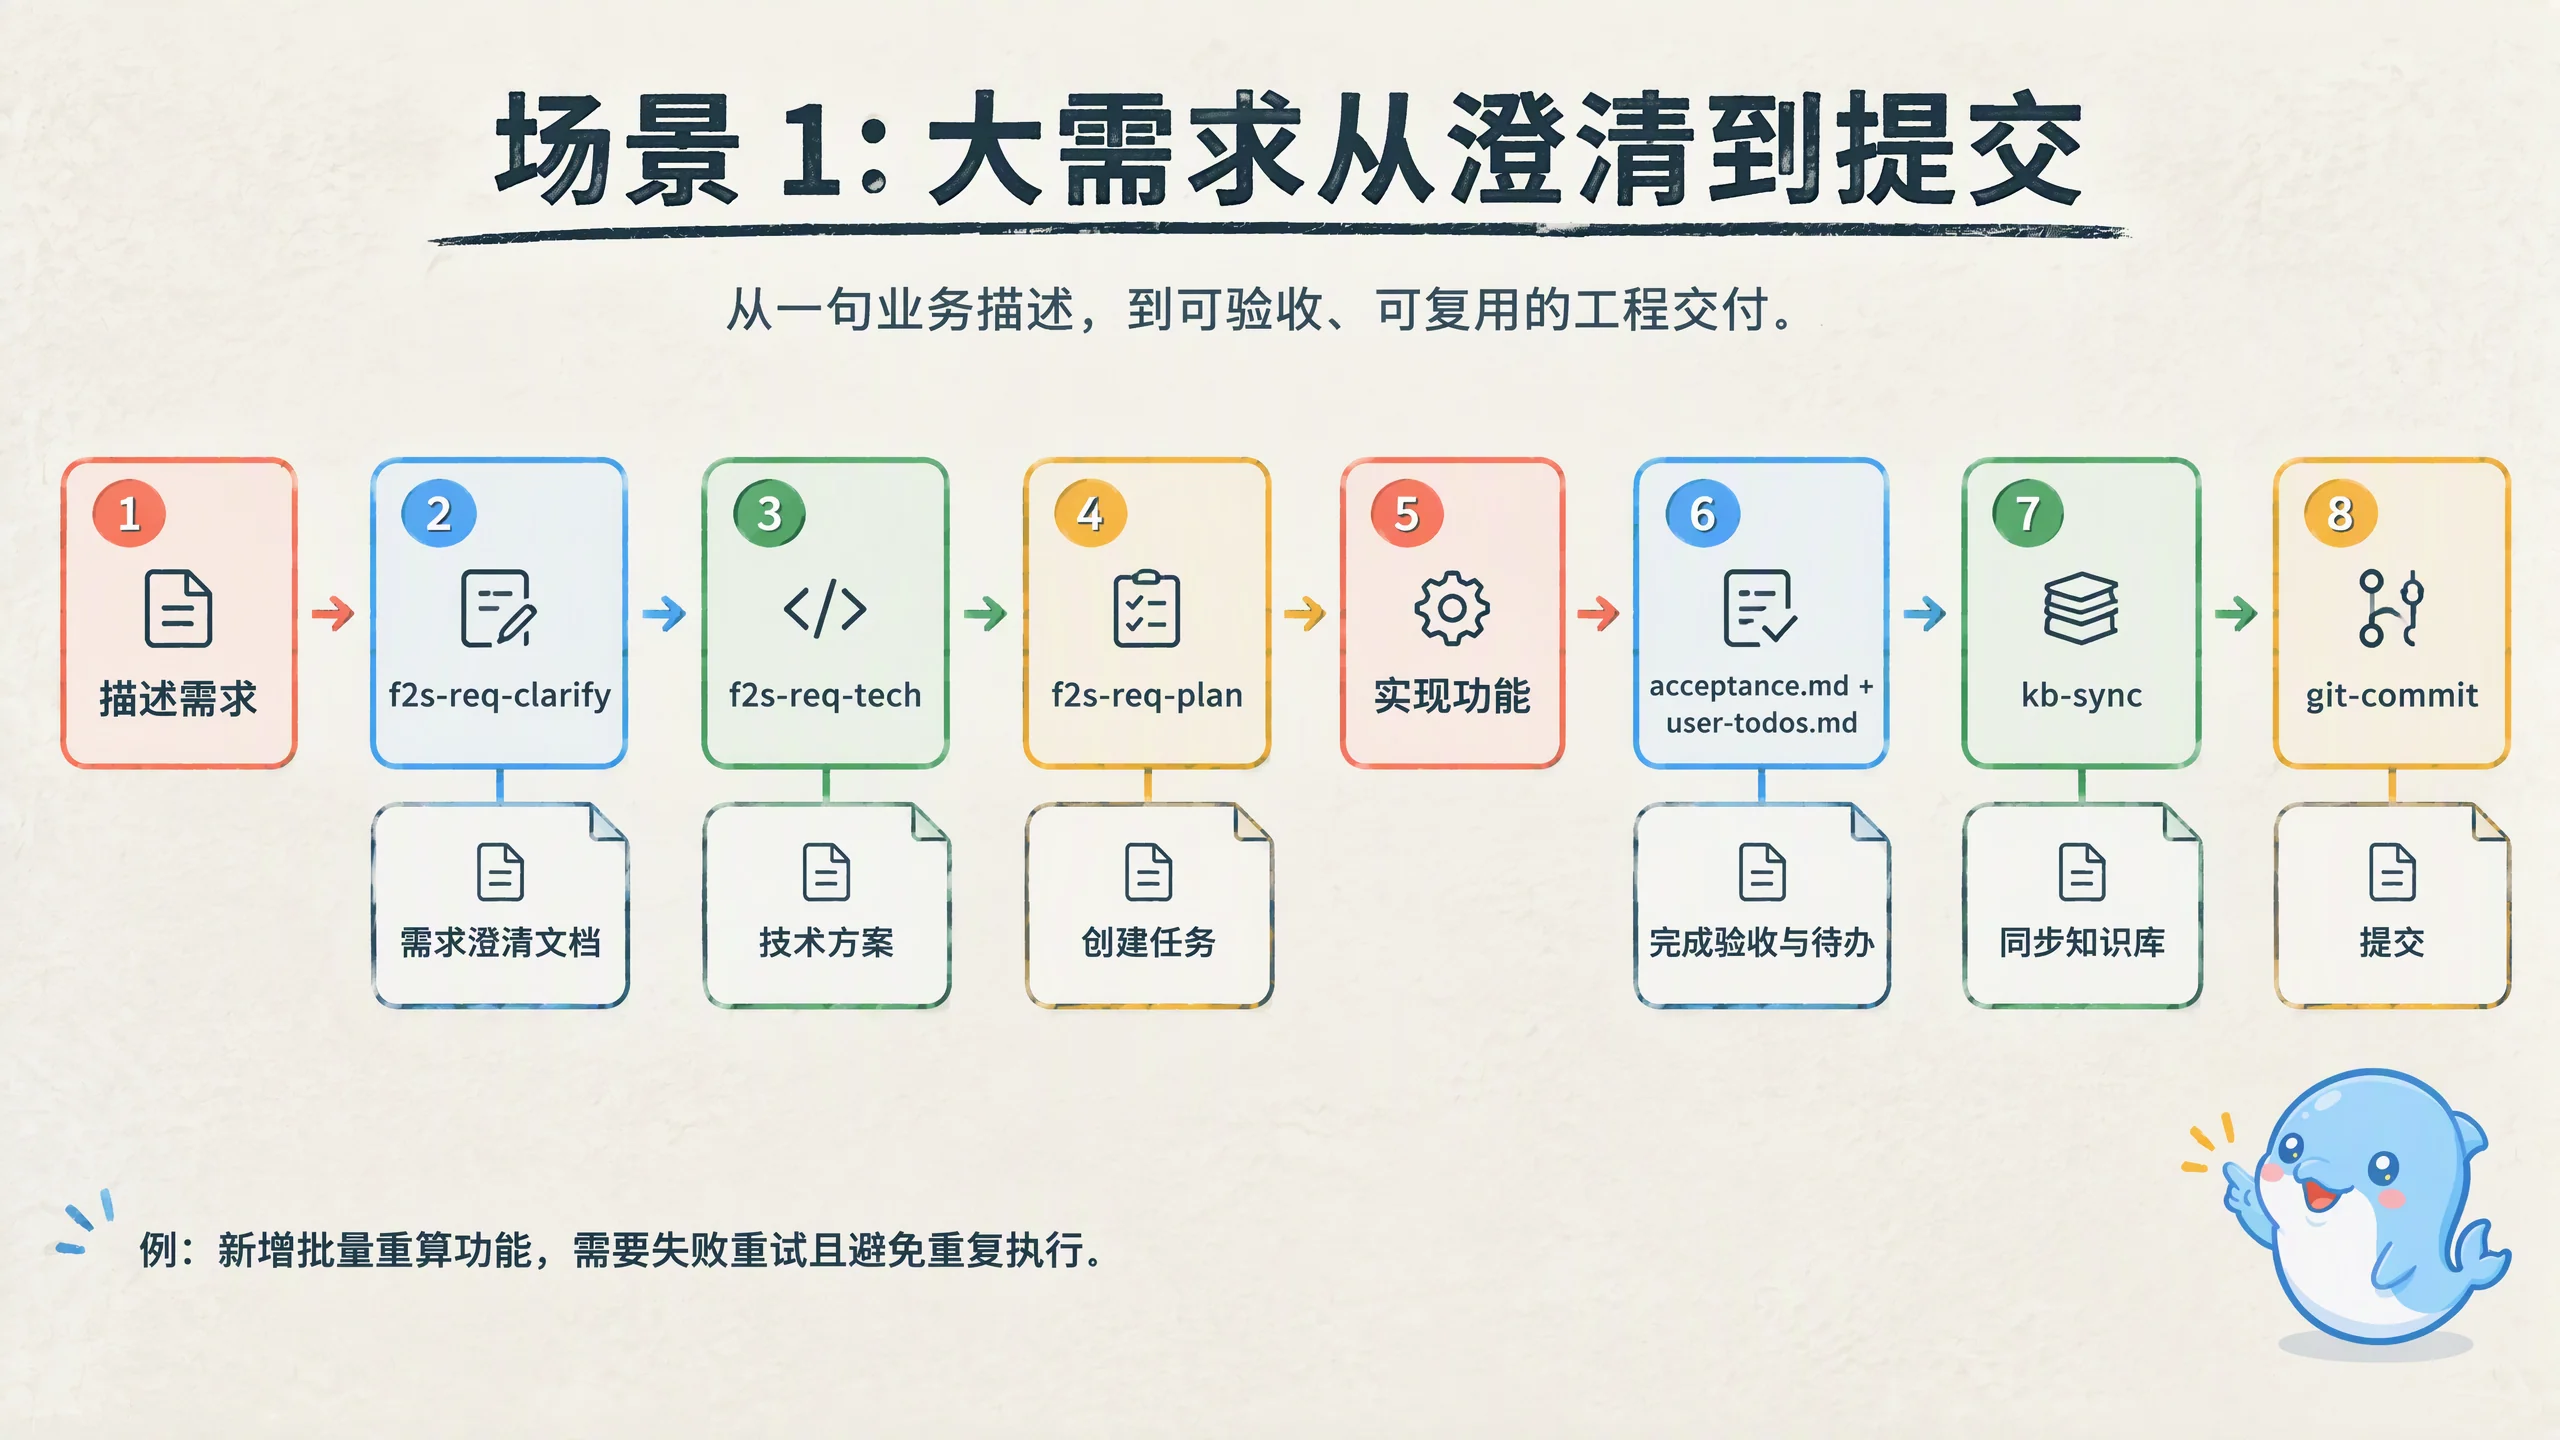
19 / 40 · 场景 1:大需求从澄清到提交
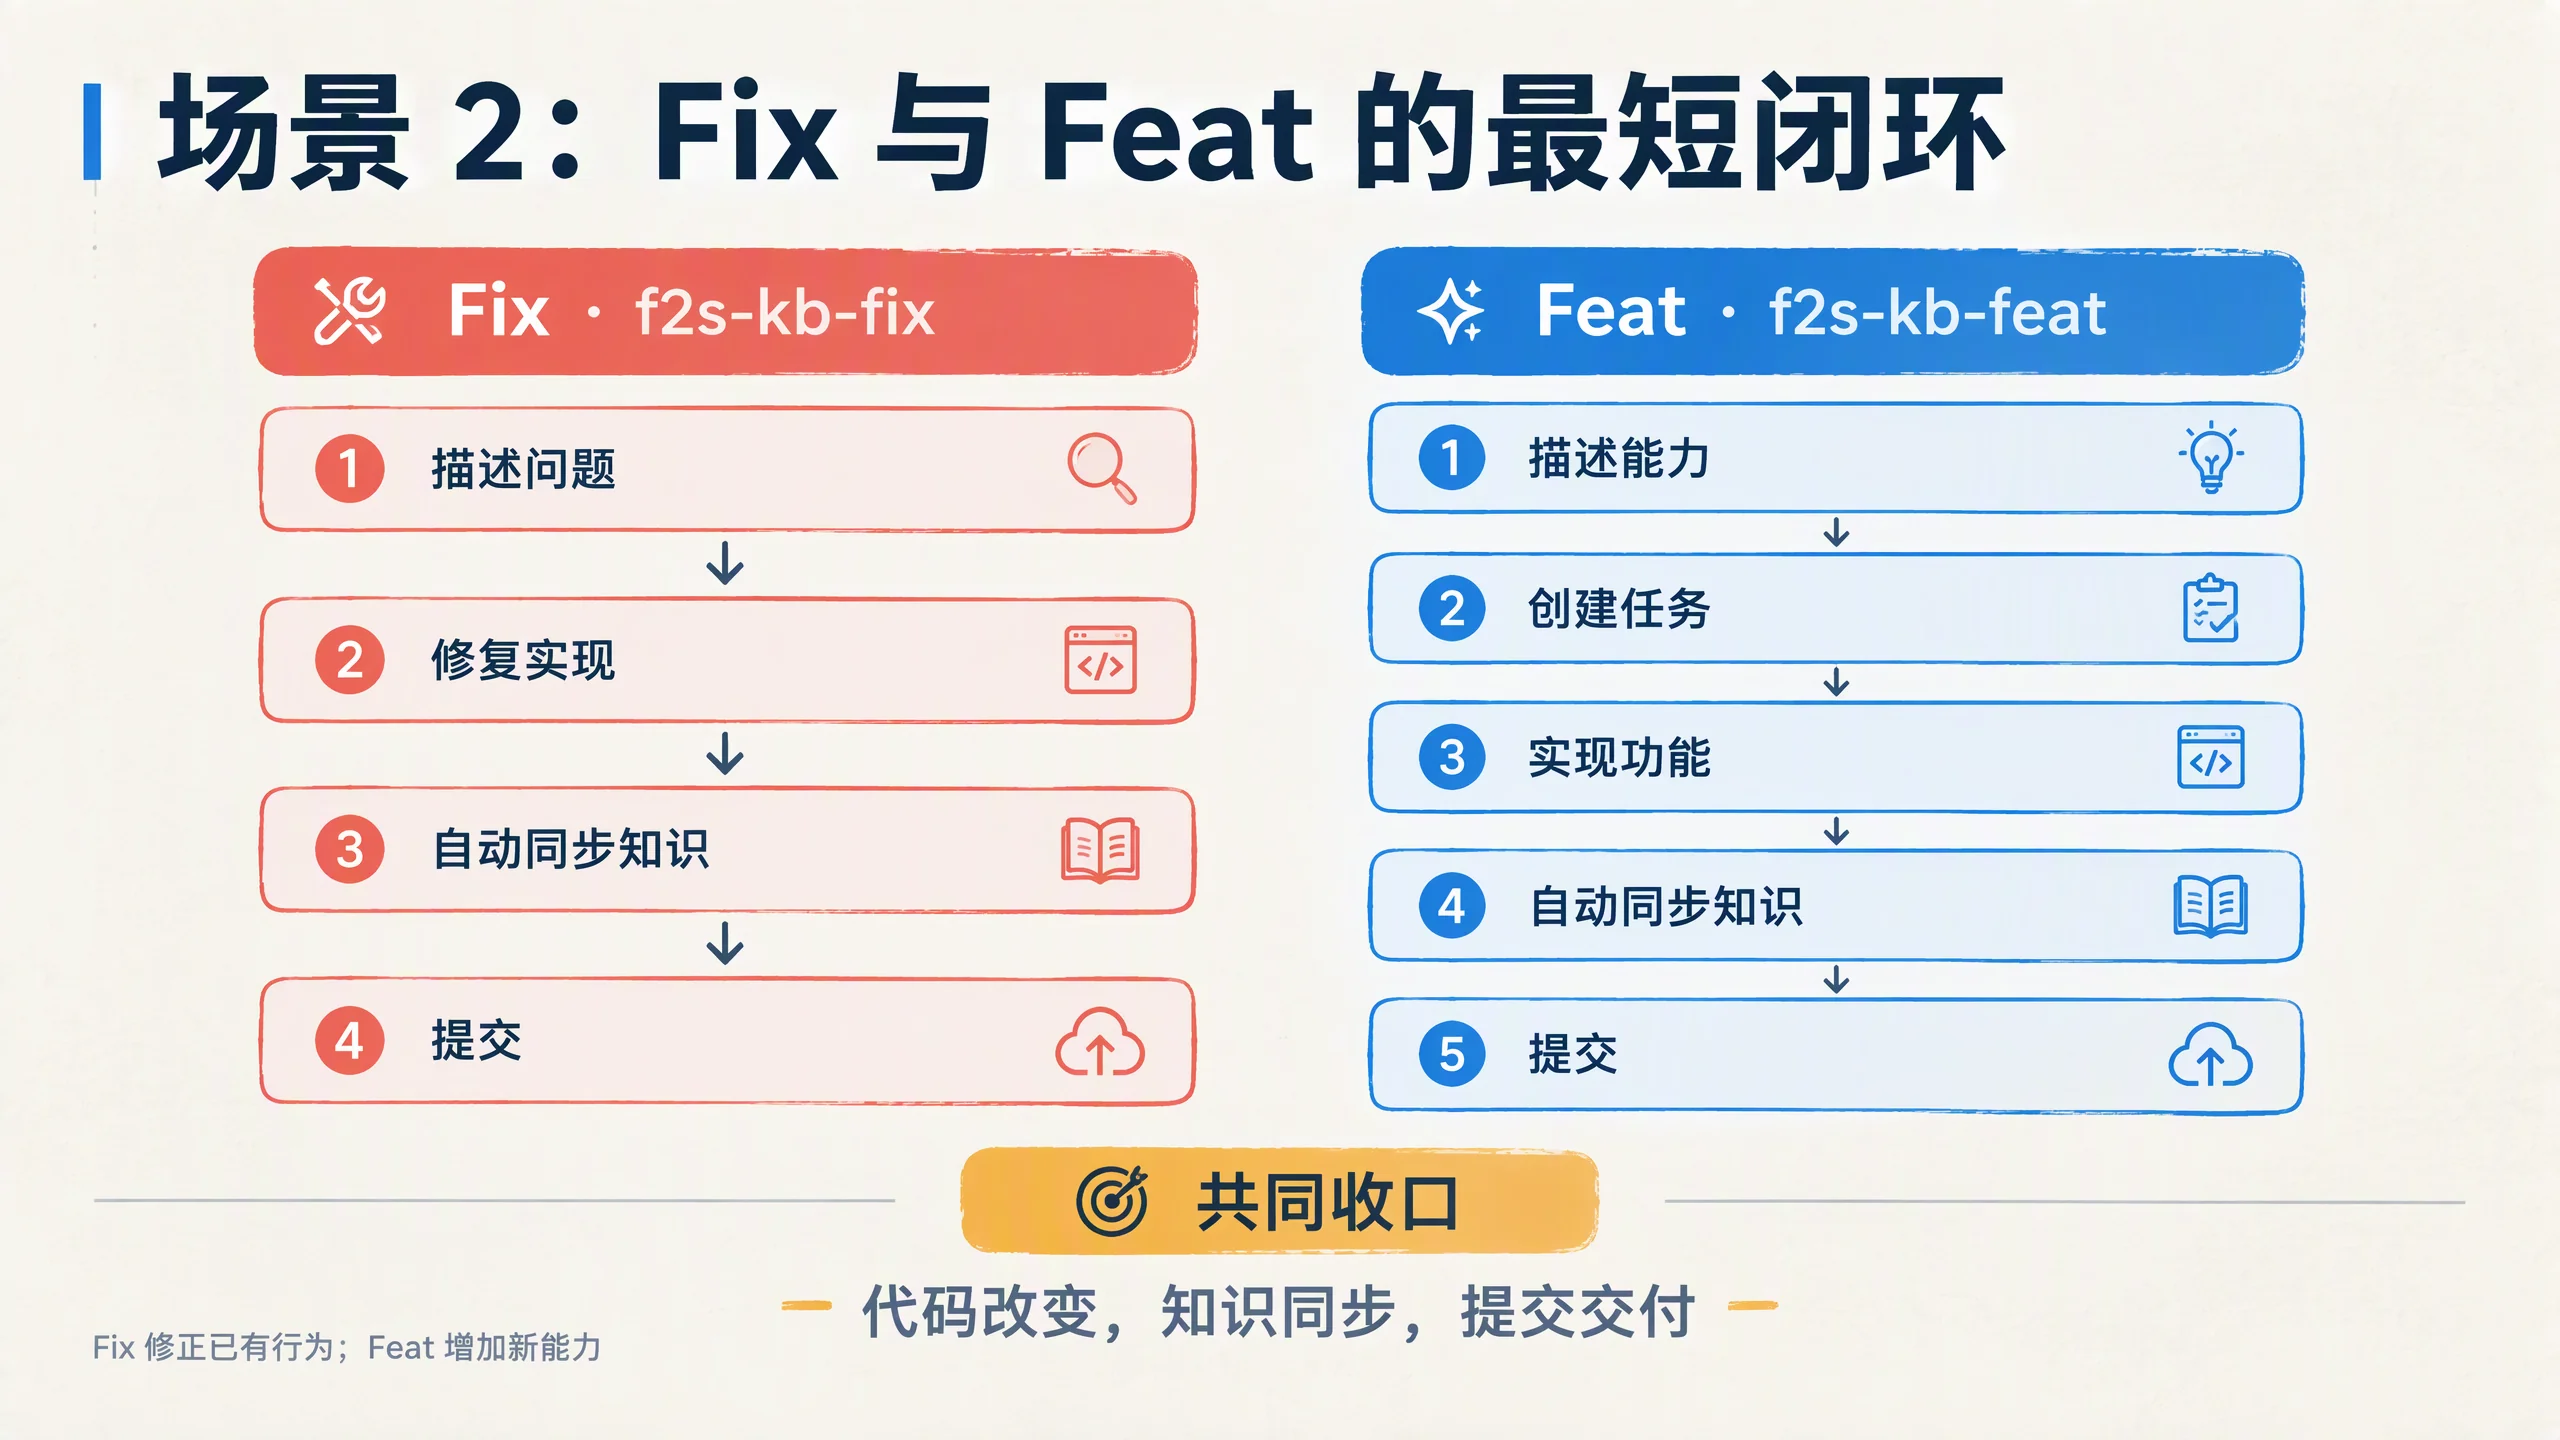
20 / 40 · 场景 2:Fix 与 Feat 的最短闭环
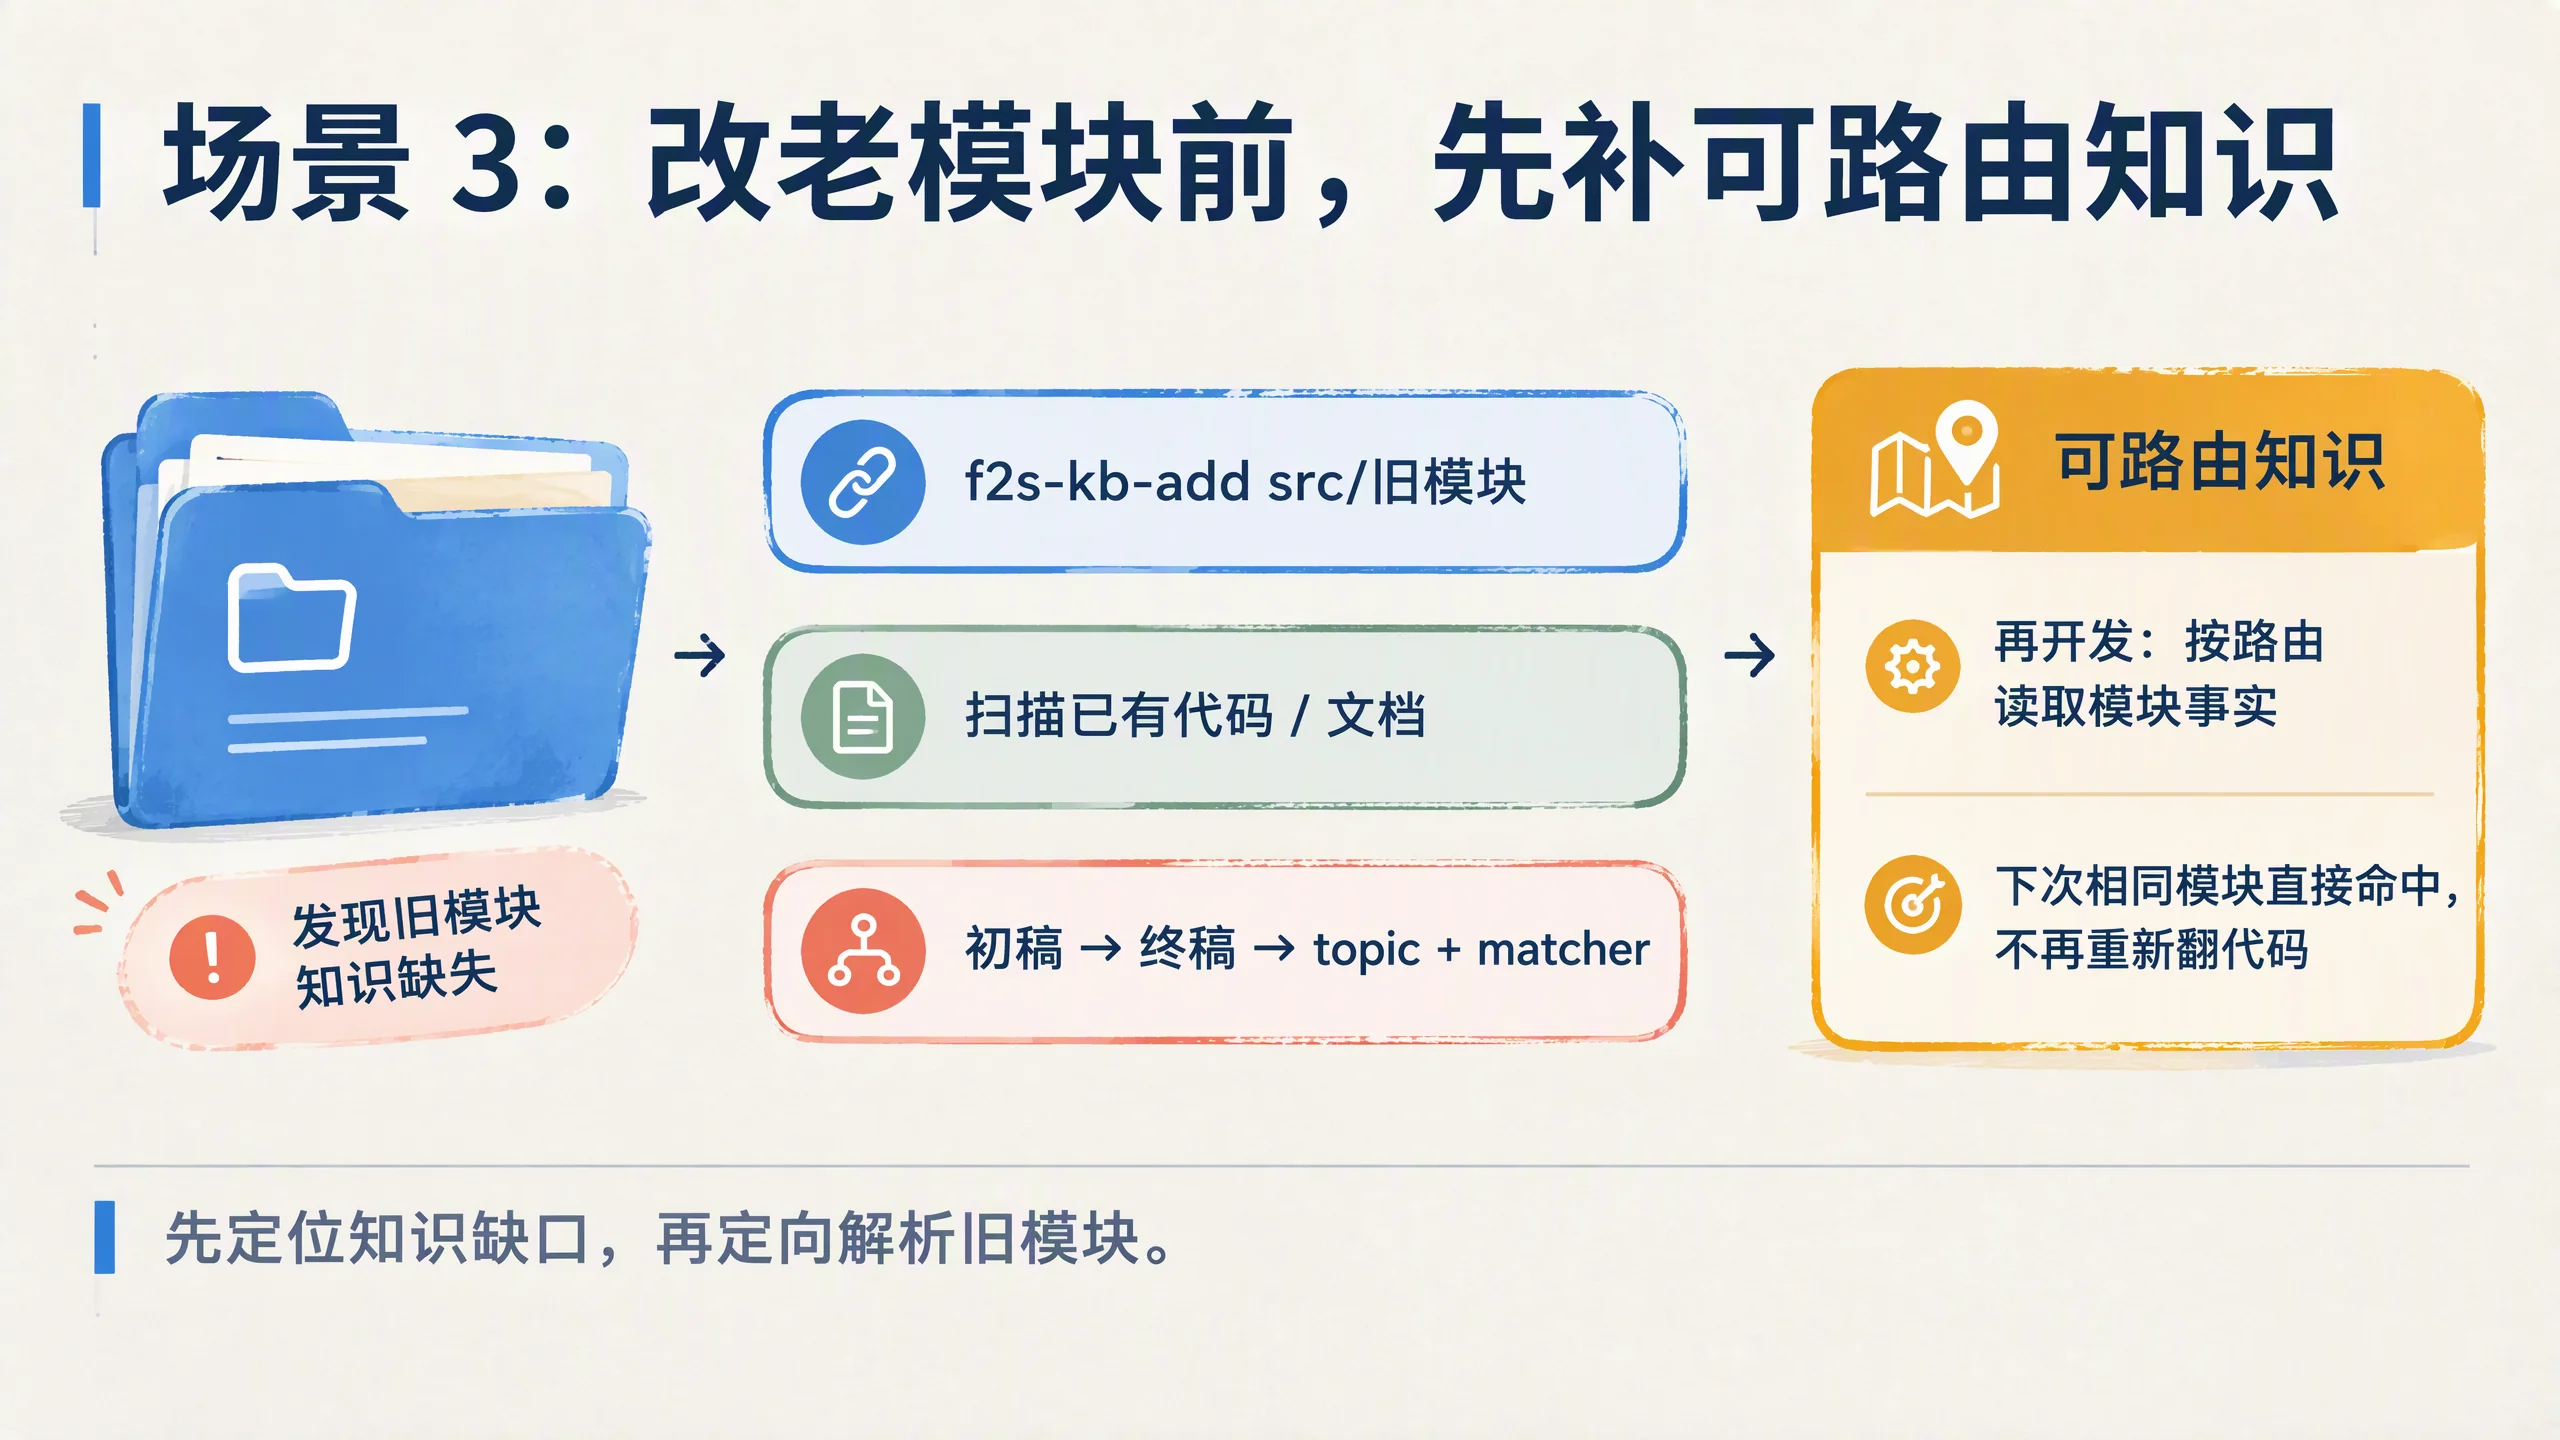
21 / 40 · 场景 3:改老模块前,先补可路由知识
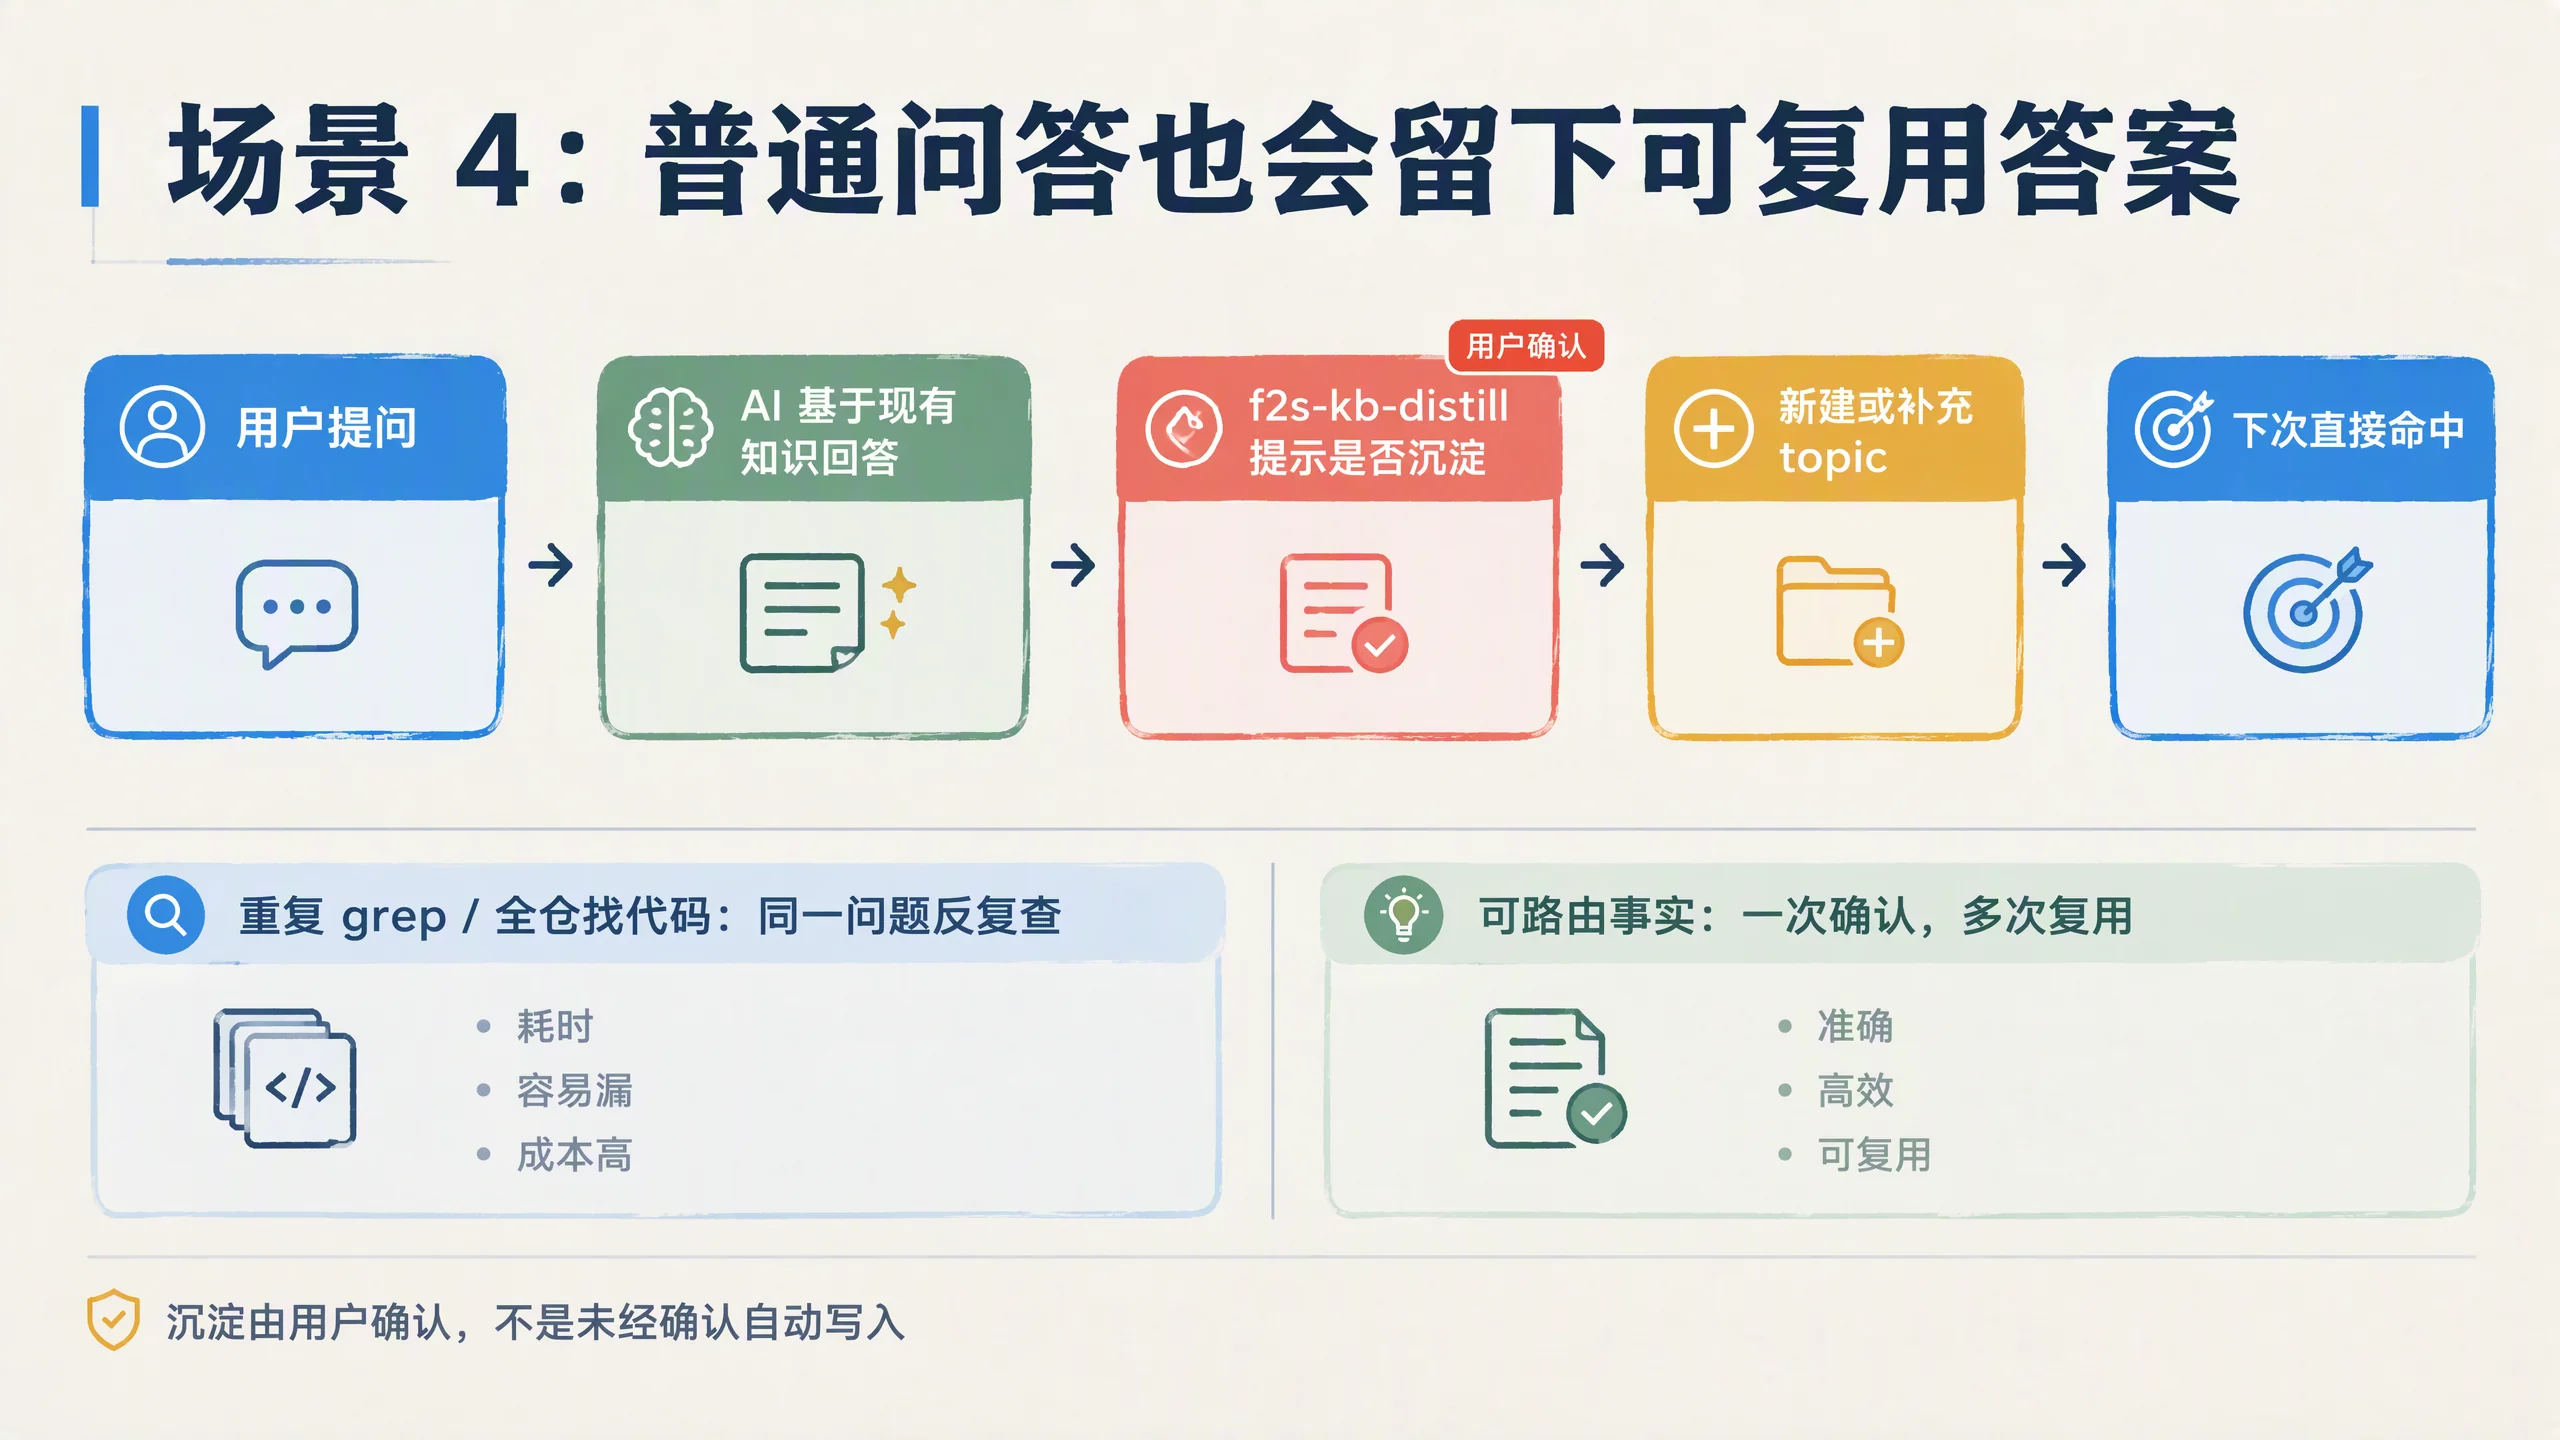
22 / 40 · 场景 4:普通问答也会留下可复用答案
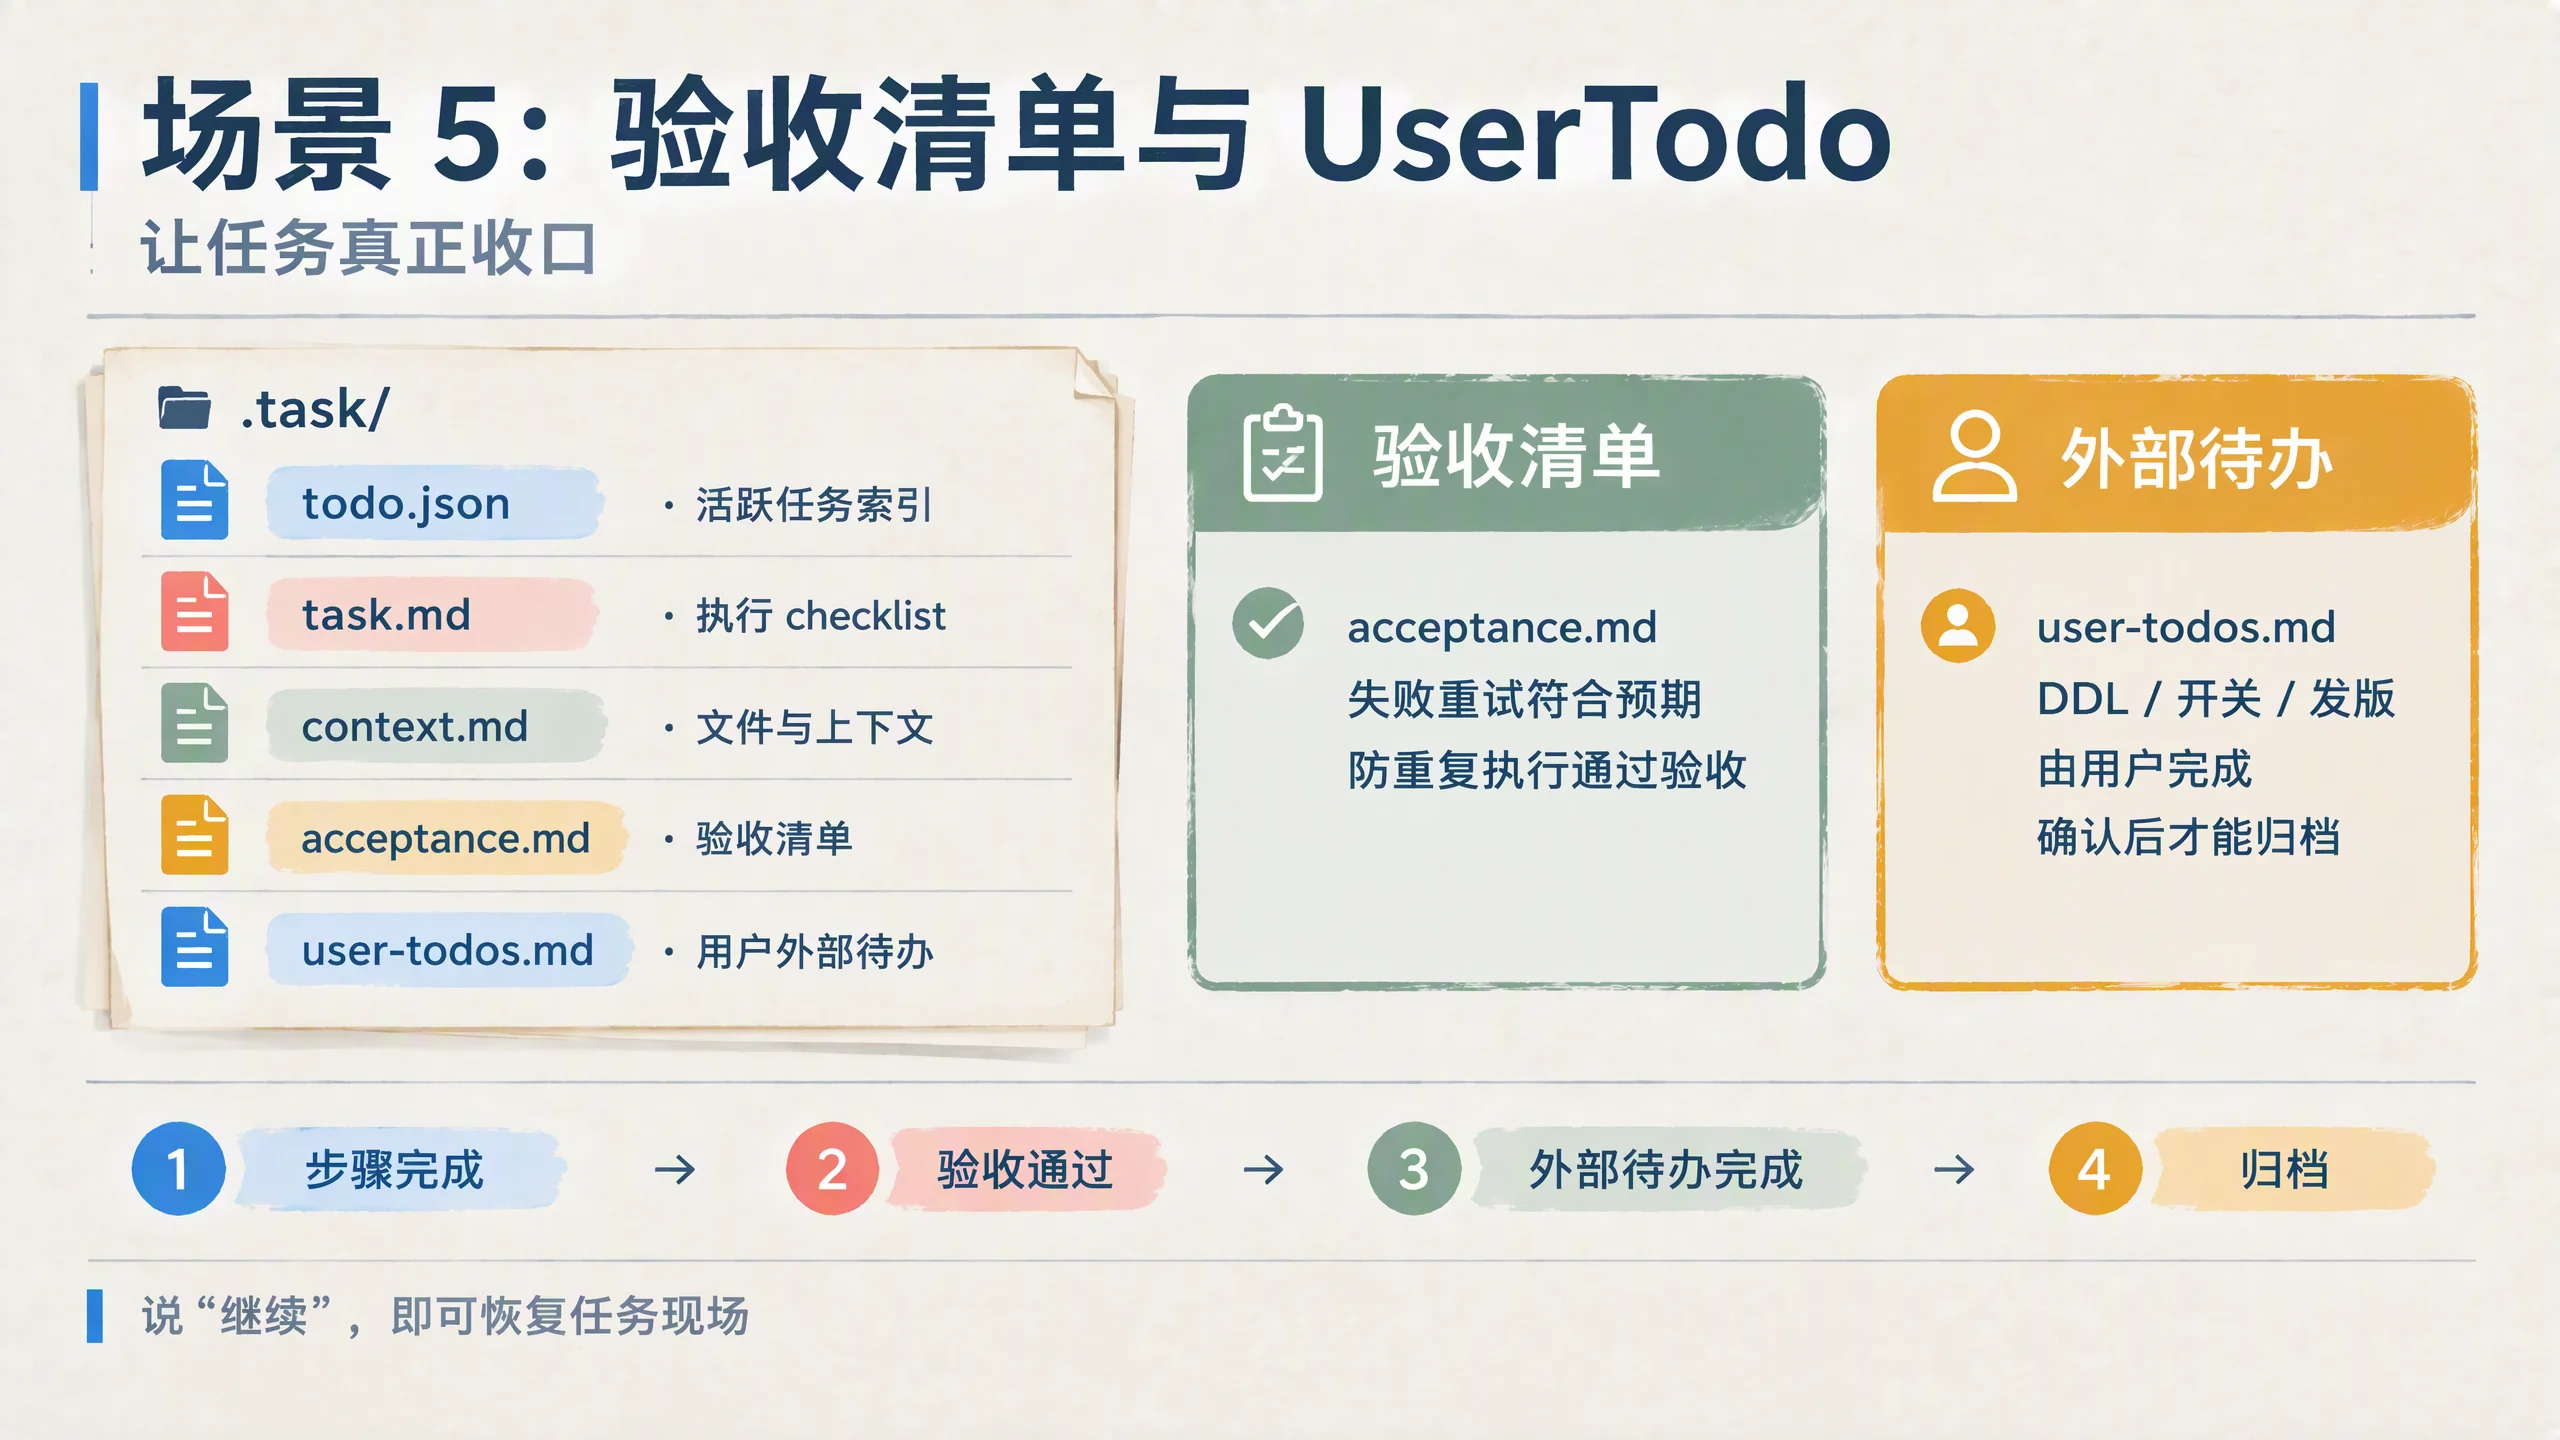
23 / 40 · 场景 5:验收清单与 UserTodo 让任务真正收口
24 / 40 · 使用效果与效率提升
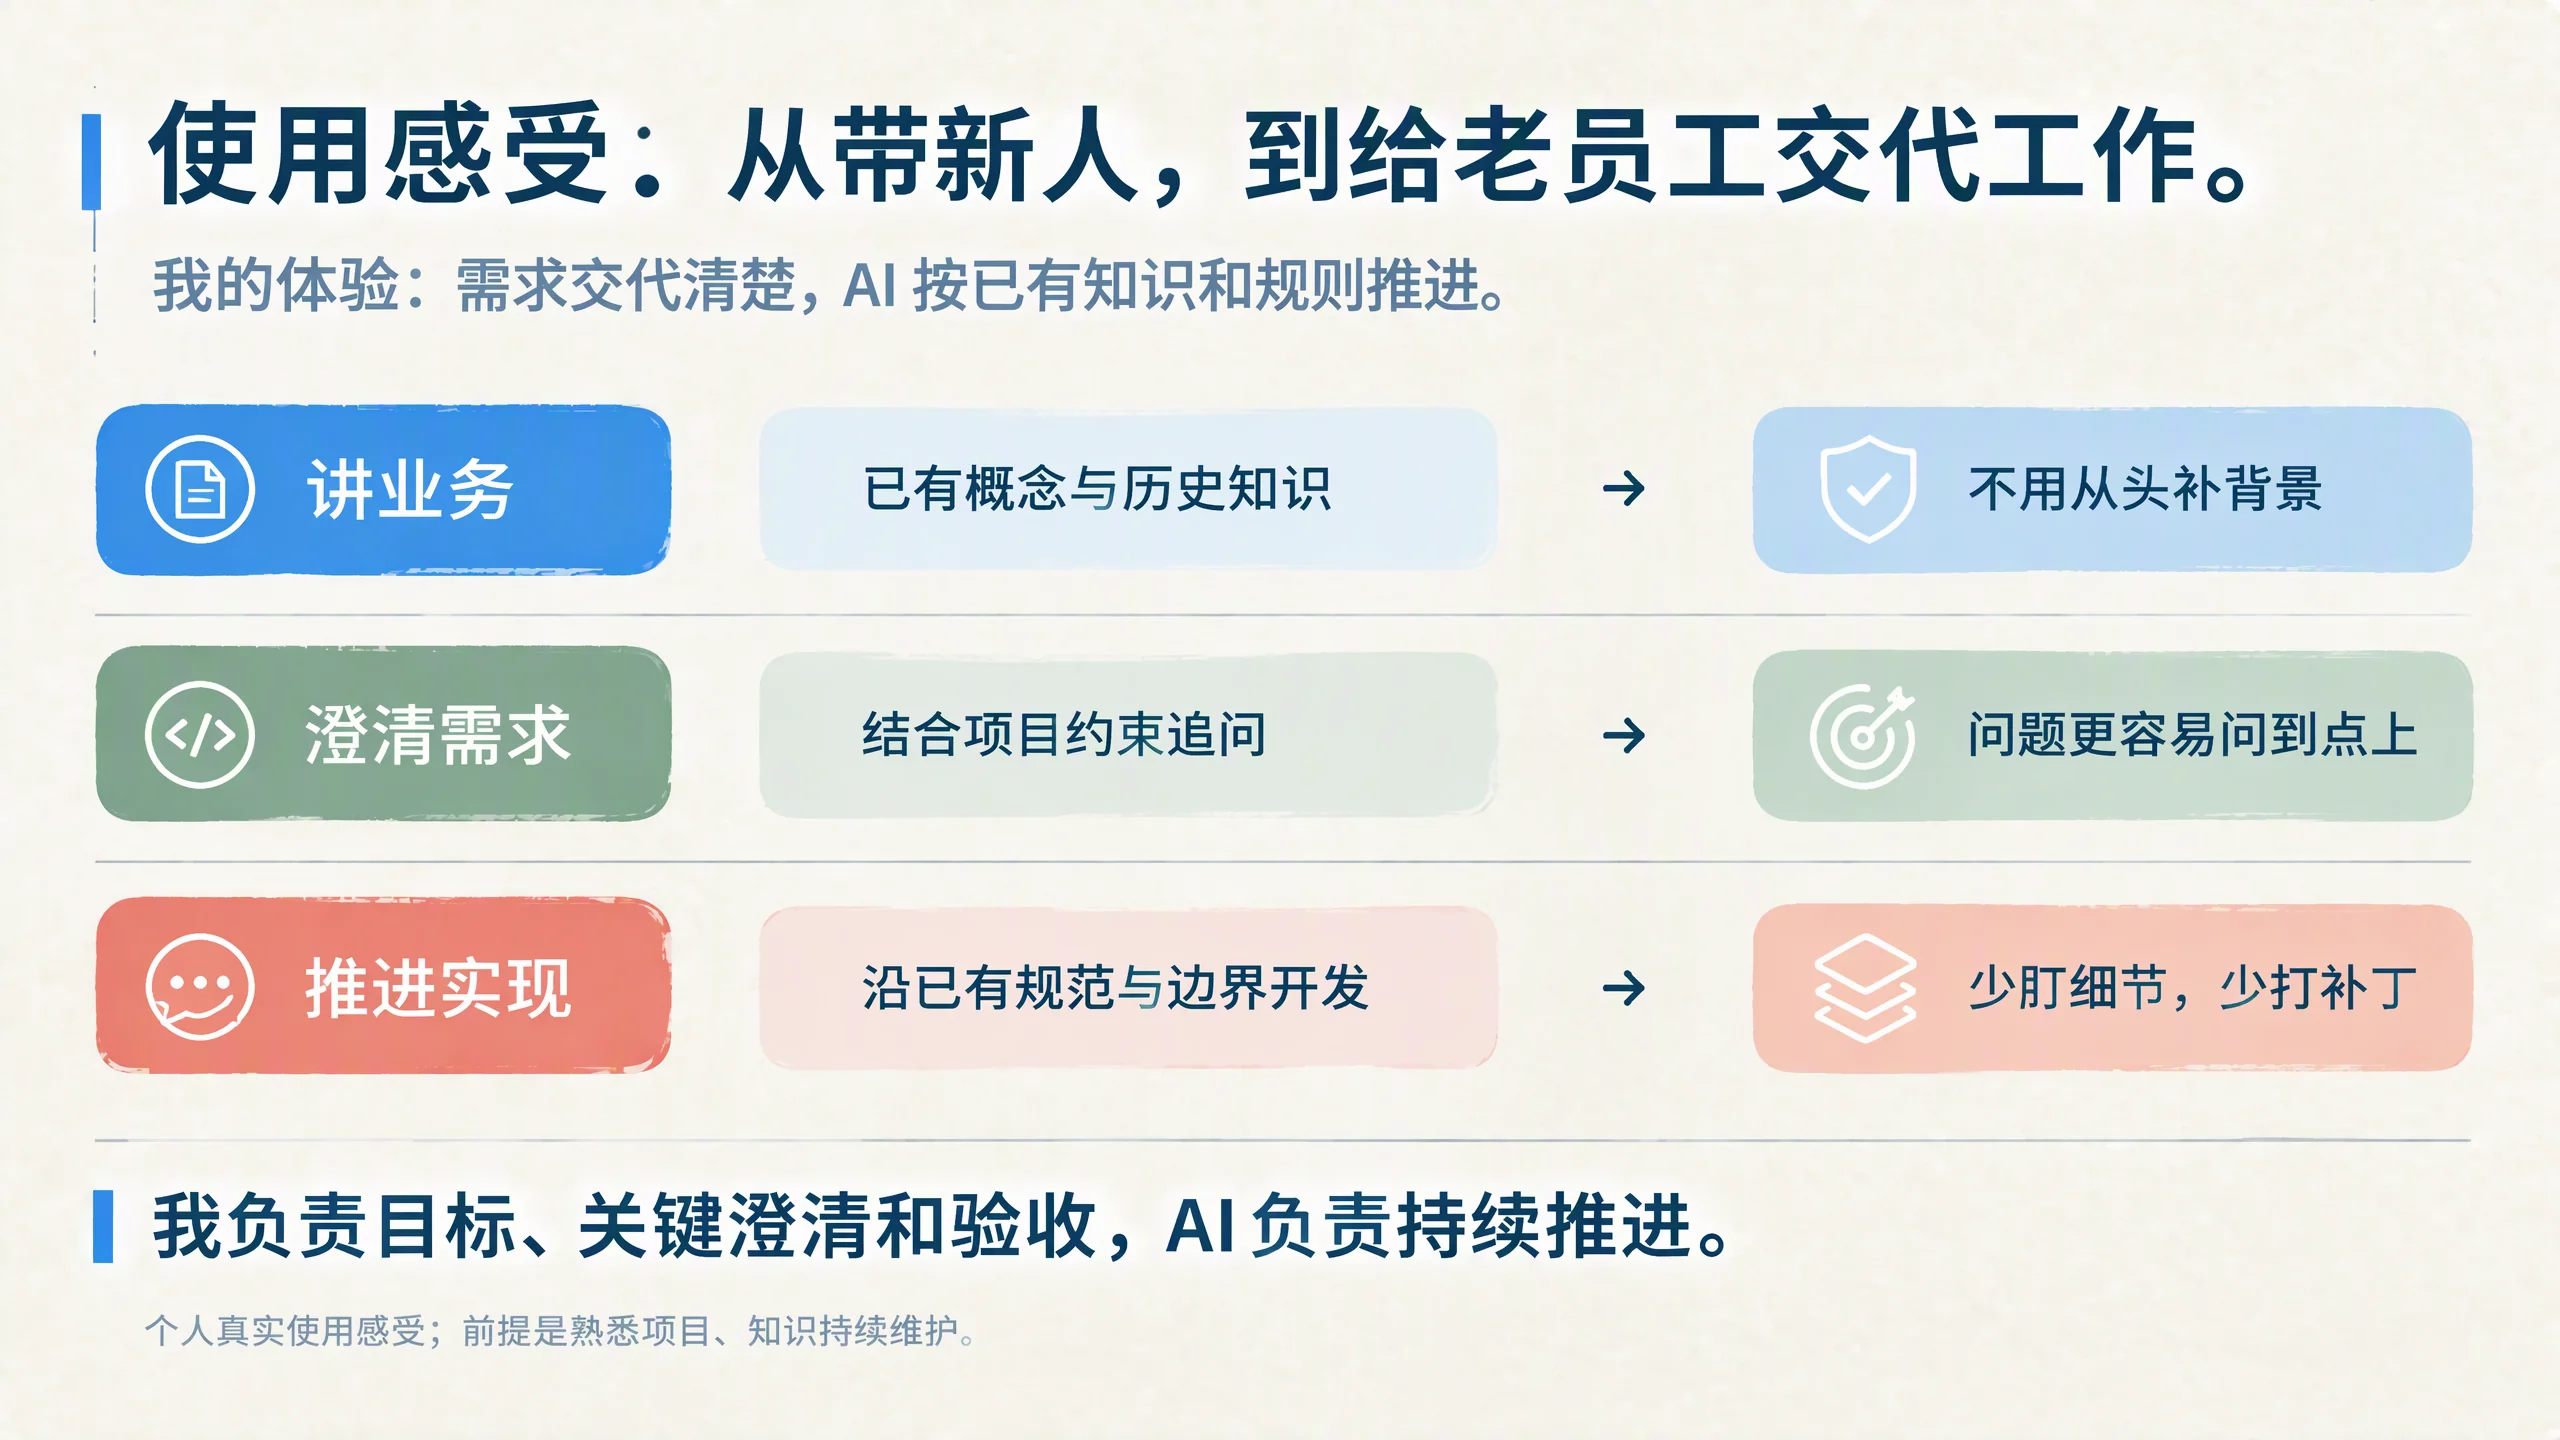
25 / 40 · 使用感受:从带新人,到给老员工交代工作
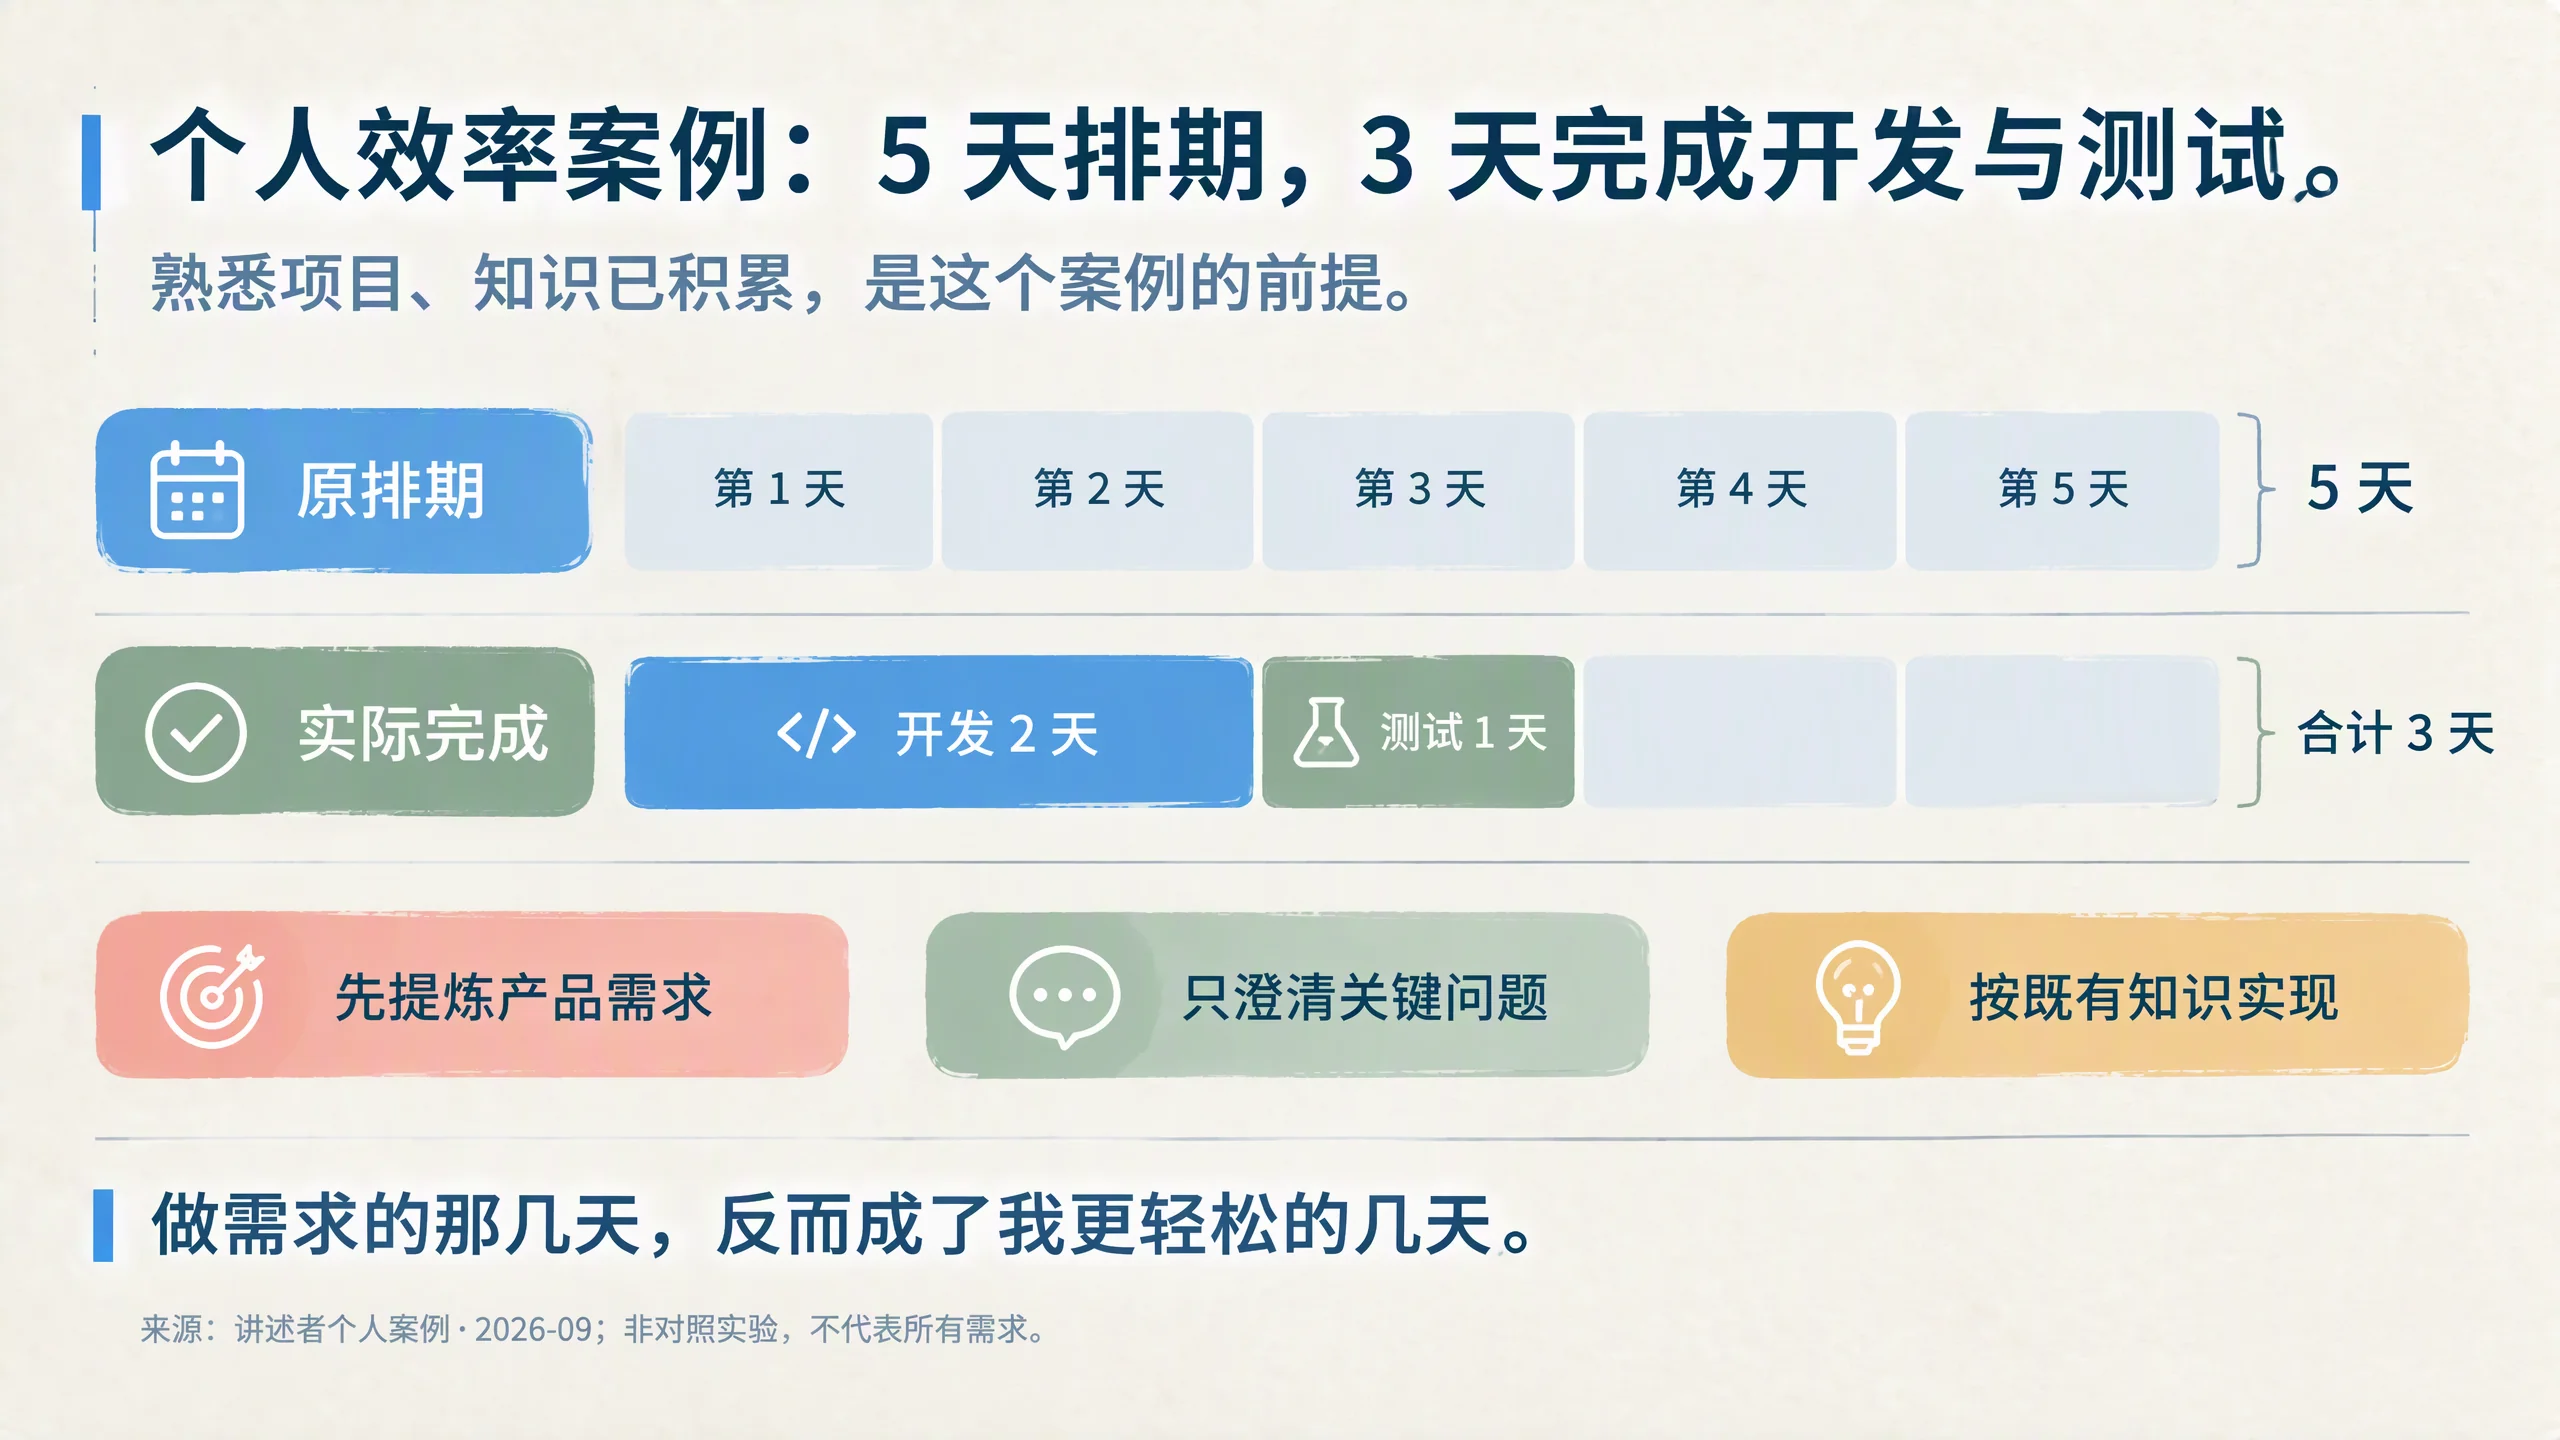
26 / 40 · 个人效率案例:5 天排期,3 天完成开发与测试
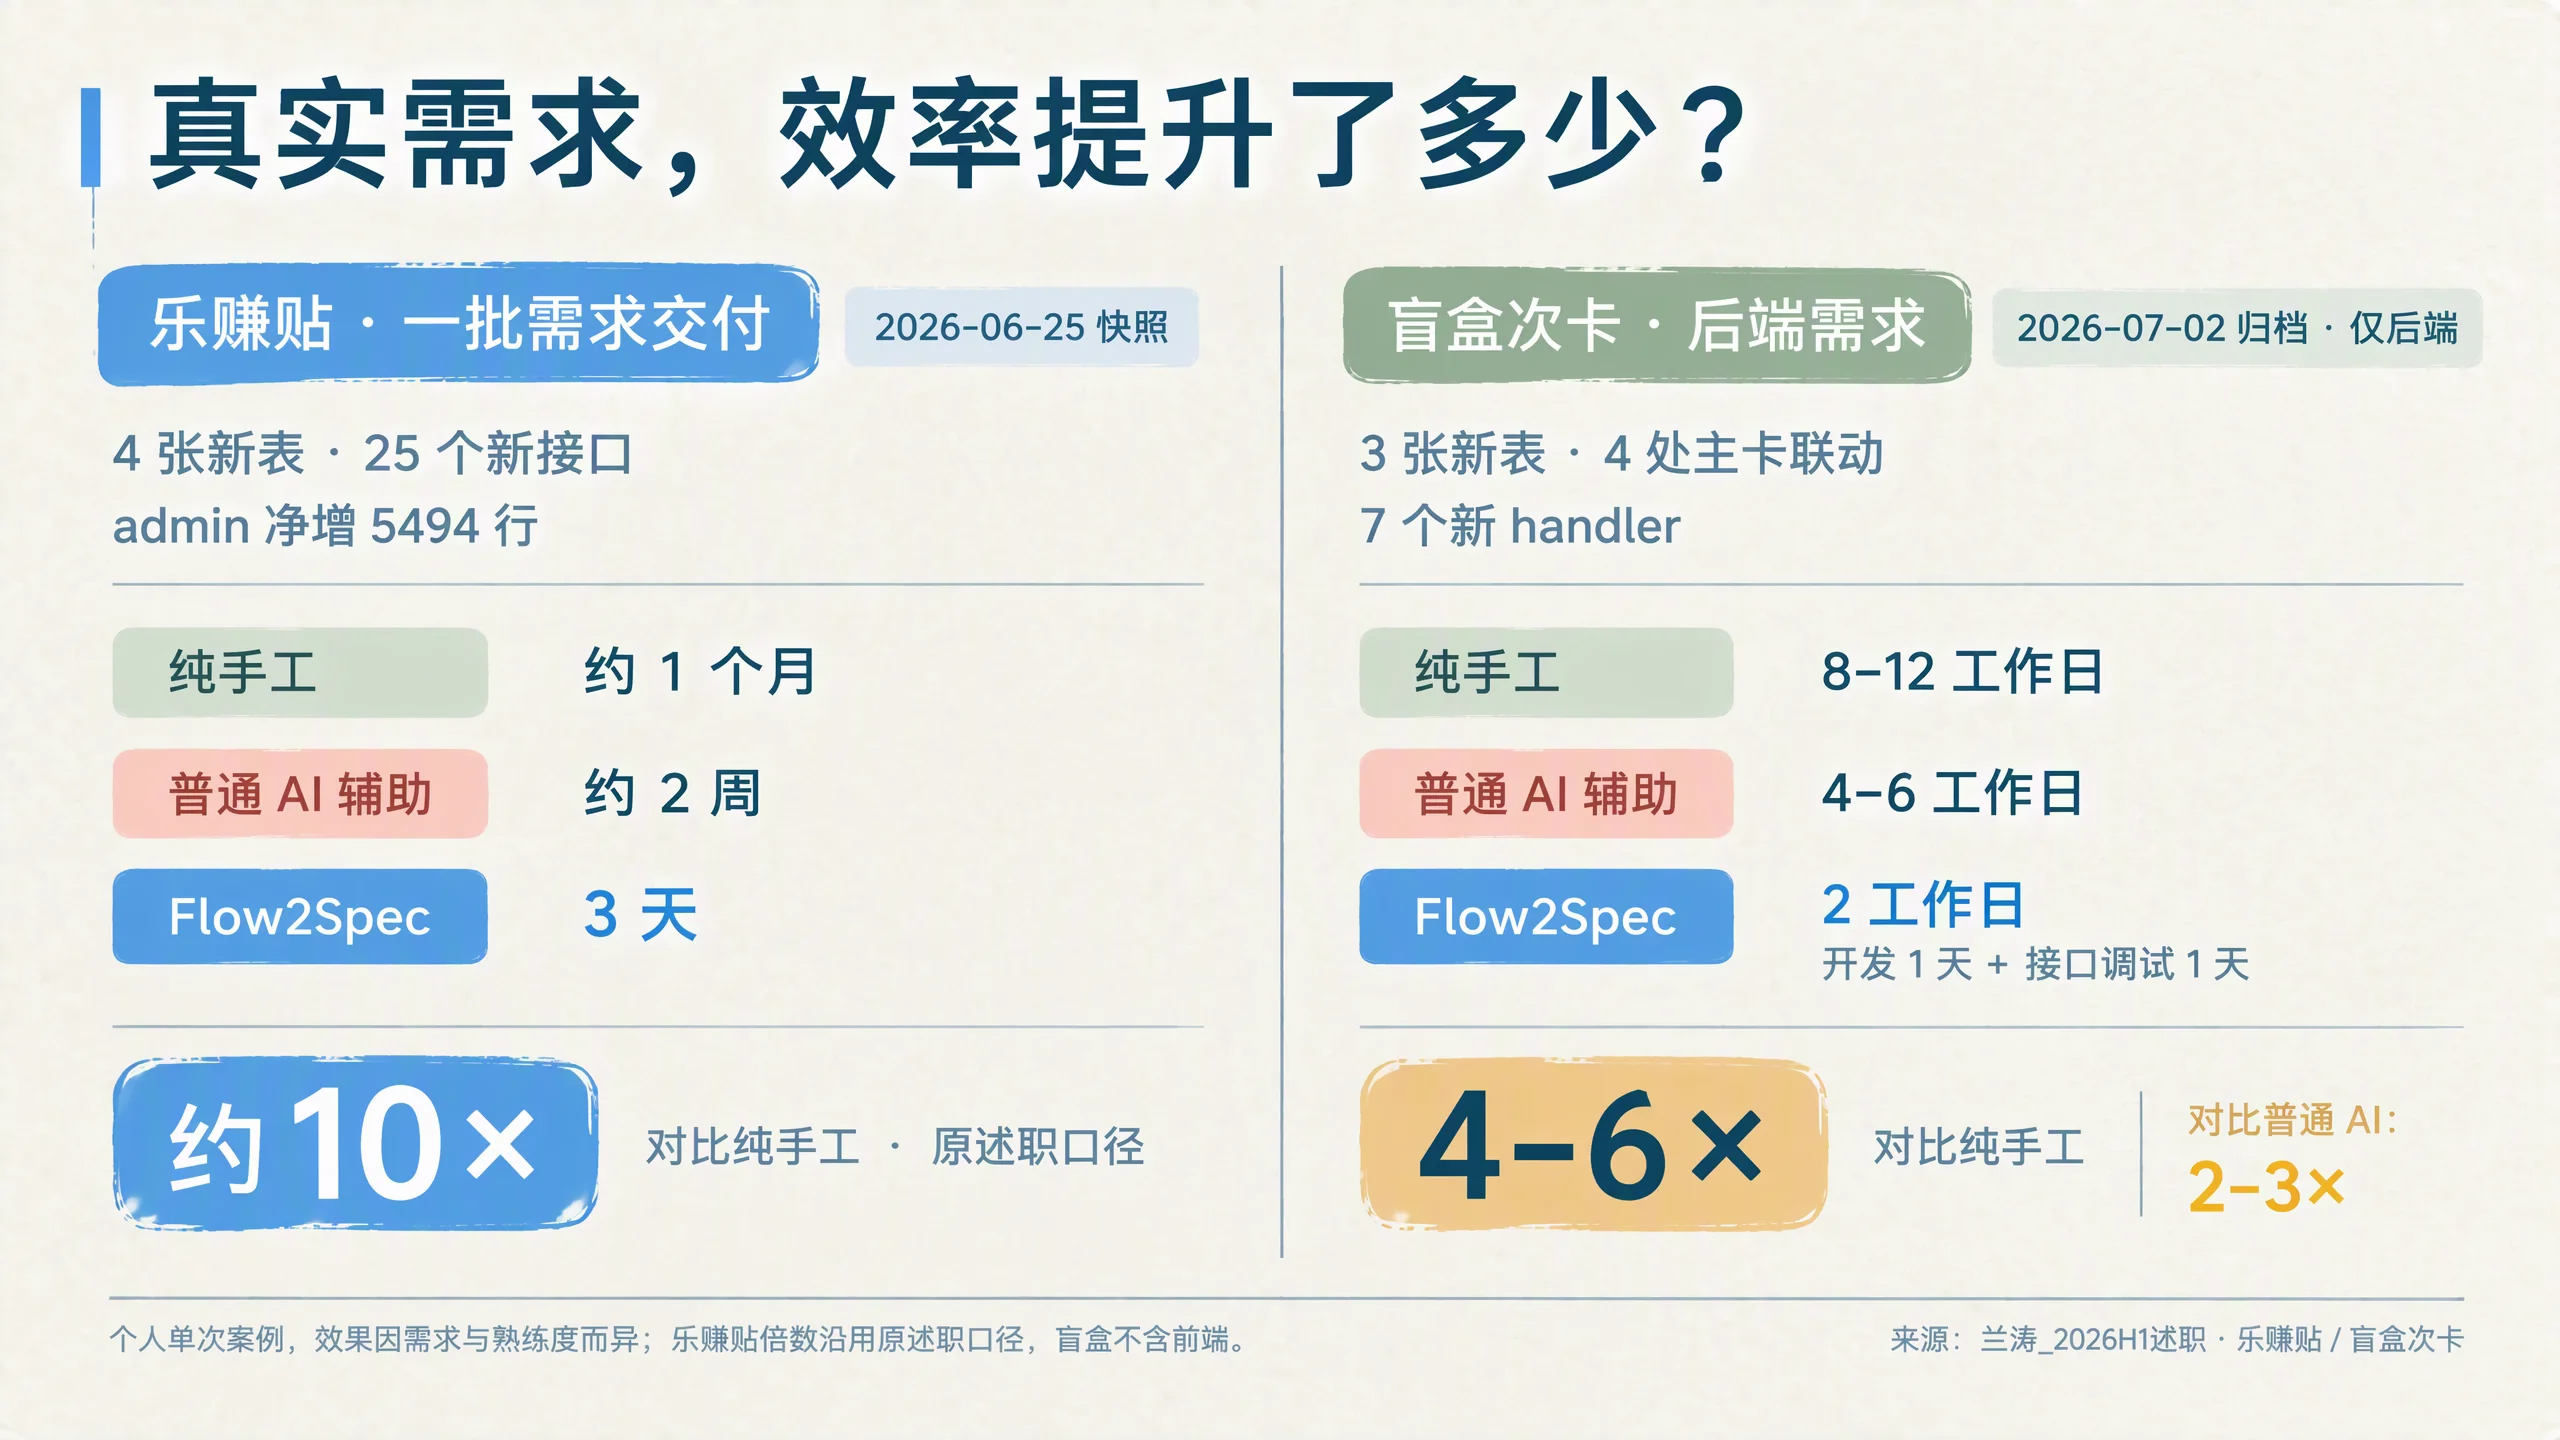
27 / 40 · 真实需求,效率提升了多少?
28 / 40 · 团队协作
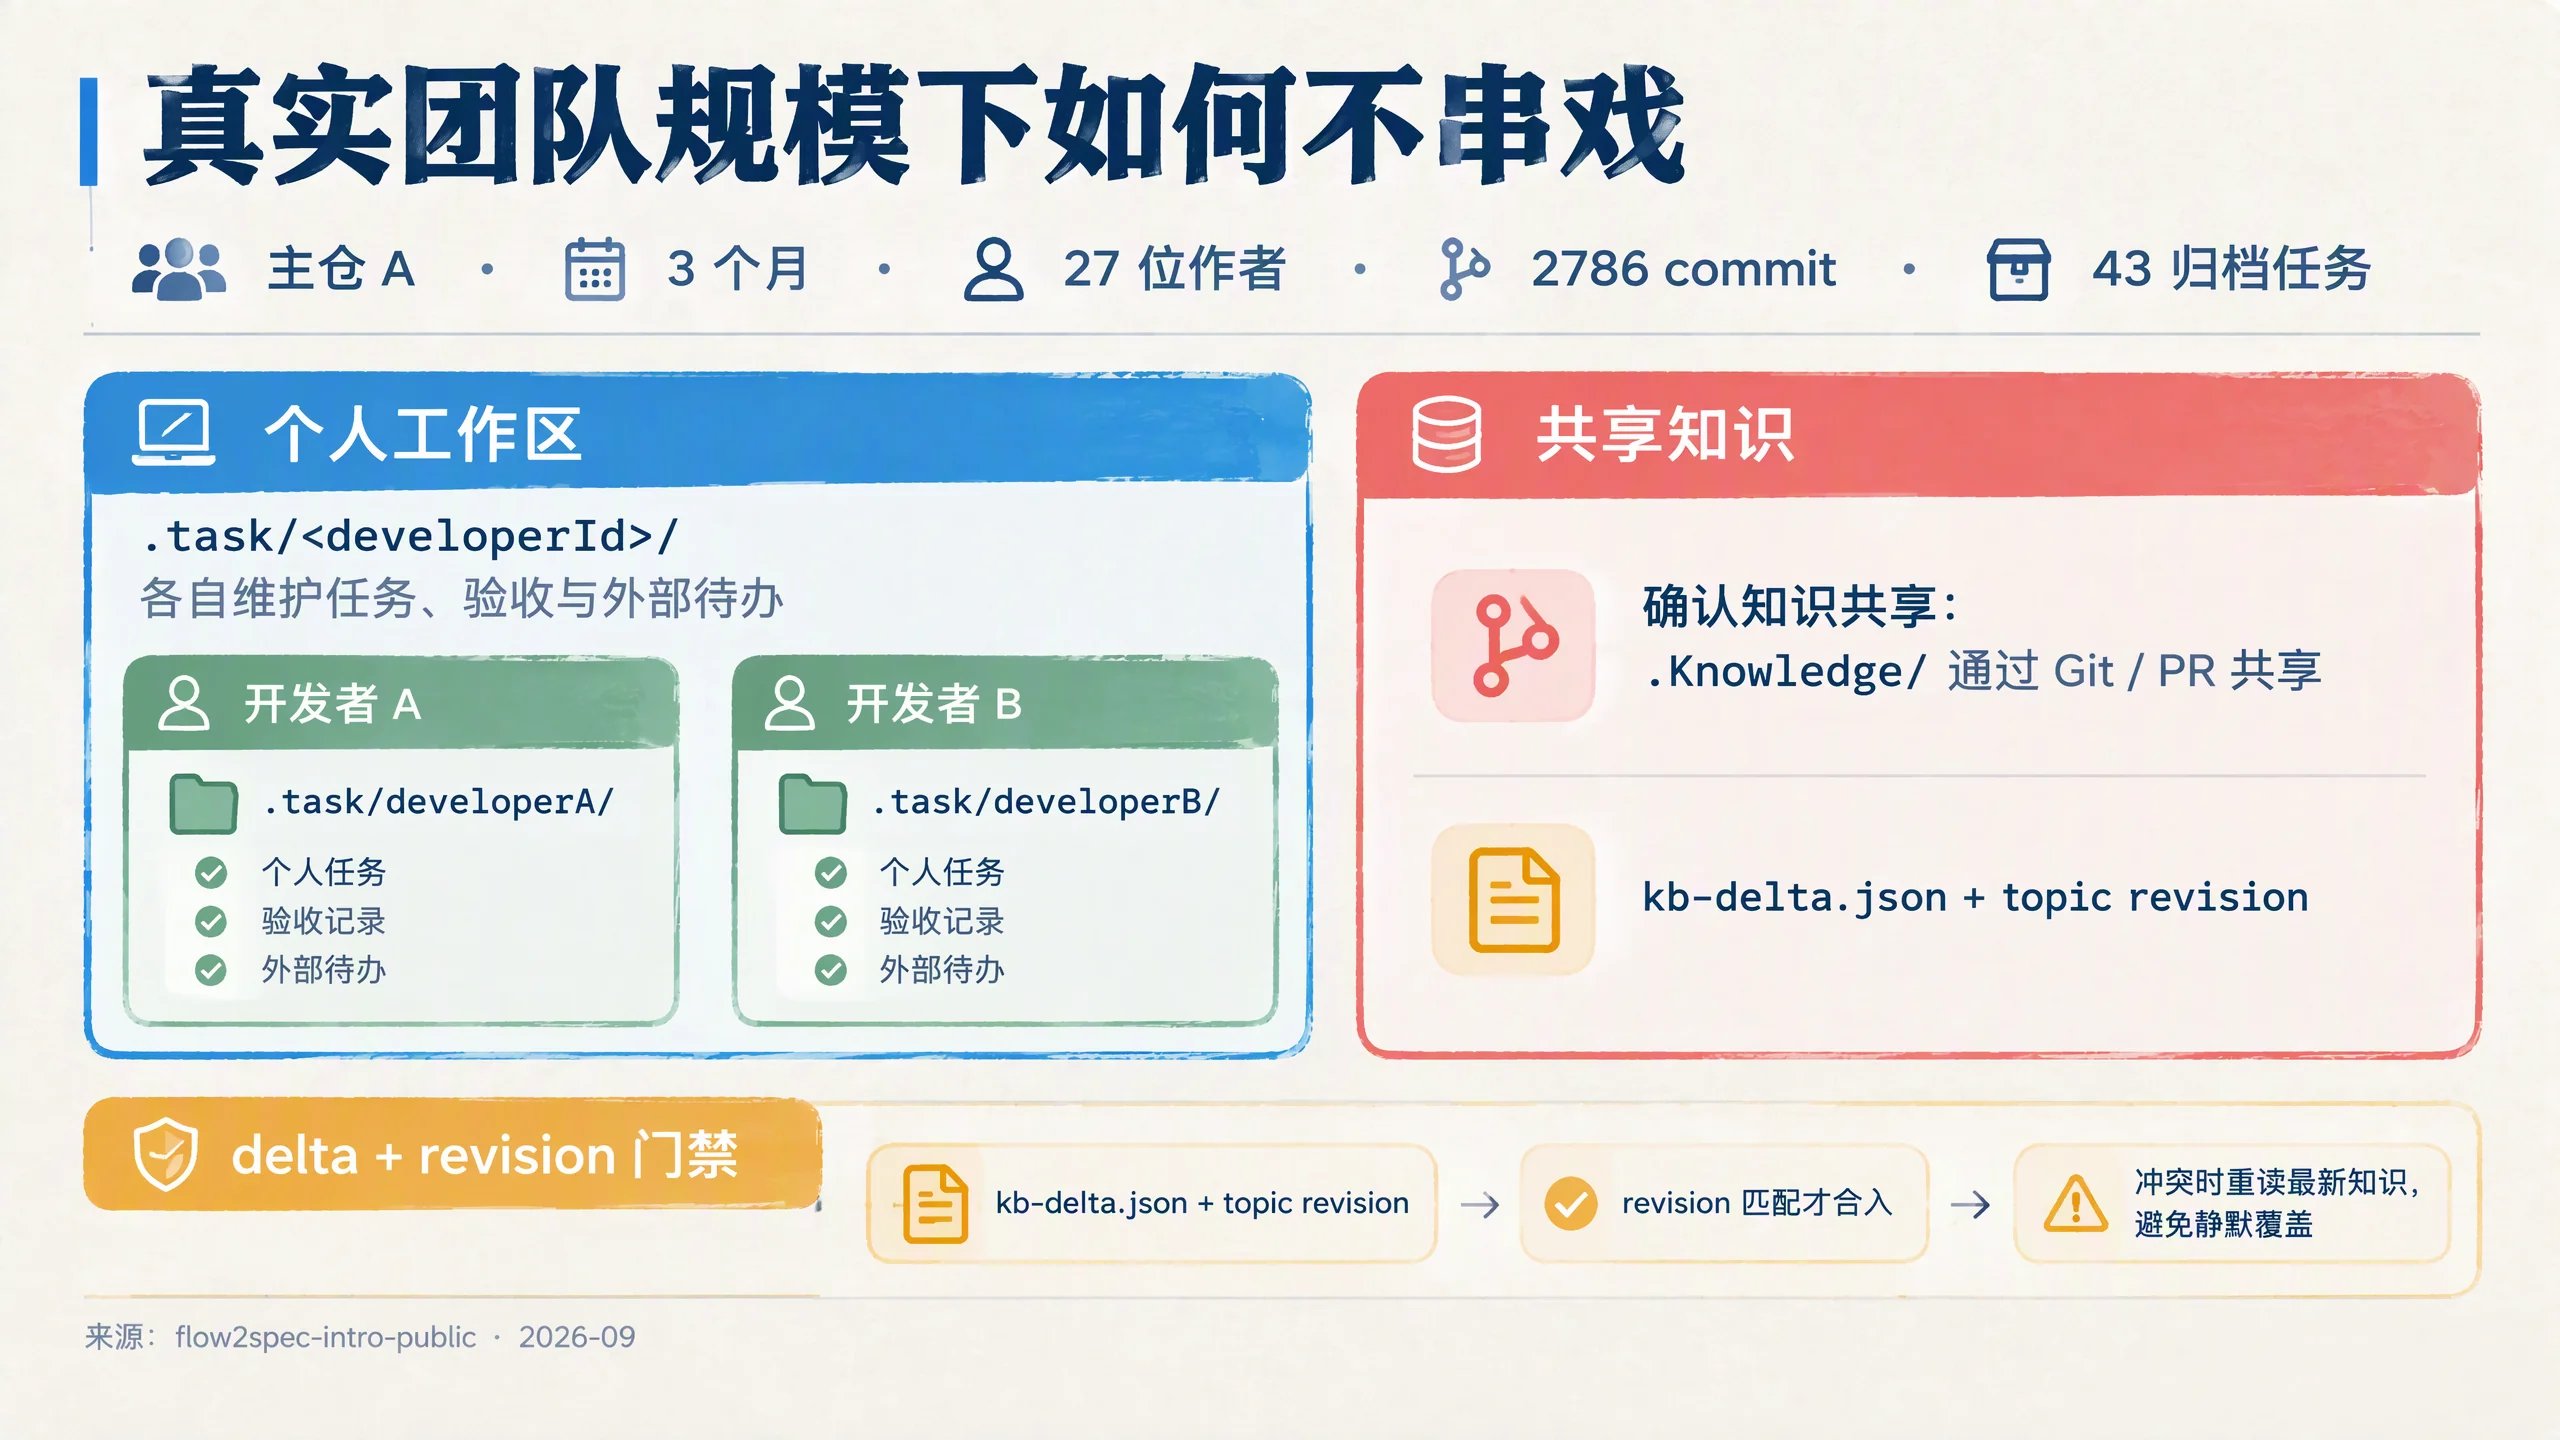
29 / 40 · 真实团队规模下如何不串戏
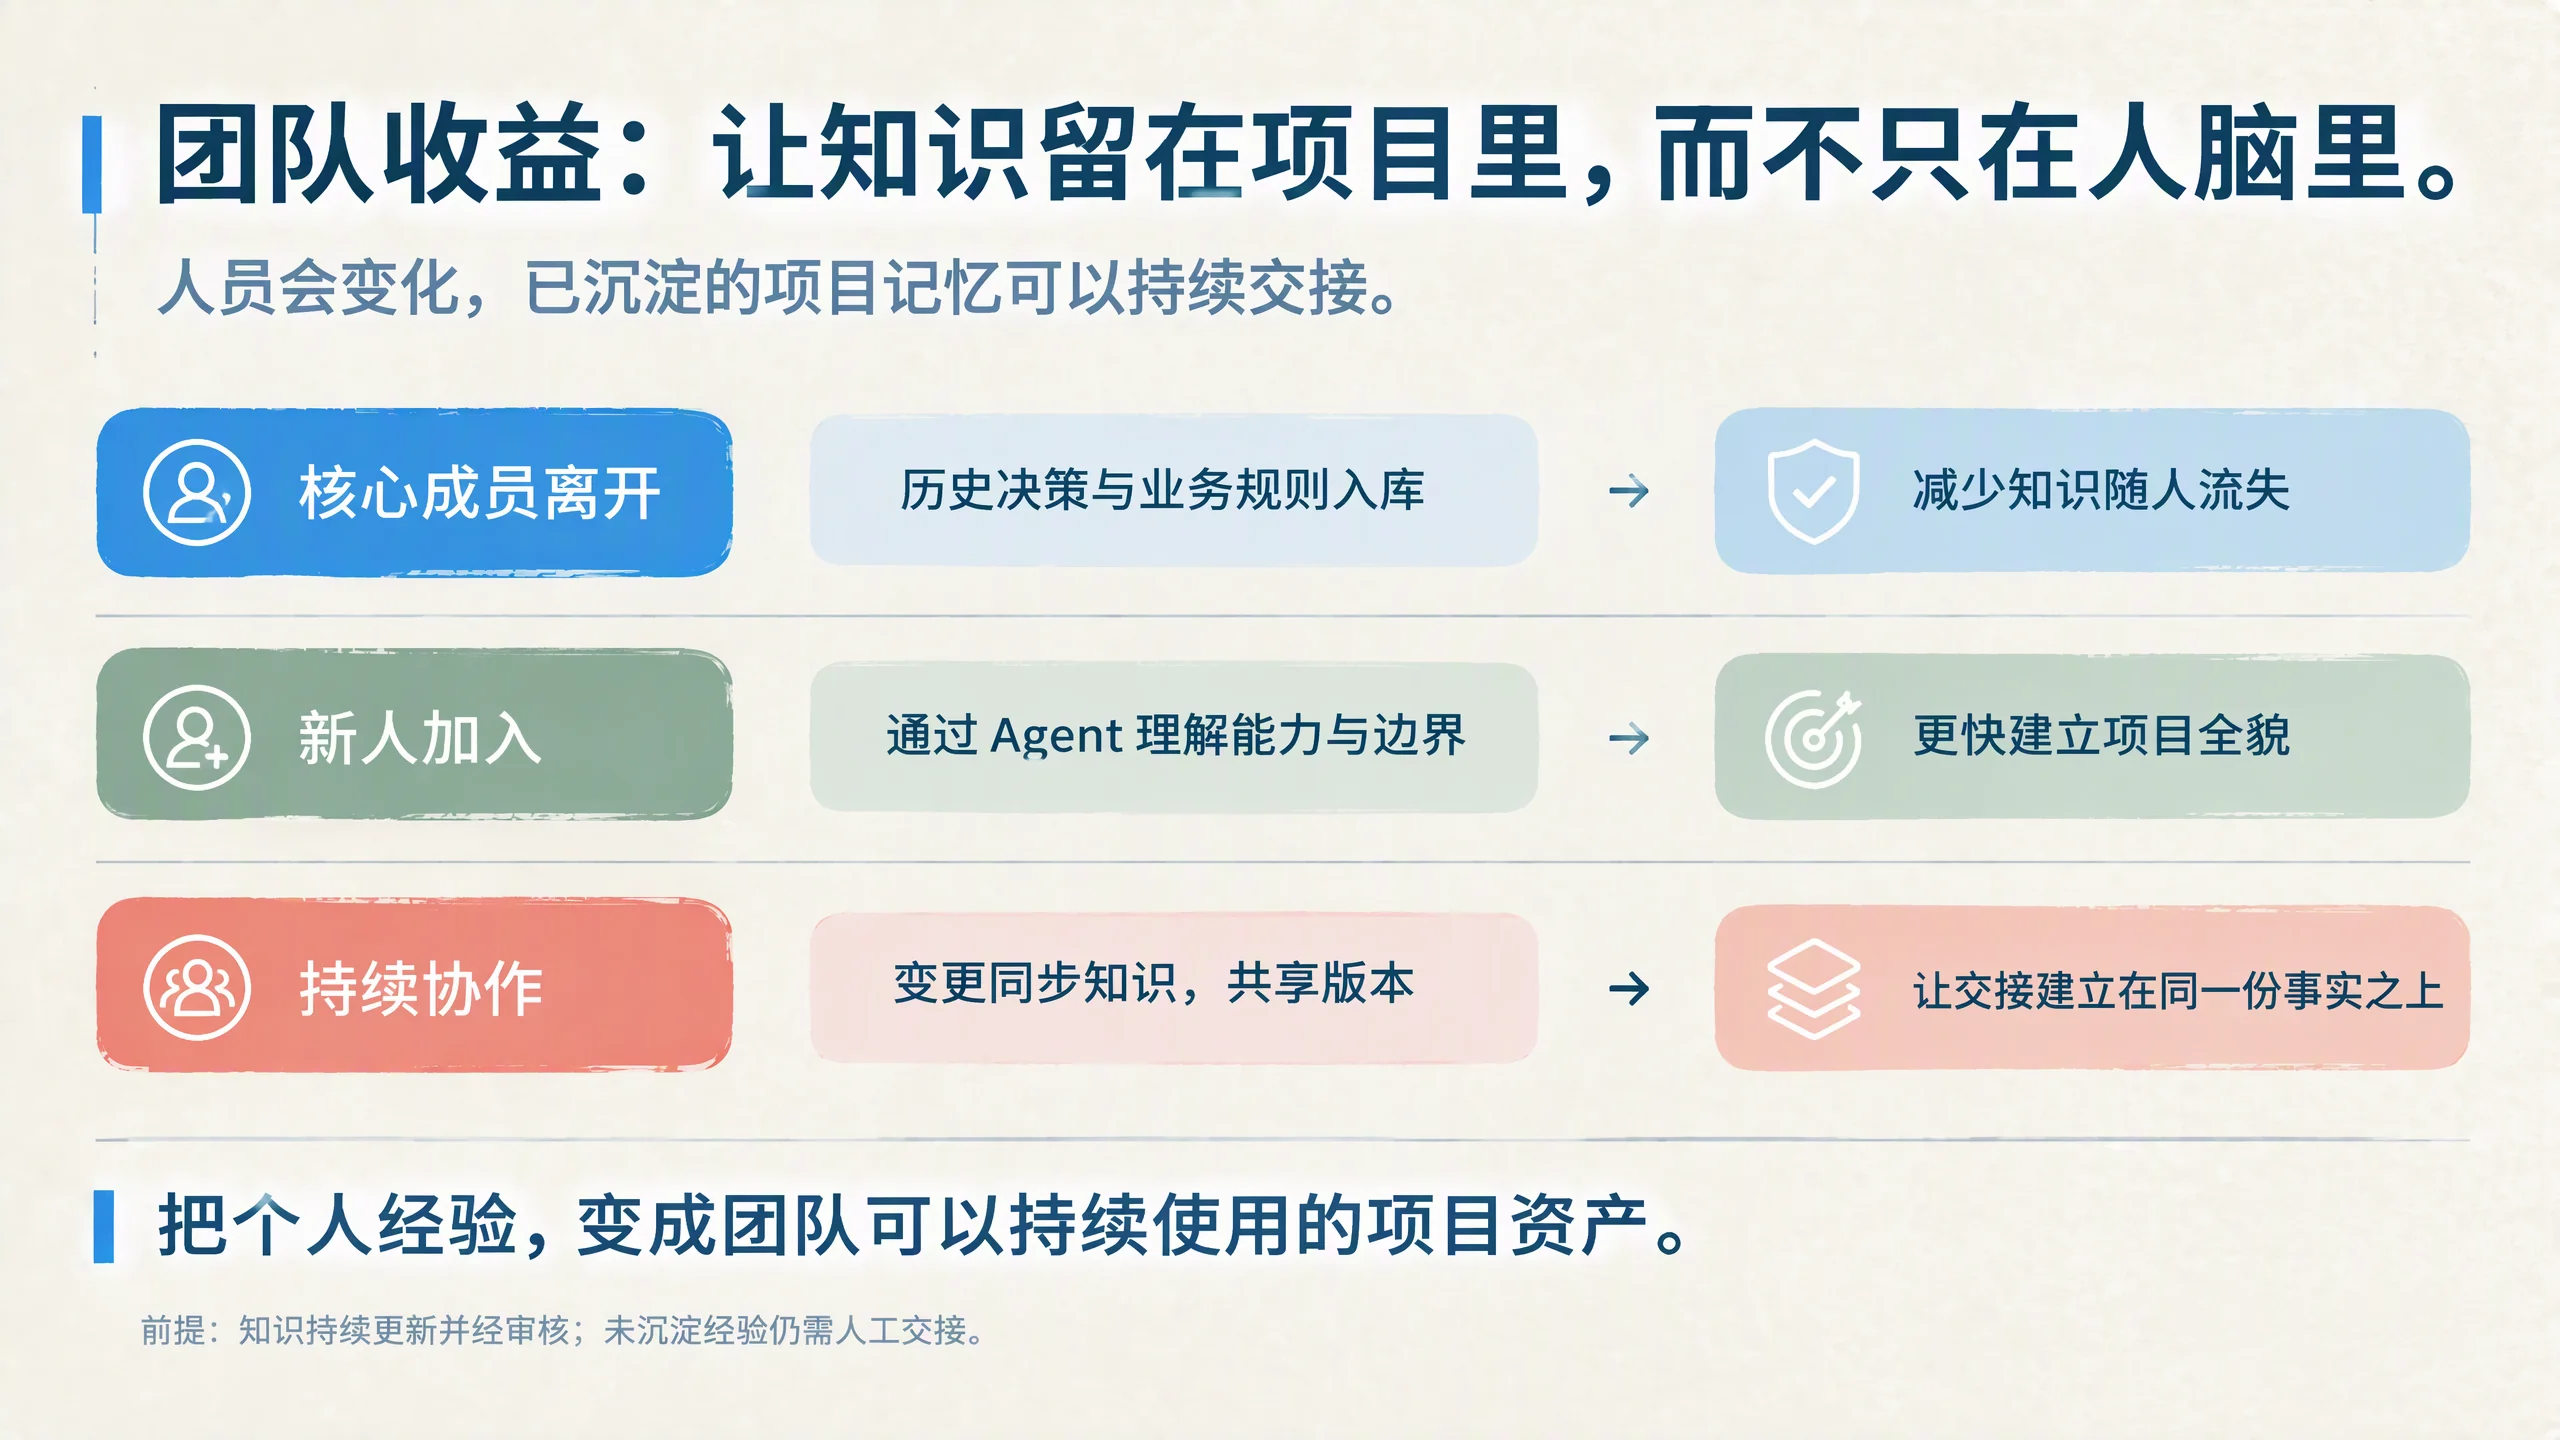
30 / 40 · 团队收益:让知识留在项目里,而不只在人脑里
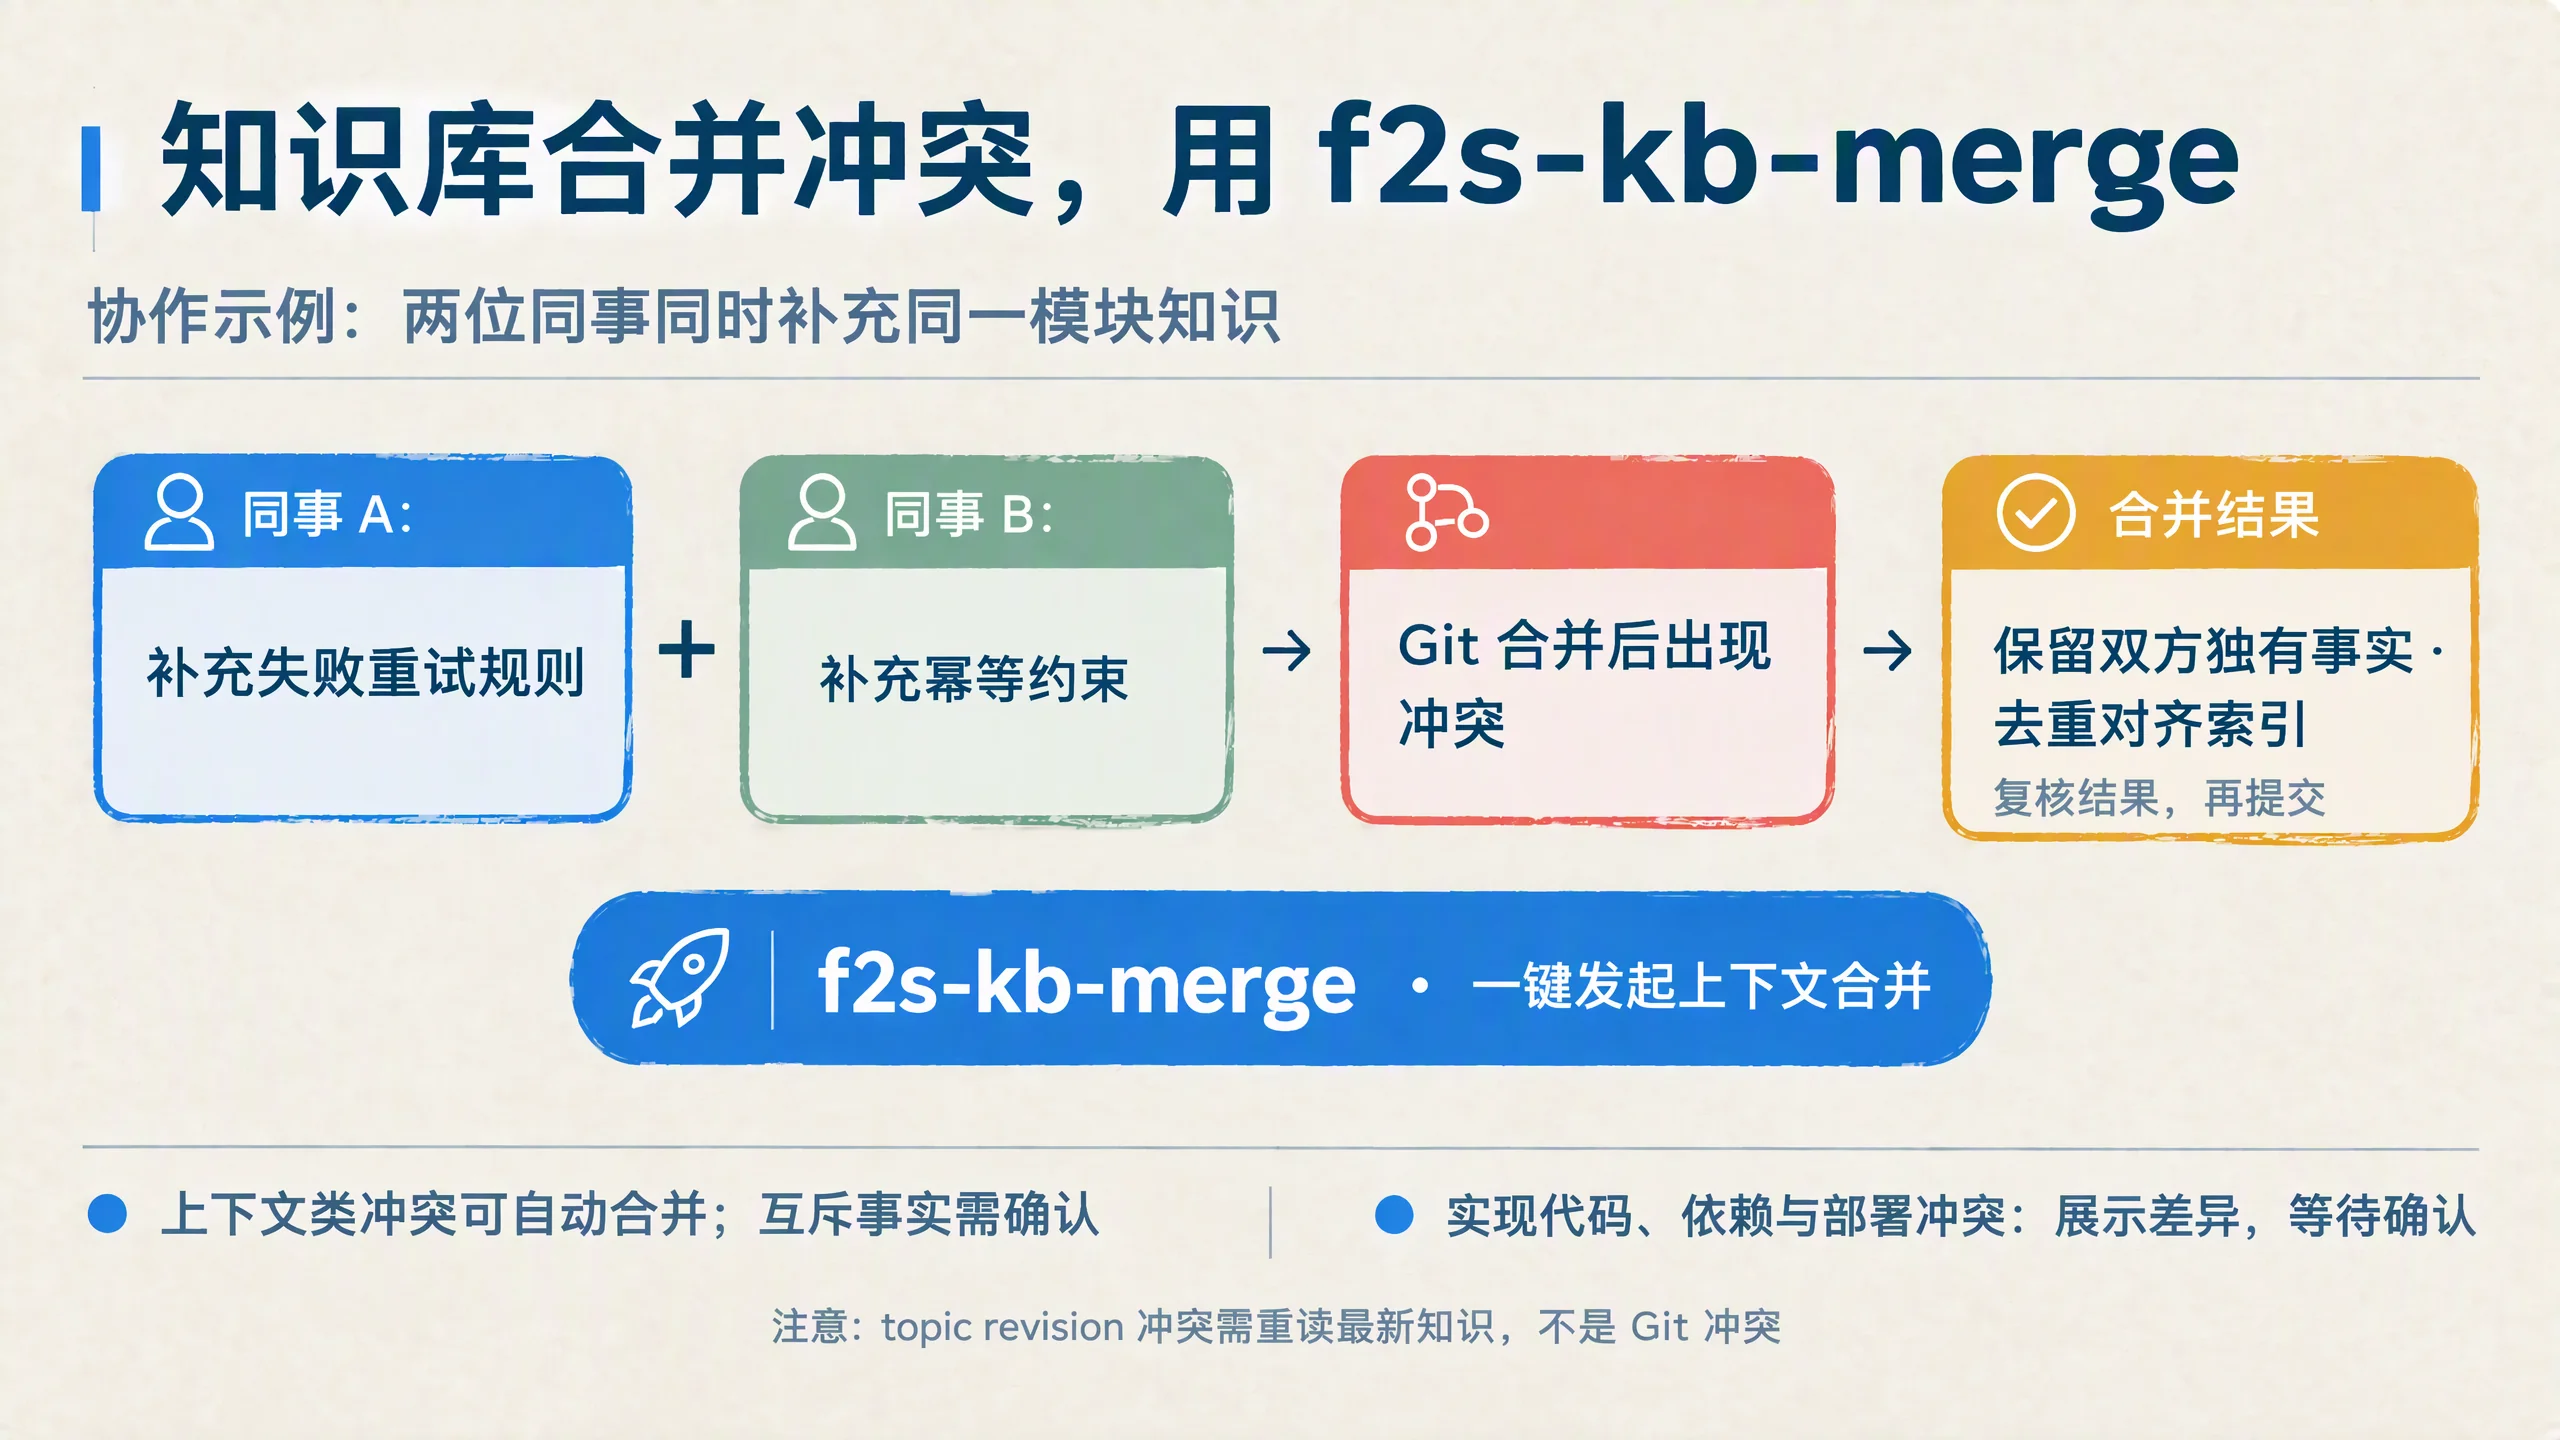
31 / 40 · 知识库合并冲突,用 f2s-kb-merge
32 / 40 · 其他
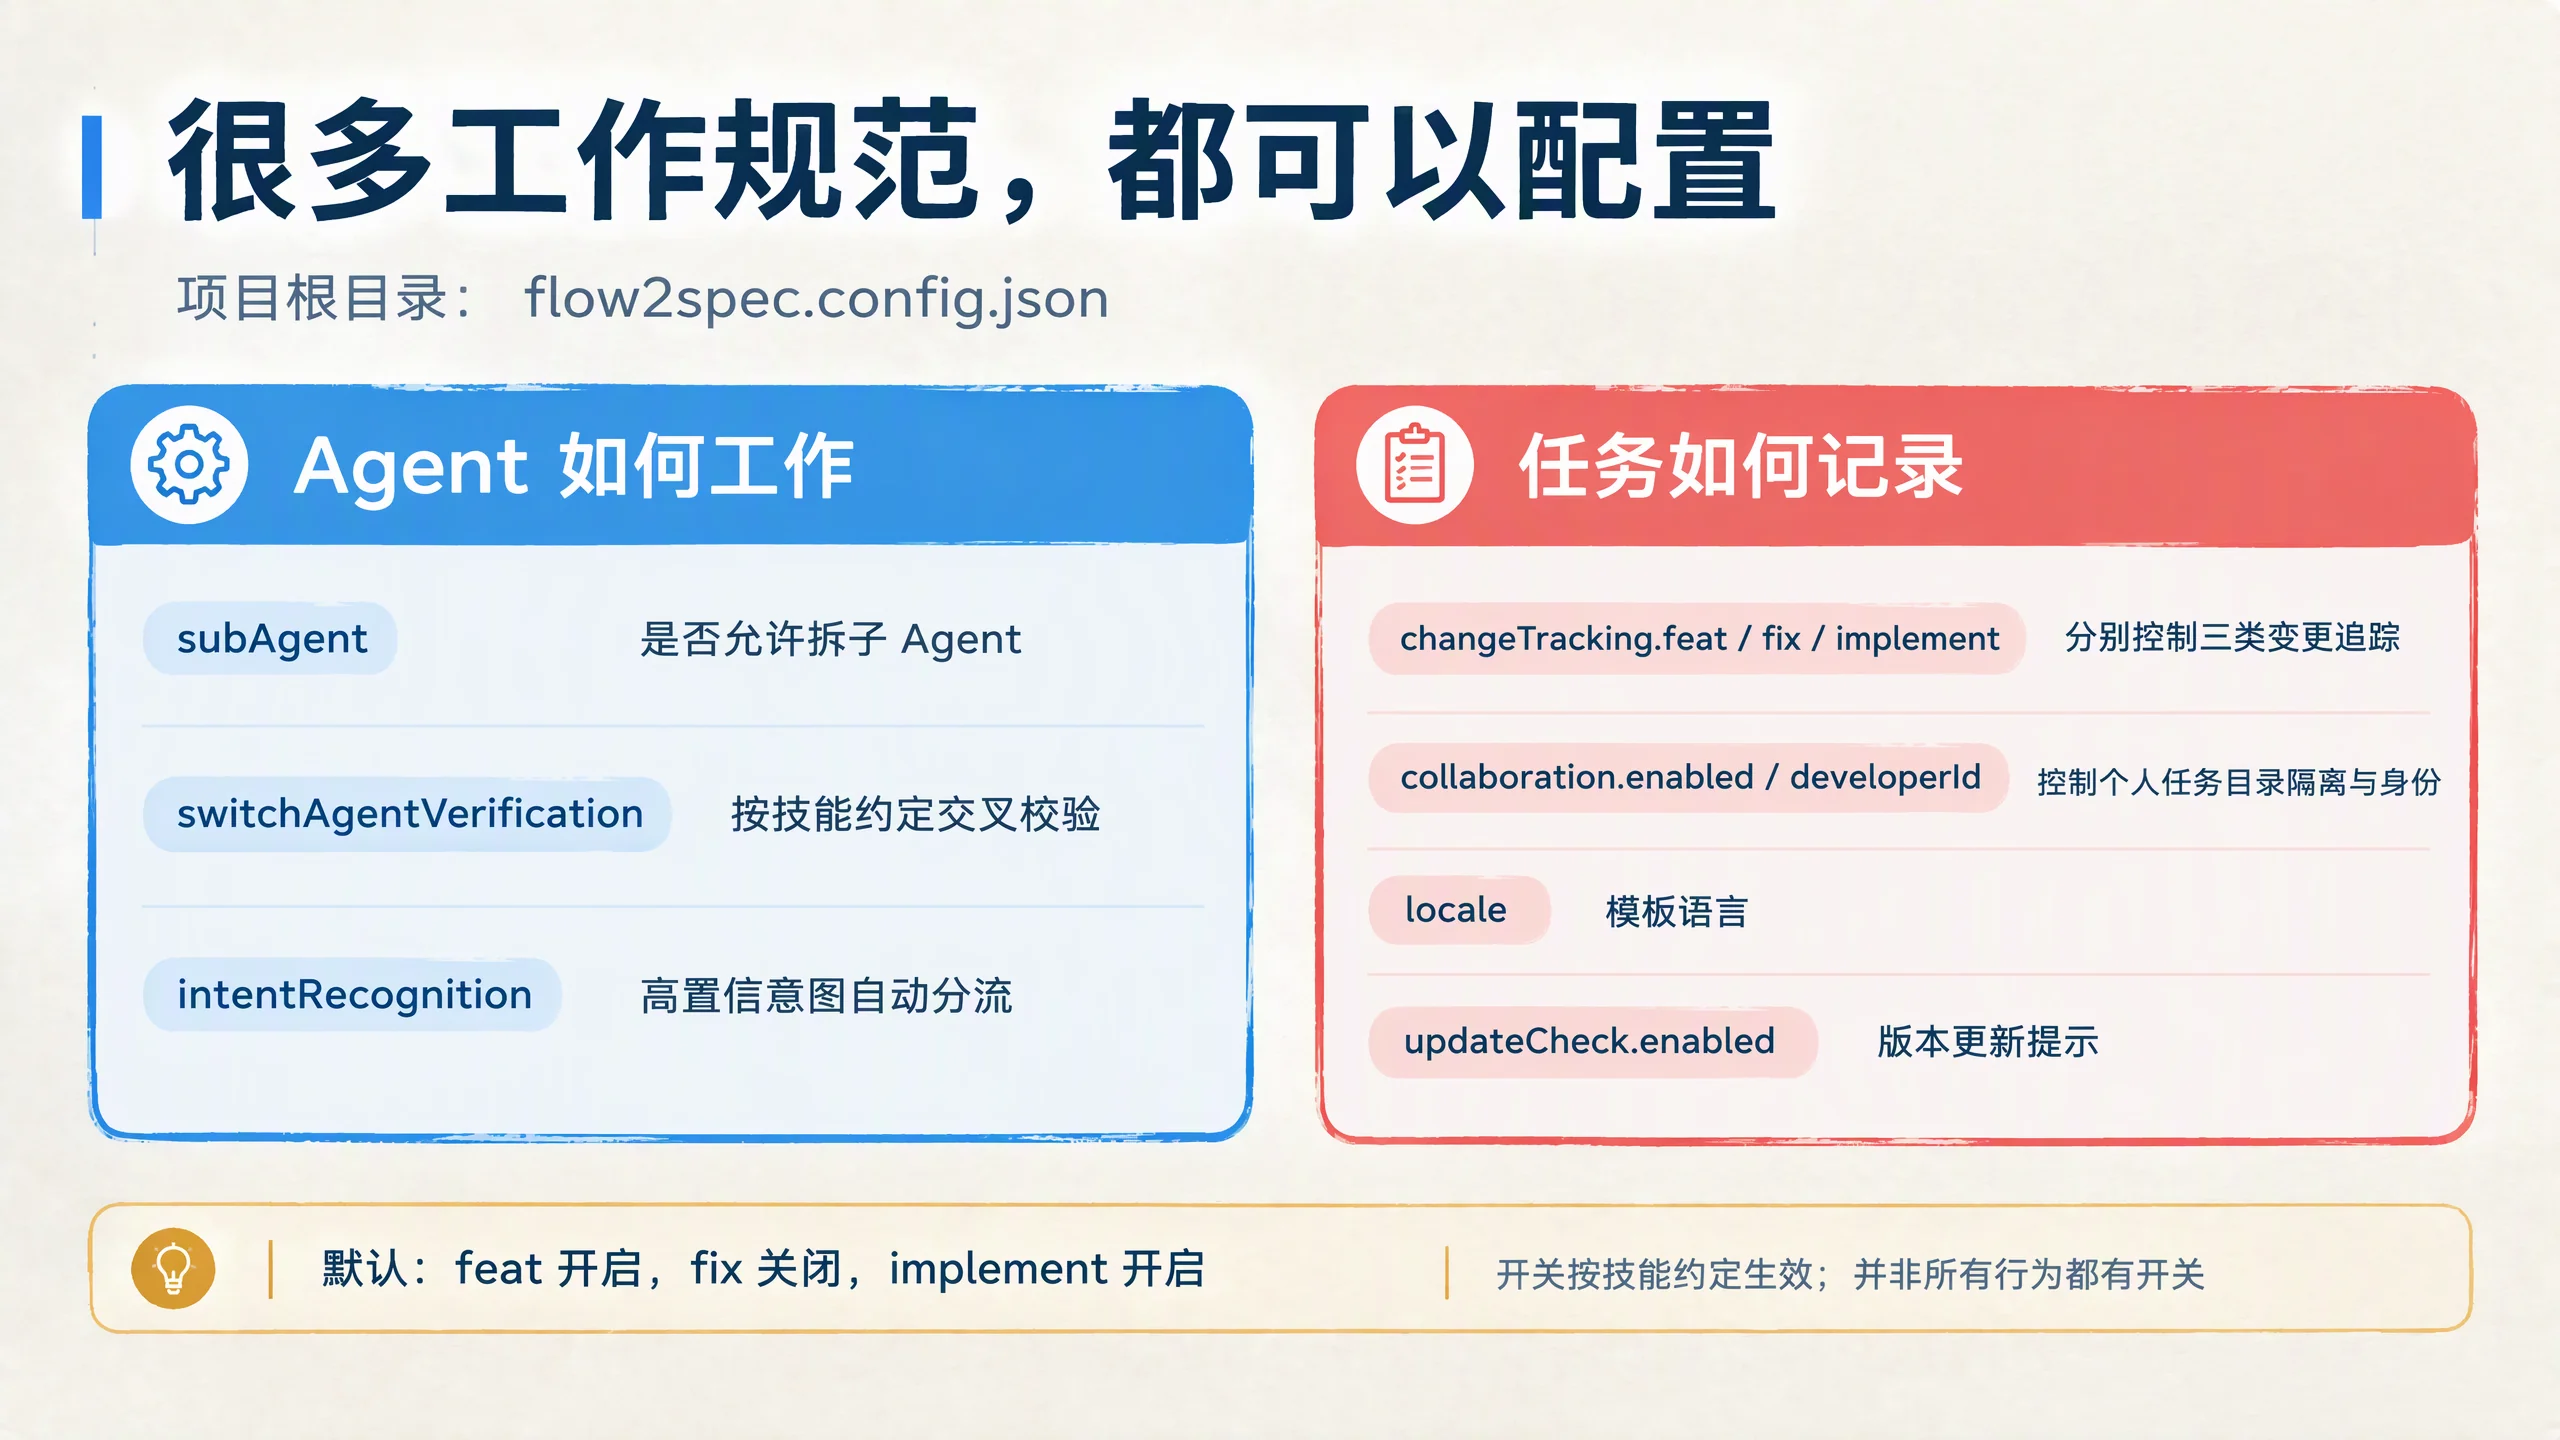
33 / 40 · 很多工作规范,都可以配置
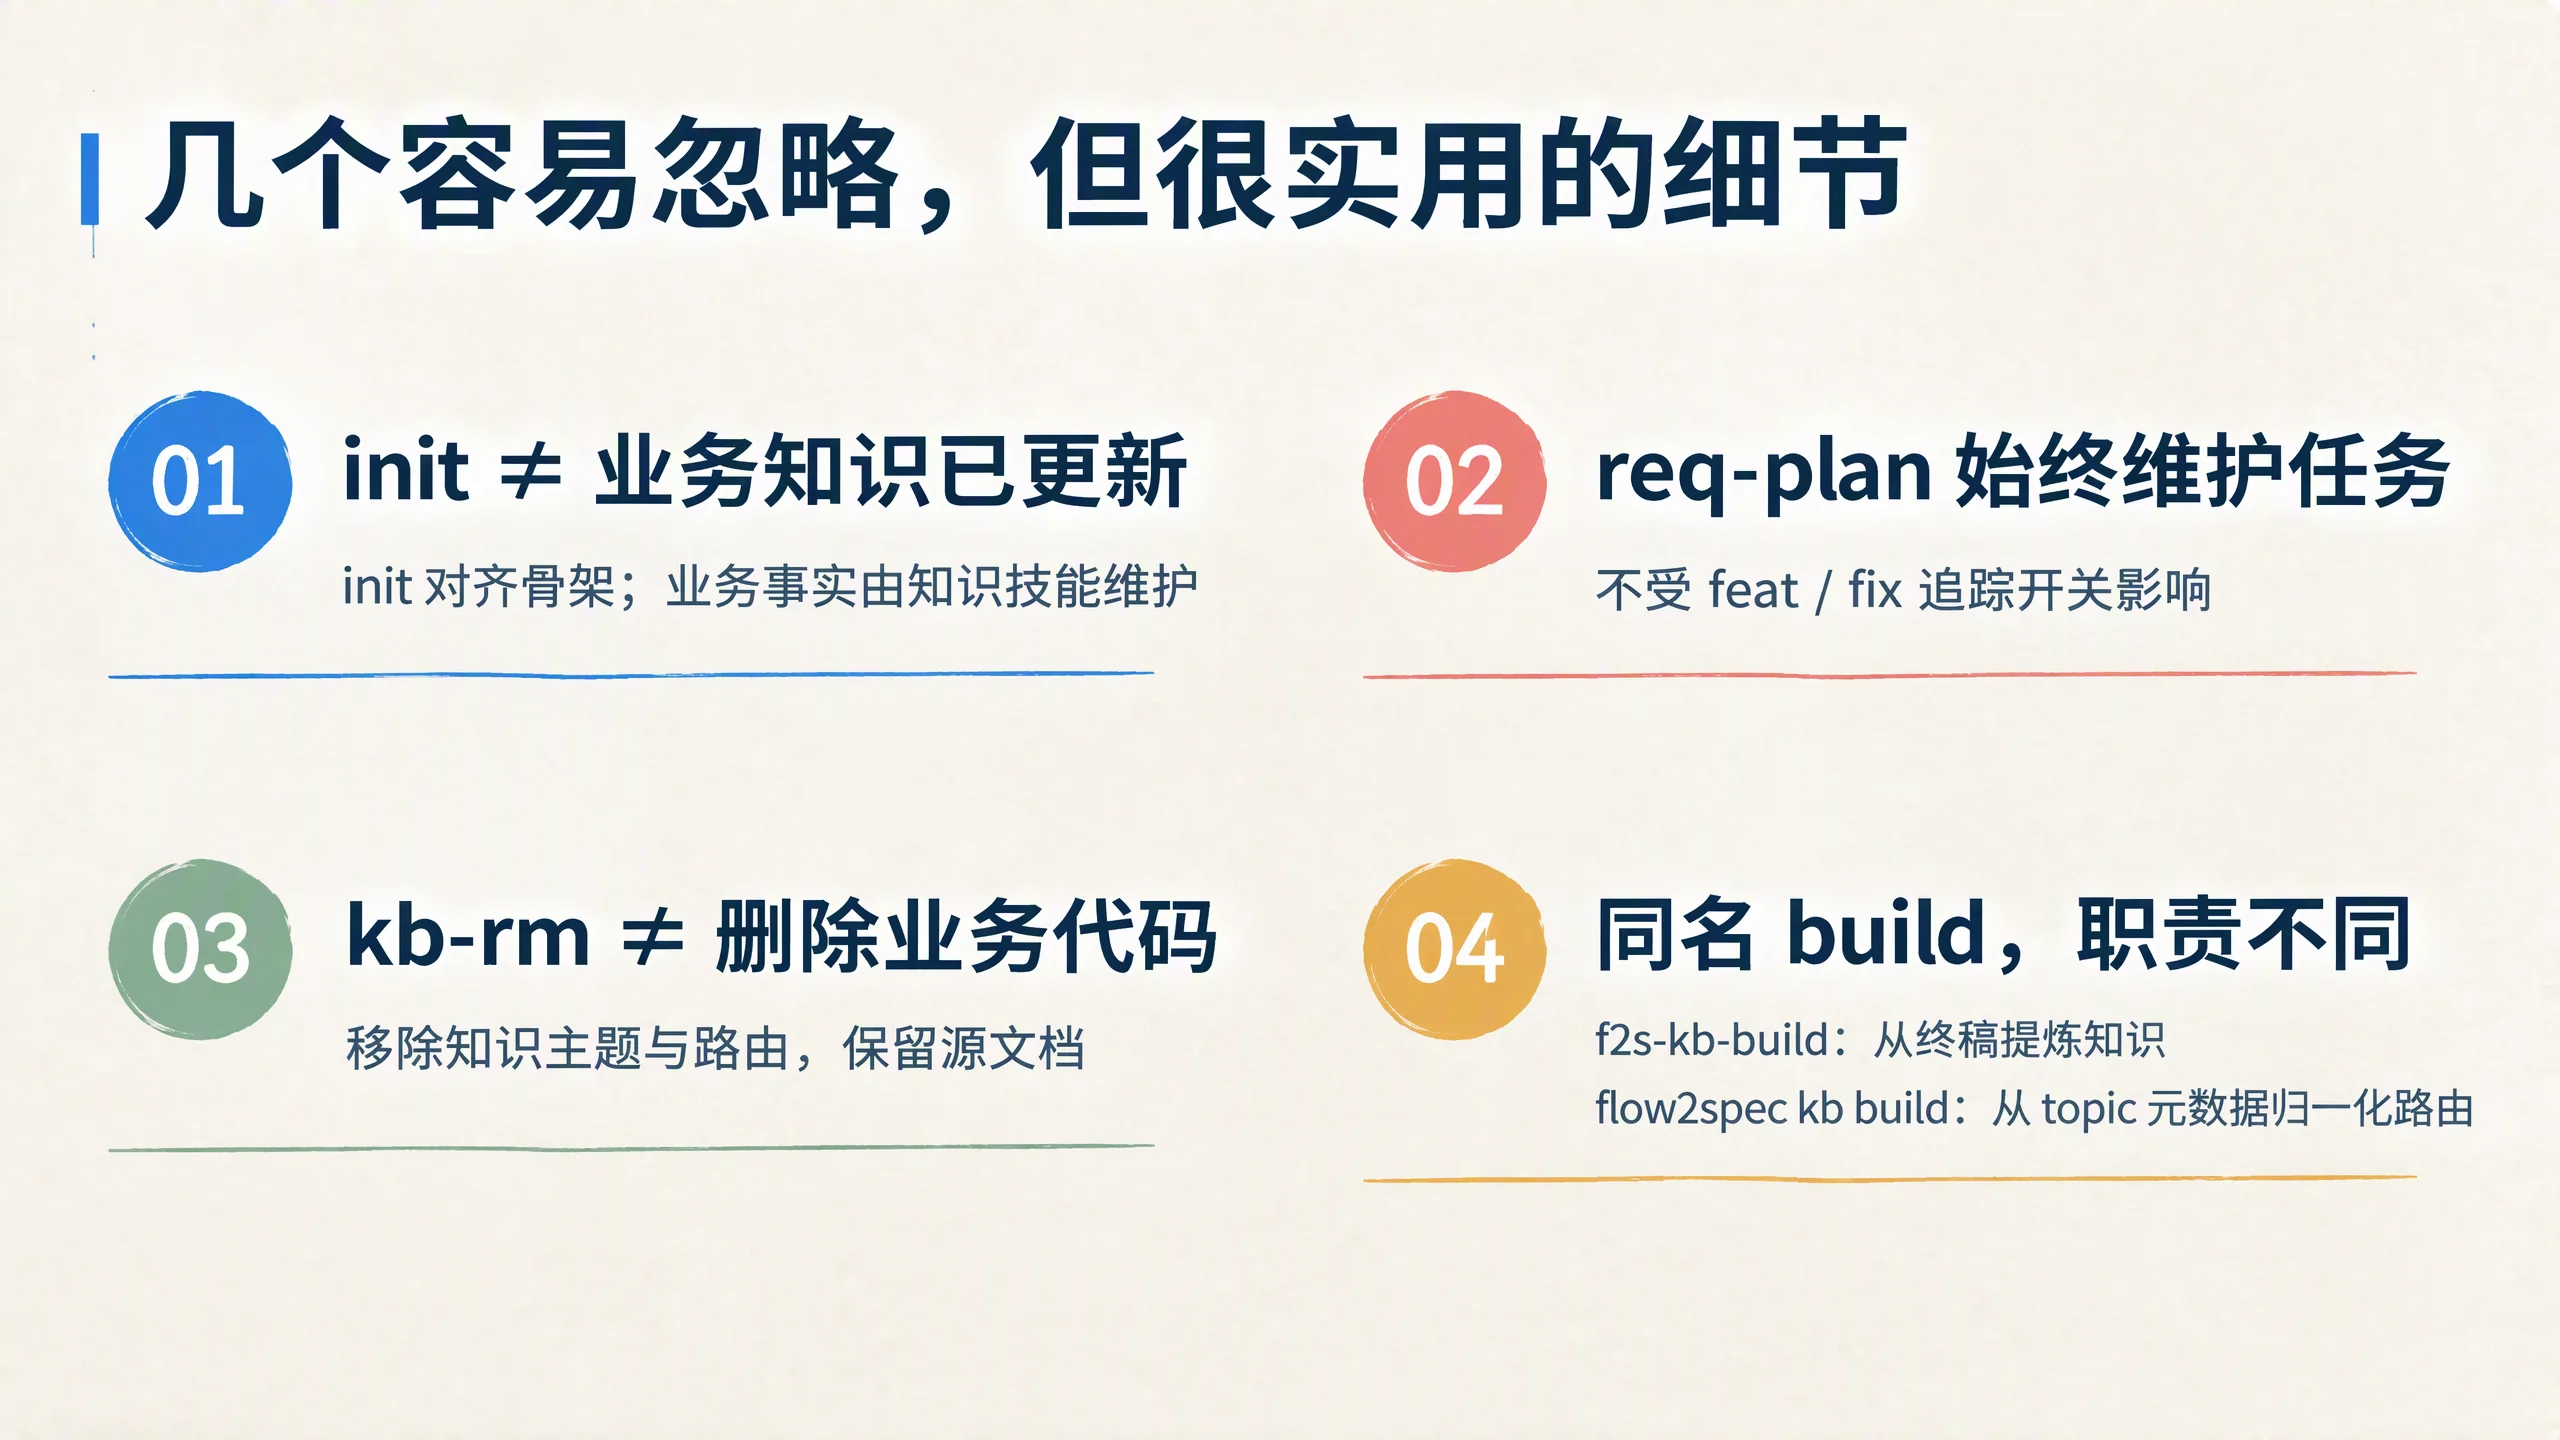
34 / 40 · 几个容易忽略,但很实用的细节
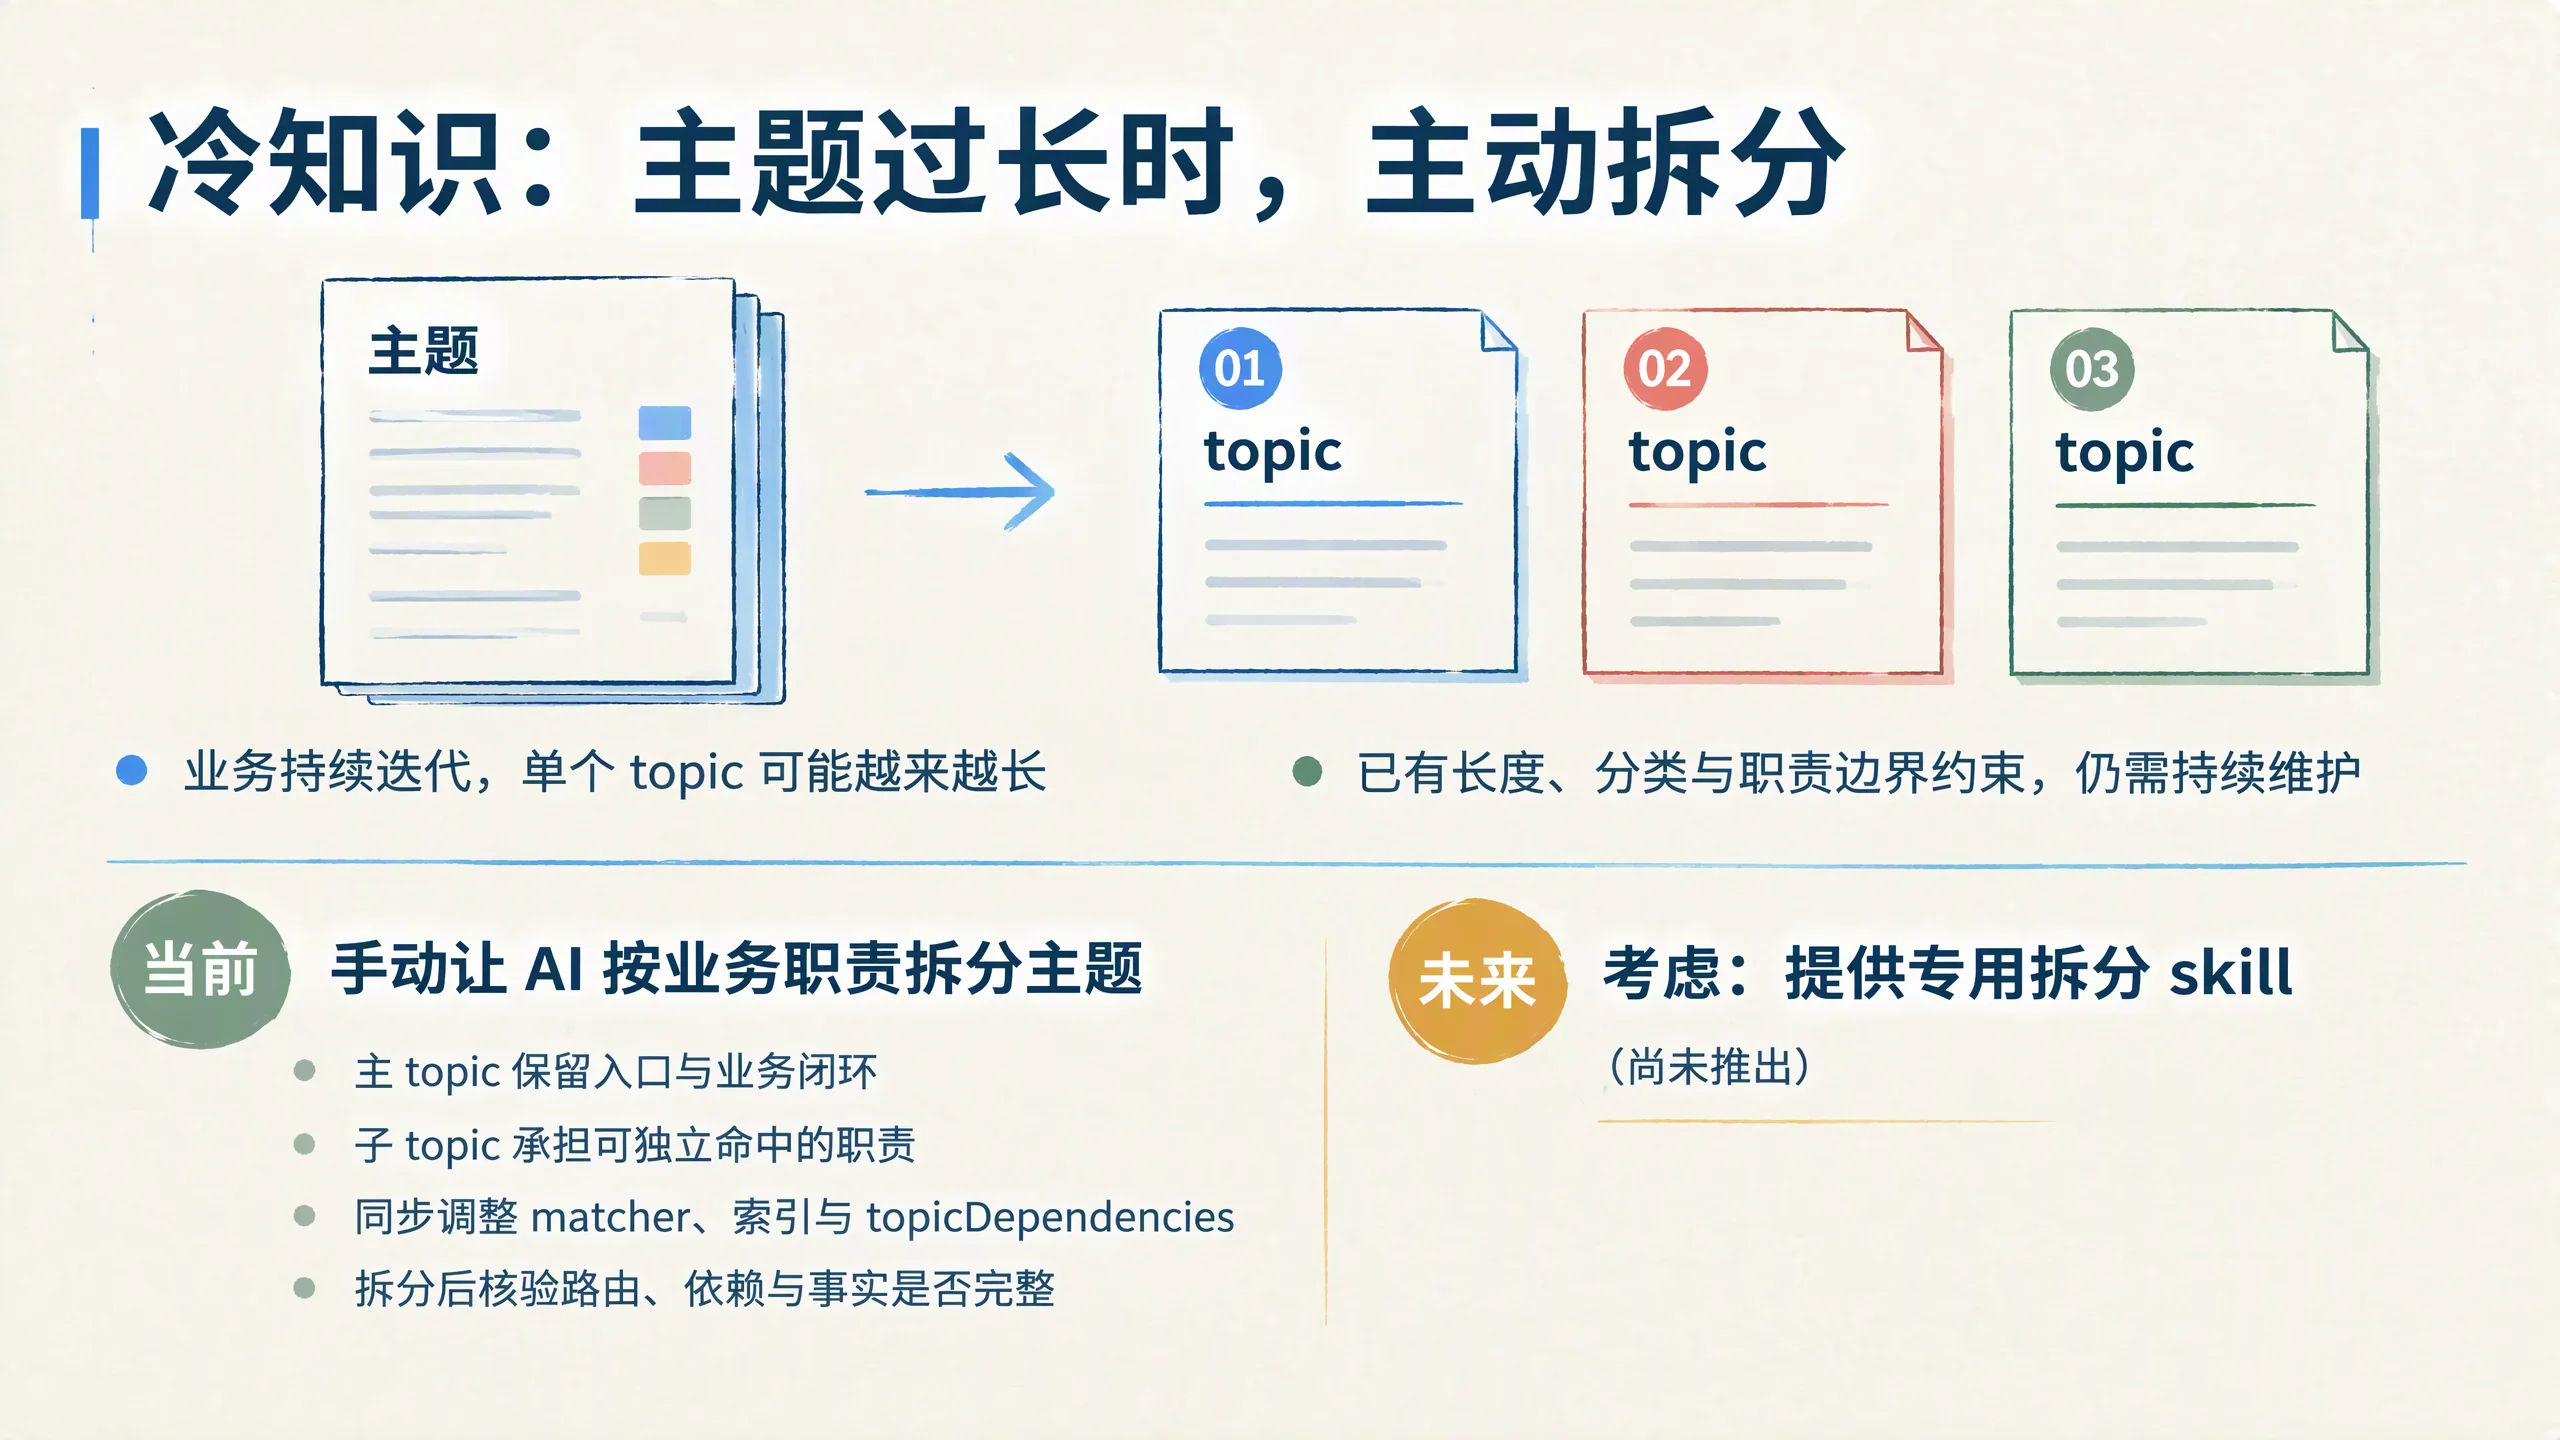
35 / 40 · 冷知识:主题过长时,主动拆分
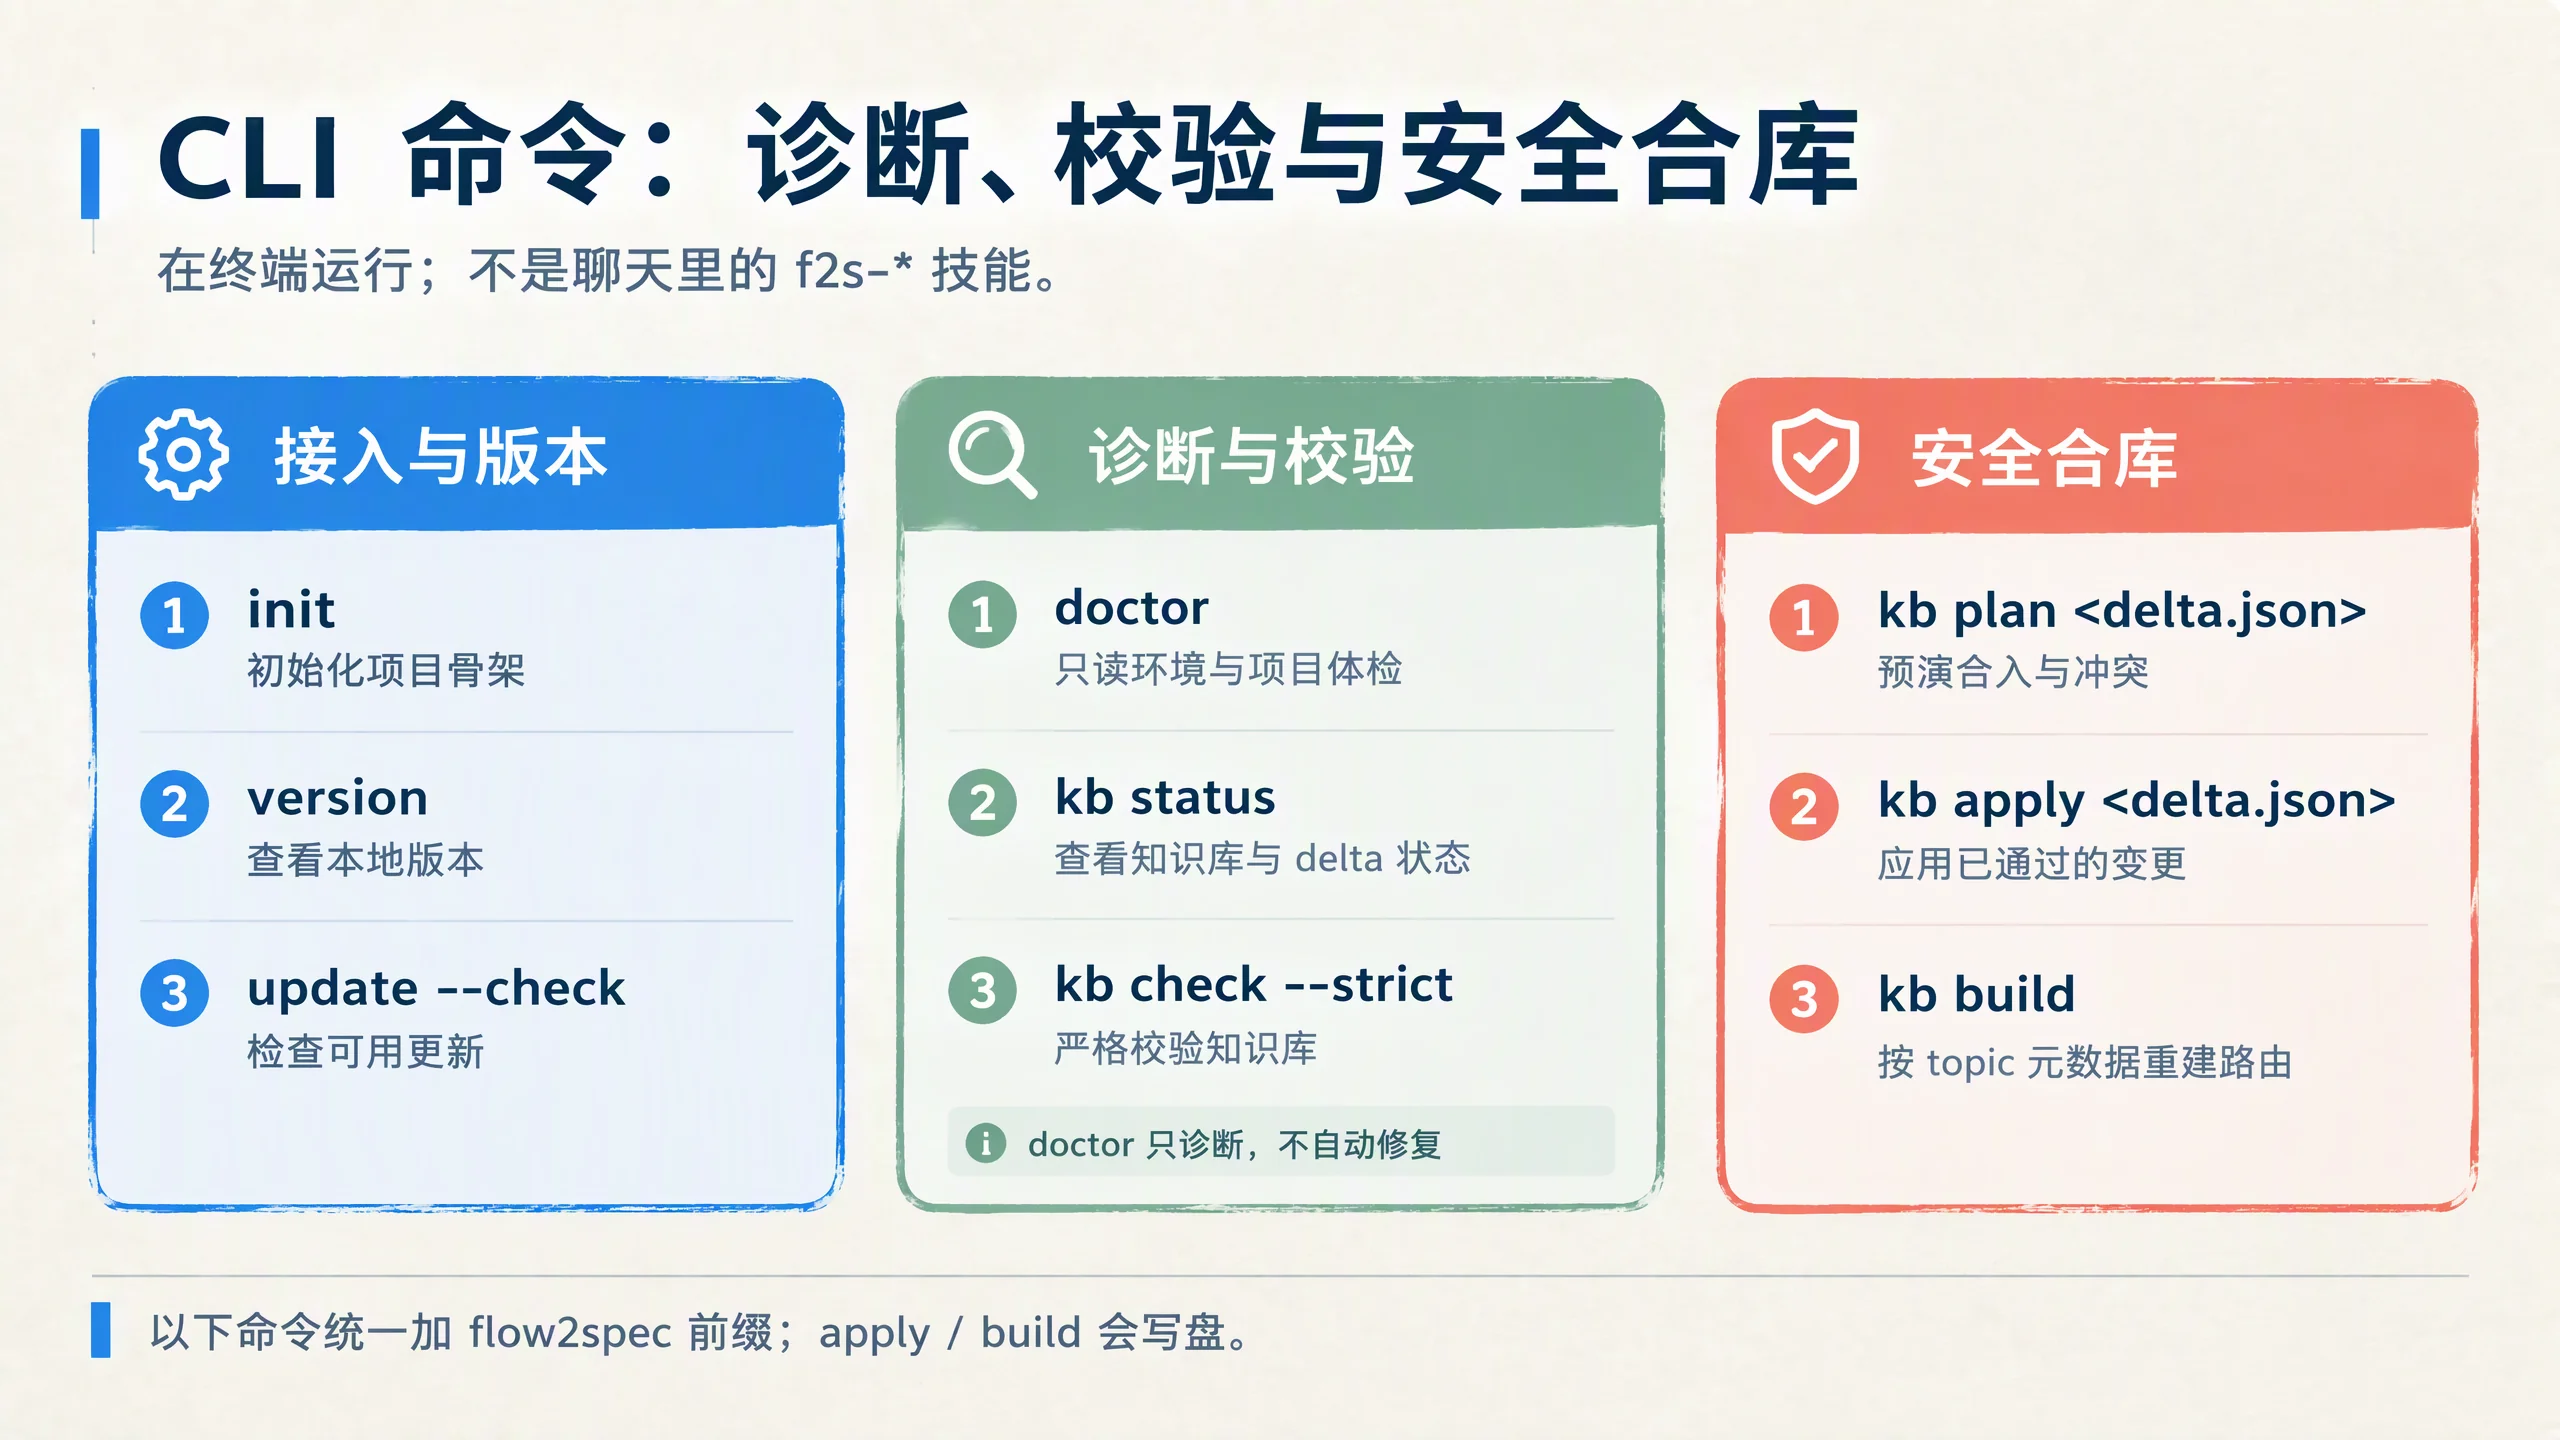
36 / 40 · CLI 命令:诊断、校验与安全合库
37 / 40 · 后期迭代计划
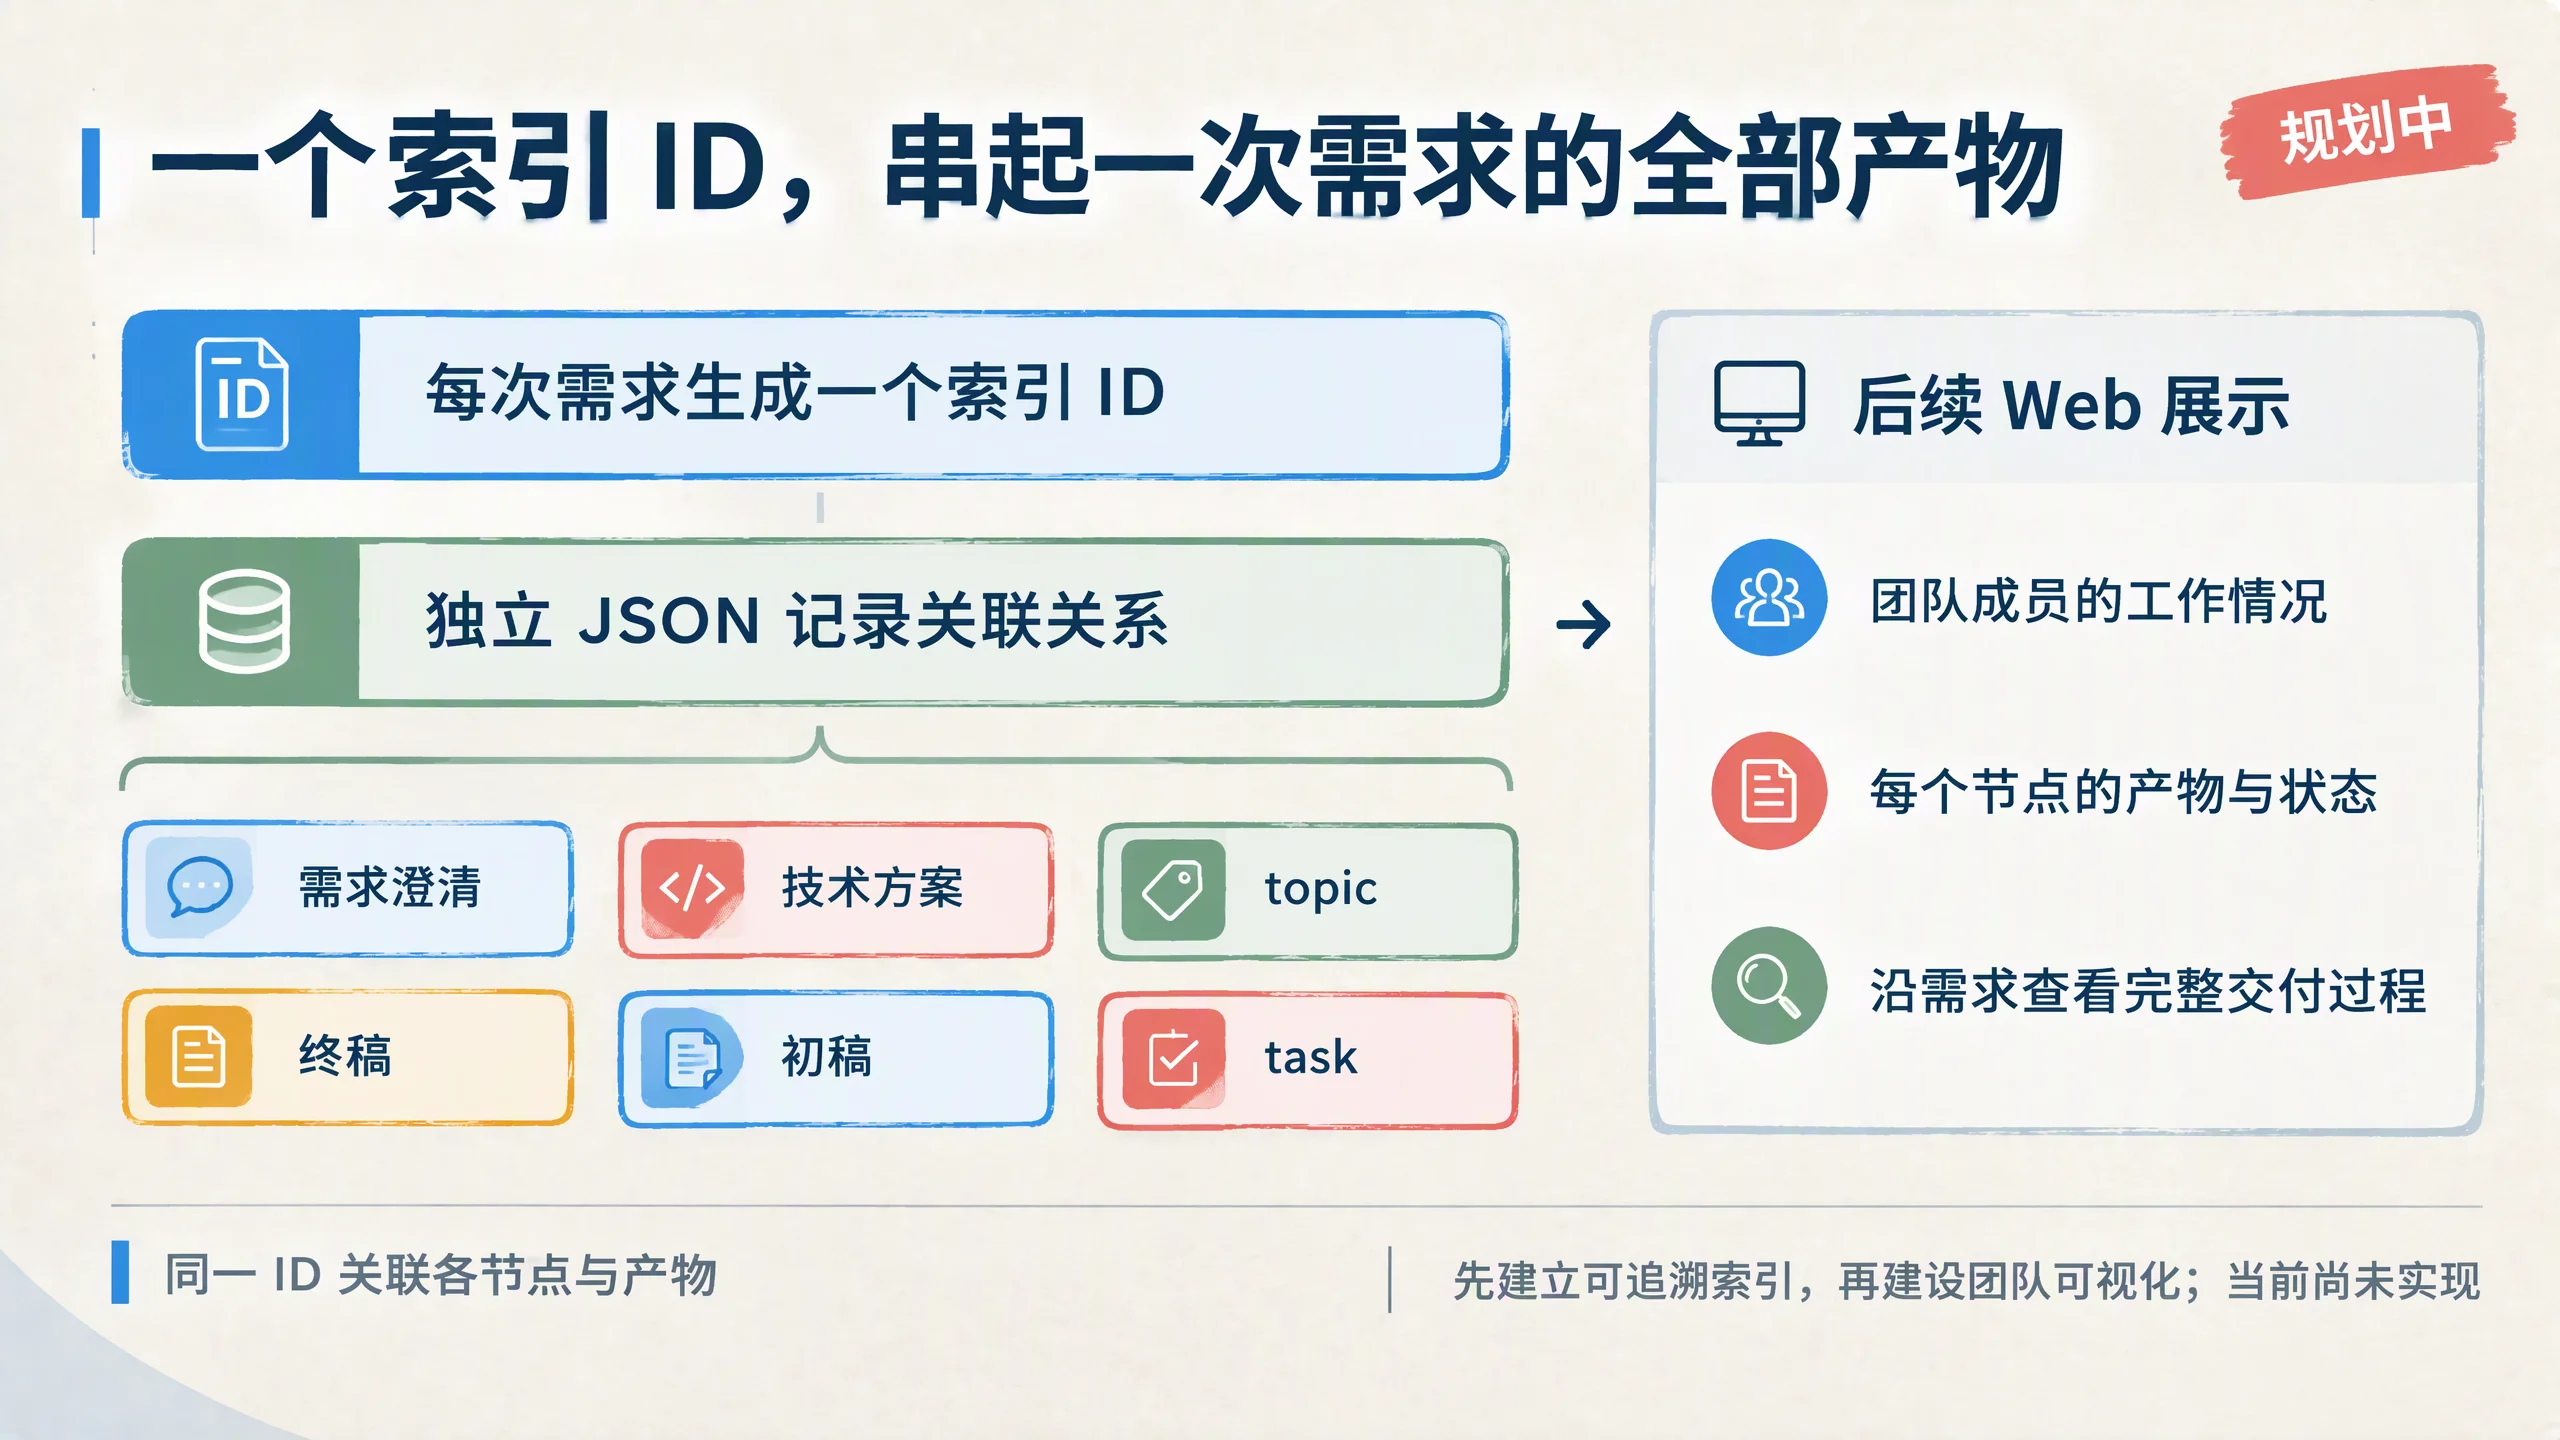
38 / 40 · 一个索引 ID,串起一次需求的全部产物
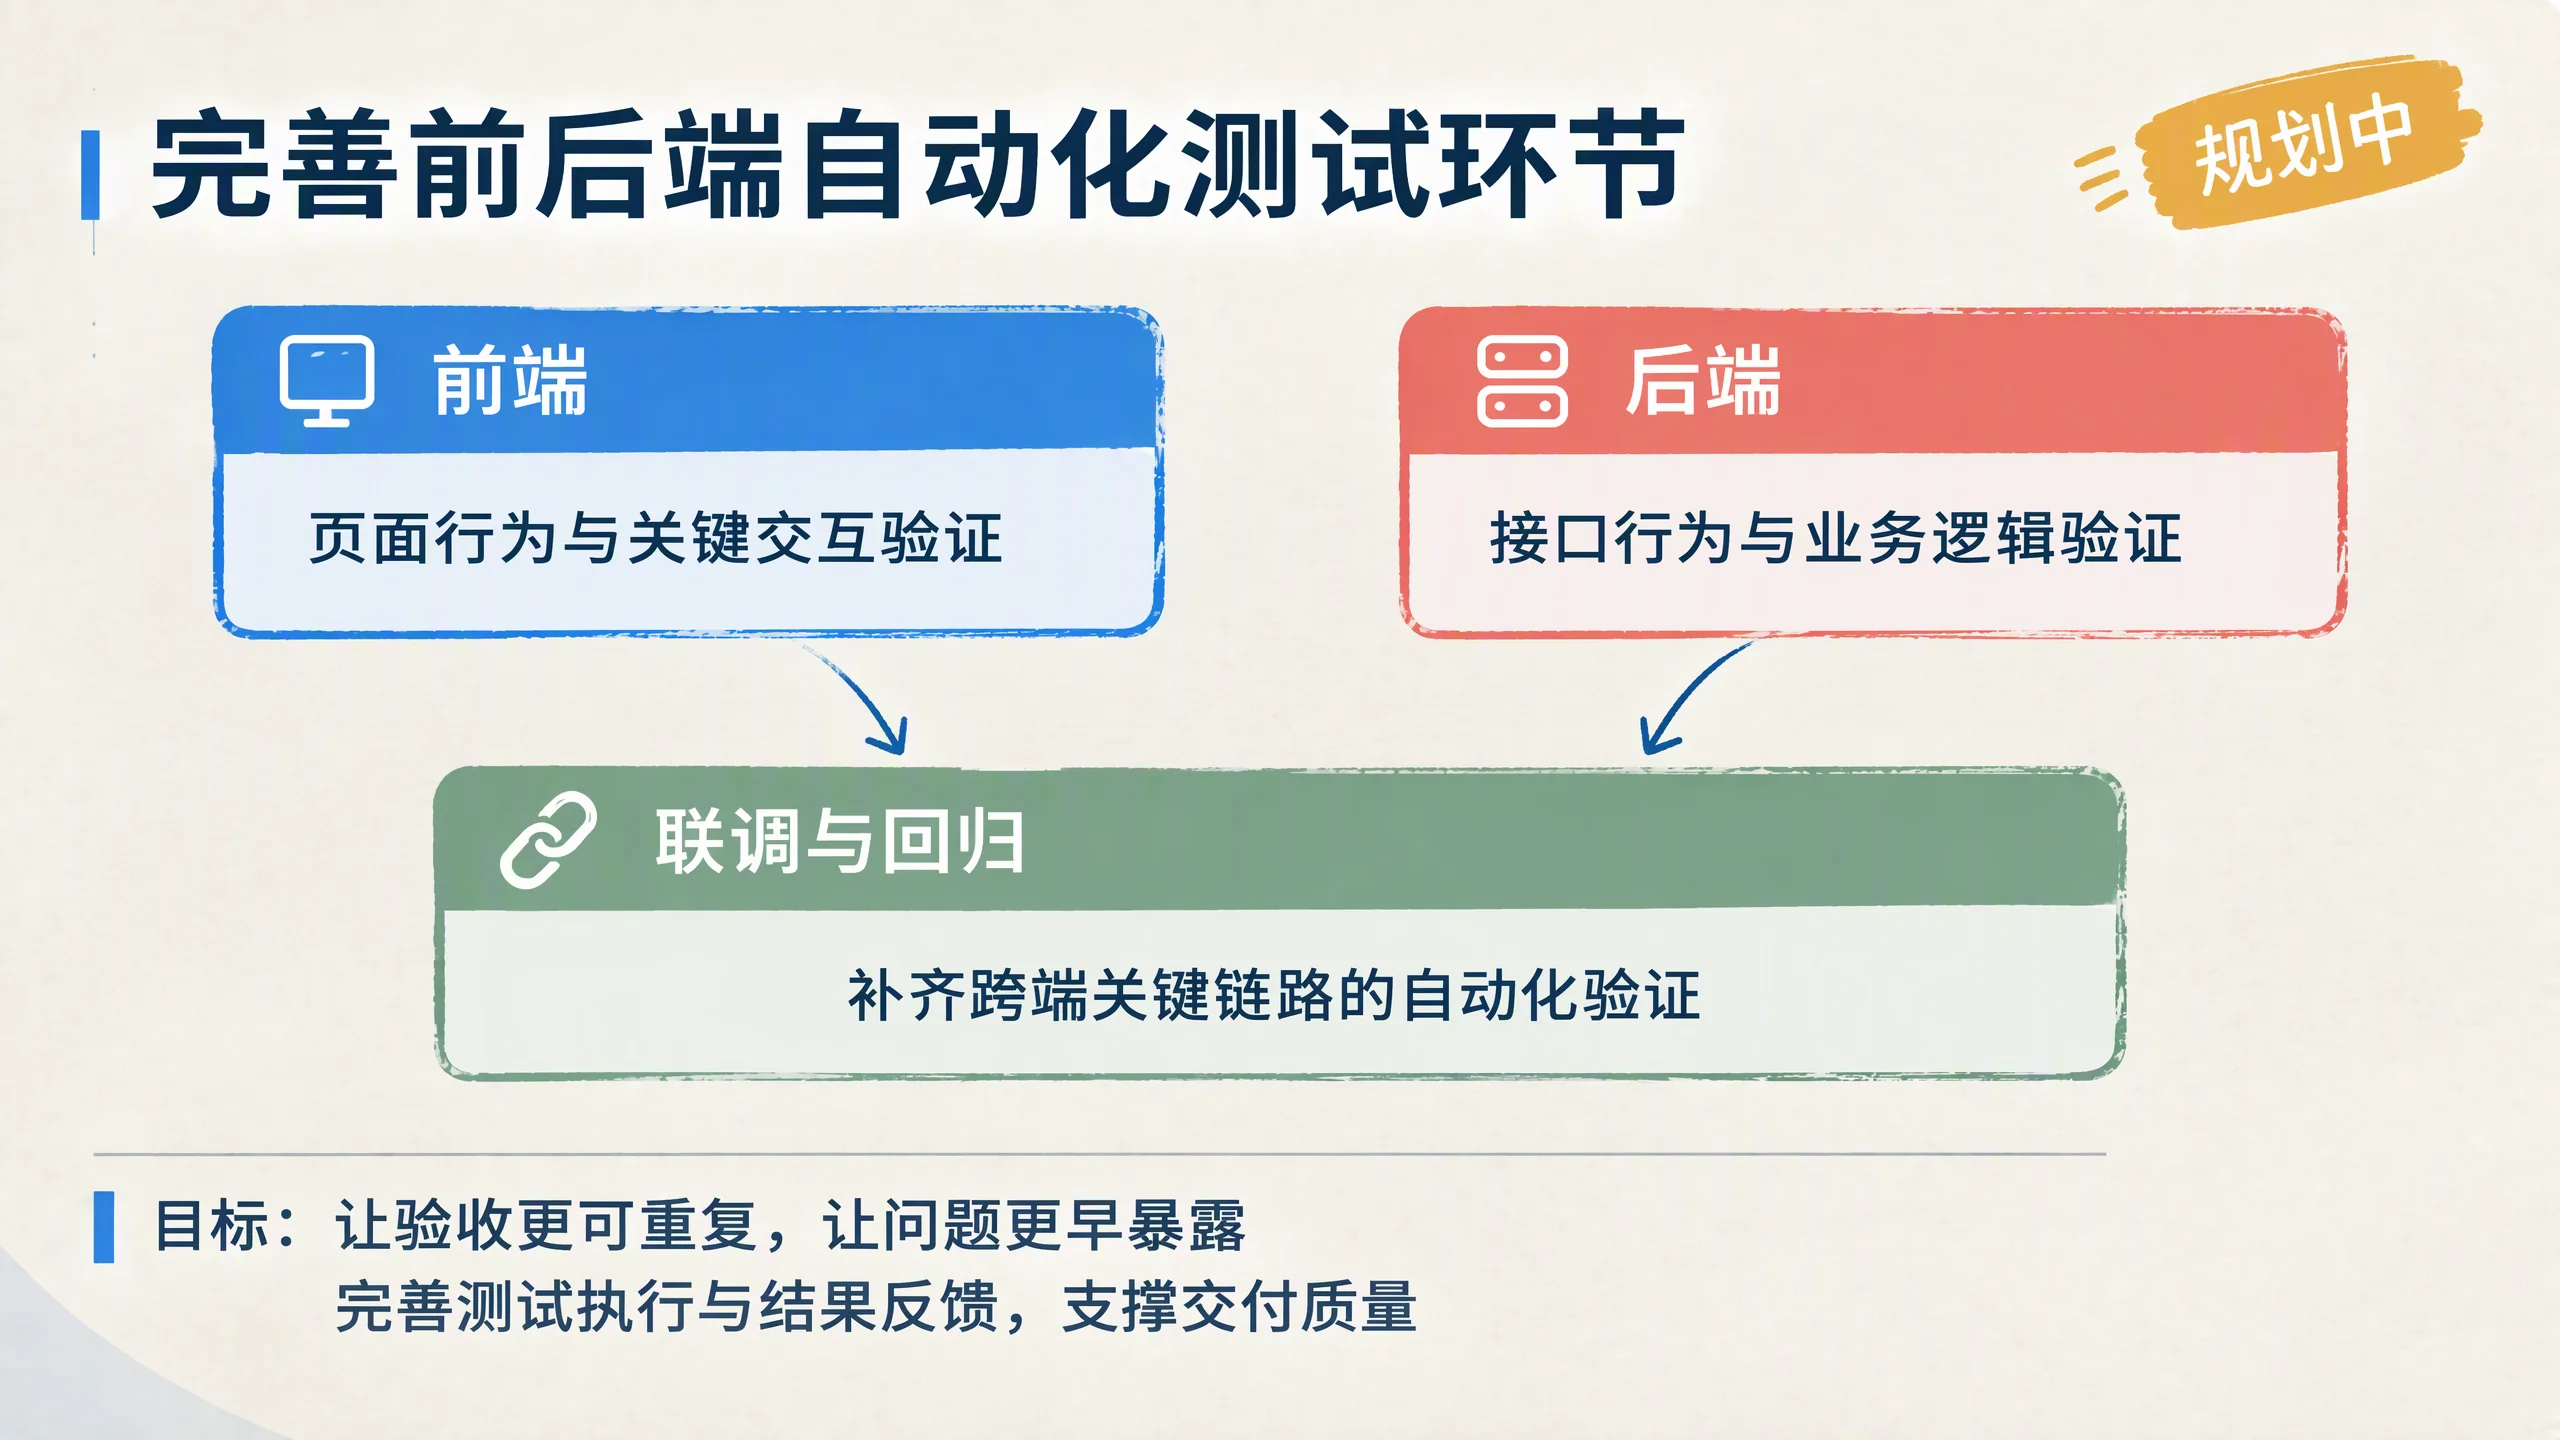
39 / 40 · 完善前后端自动化测试环节
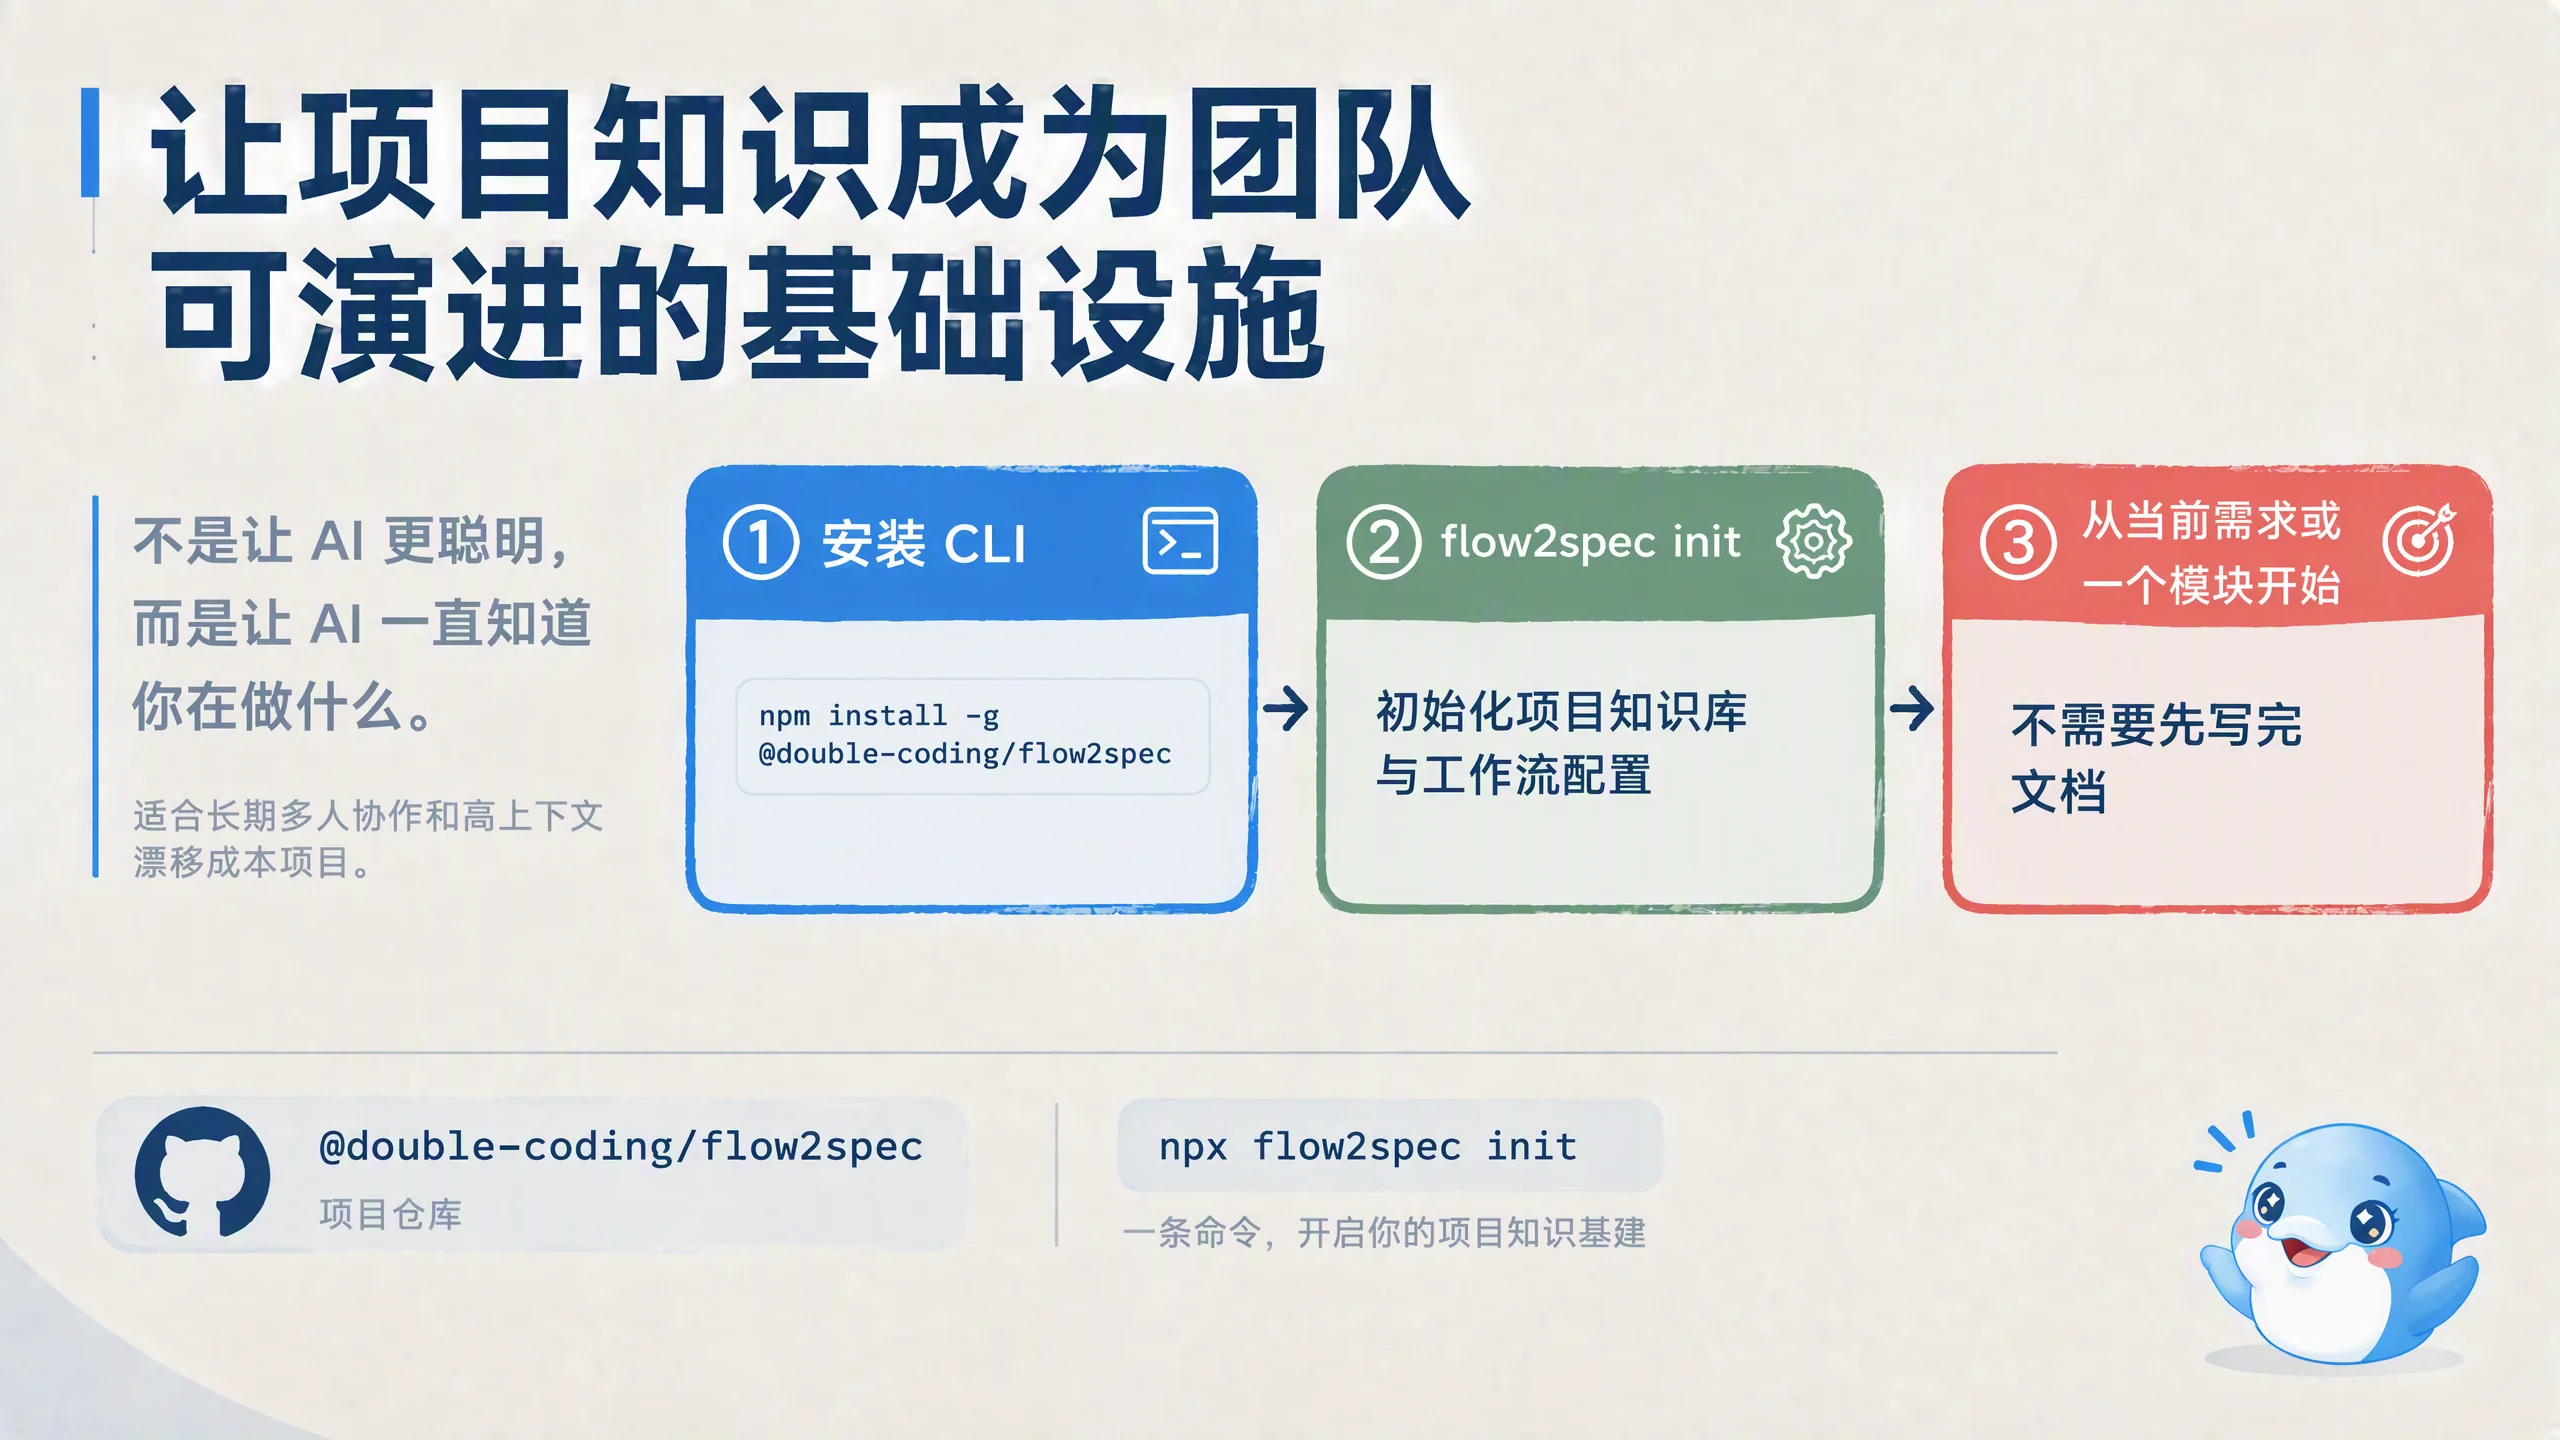
40 / 40 · 让项目知识成为团队可演进的基础设施
→
章节
01 为什么需要
02 体系原理
03 如何接入和初始化
04 五类日常使用场景
05 使用效果与效率提升
06 团队协作
07 其他
08 后期迭代计划
备注
全屏
关闭
请开启 JavaScript 以翻页;也可直接查看
幻灯片图片
。